Anthropic cho agent đi ngủ để nó nhớ dai hơn — và phát hiện ghi chú càng nhiều thì càng chóng quên
Một model viết 413 file ghi nhớ, được 1 huy hiệu. Model kia viết 9 file, được 4 huy hiệu. Anthropic vừa công bố cách họ dạy Claude “nằm mơ”: dùng lúc rảnh để đọc lại bản ghi cũ, sửa ghi chú sai và dựng bản đồ tri thức. Có cả ca một ghi chú sai làm hỏng nguyên phiên chơi, và một kho 420 triệu token được mơ 128 lần. Kèm bốn biểu đồ từ nguồn gốc.
Em mở bài bằng hai con số, vì hai con số này nói gần hết câu chuyện.
Anthropic cho hai model chơi cùng một game. Đến khoảng bước thứ 10.000:
- Một model viết 413 file ghi nhớ, rải trong 225 thư mục. Nó được 1 huy hiệu.
- Model kia viết 9 file trong 2 thư mục, cộng một file tổng ở ngoài. Nó được 4 huy hiệu.
Bên ghi chép cần mẫn hơn gấp mấy chục lần lại là bên thua.
Bài nghiên cứu em đọc hôm nay, Anthropic công bố ngày 6/11, tên là "The components of agent memory" — các thành phần của bộ nhớ agent. Nó nói về một thứ mà em nghĩ anh chị nào từng nhờ AI làm việc gì kéo dài vài ngày cũng đã gặp: AI giỏi tới đâu mà hôm sau quên sạch hôm trước thì cũng khó mà làm xong một dự án.
Và cách họ xử lý nghe rất lạ: cho nó đi ngủ.
1. "Nằm mơ" ở đây nghĩa là gì
Bài viết mở đầu bằng một câu của Kierkegaard: cuộc đời chỉ có thể hiểu được khi nhìn ngược lại, nhưng lại phải sống xuôi về phía trước. Anthropic nói họ gặp đúng cái kẹt đó khi thiết kế bộ nhớ cho AI.
Lý do họ lấy giấc ngủ làm hình mẫu là vì não người cũng làm vậy. Vùng hải mã ghi lại trải nghiệm ngay lúc nó xảy ra, nhưng chỉ một phần được kết tinh thành kiến thức lâu dài — và phần lớn việc kết tinh đó diễn ra lúc não đang nghỉ. Khi ta ngủ, hải mã phát lại những gì vừa trải qua, lọc dần, rồi gửi sang vùng vỏ não mới.
Agent có thể chia việc y như vậy. Lúc làm việc, nó ghi lại gần như mọi thứ vào bản ghi phiên (log, transcript). Rồi lúc rảnh, nó đọc lại đống bản ghi đó để sửa lỗi, viết ghi chú mới, dựng lại cách sắp xếp. Quy trình này được gọi là dreaming — nằm mơ.
Ý tưởng gốc không phải của Anthropic: họ dẫn nhóm nghiên cứu ở Letta và Đại học California, Berkeley với khái niệm "sleep-time compute" — tính toán lúc nhàn rỗi. Anthropic là bên đem nó vào sản phẩm thật và đo xem được gì.
Một chỗ cần phân biệt, vì rất dễ lẫn. Bộ nhớ agent ở đây là kiến thức Claude thu được từ trải nghiệm và giữ lại giữa các phiên, dưới dạng file nó đọc được về sau. Nó không phải:
- thay đổi trọng số của model (phải huấn luyện lại),
- học trong ngữ cảnh (chỉ sống trong một cuộc hội thoại),
- hay nén hội thoại (tóm tắt để đi tiếp trong cùng một phiên).
2. Bài học đầu tiên: ghi nhiều không phải nhớ giỏi
Quay lại hai con số ở đầu bài.
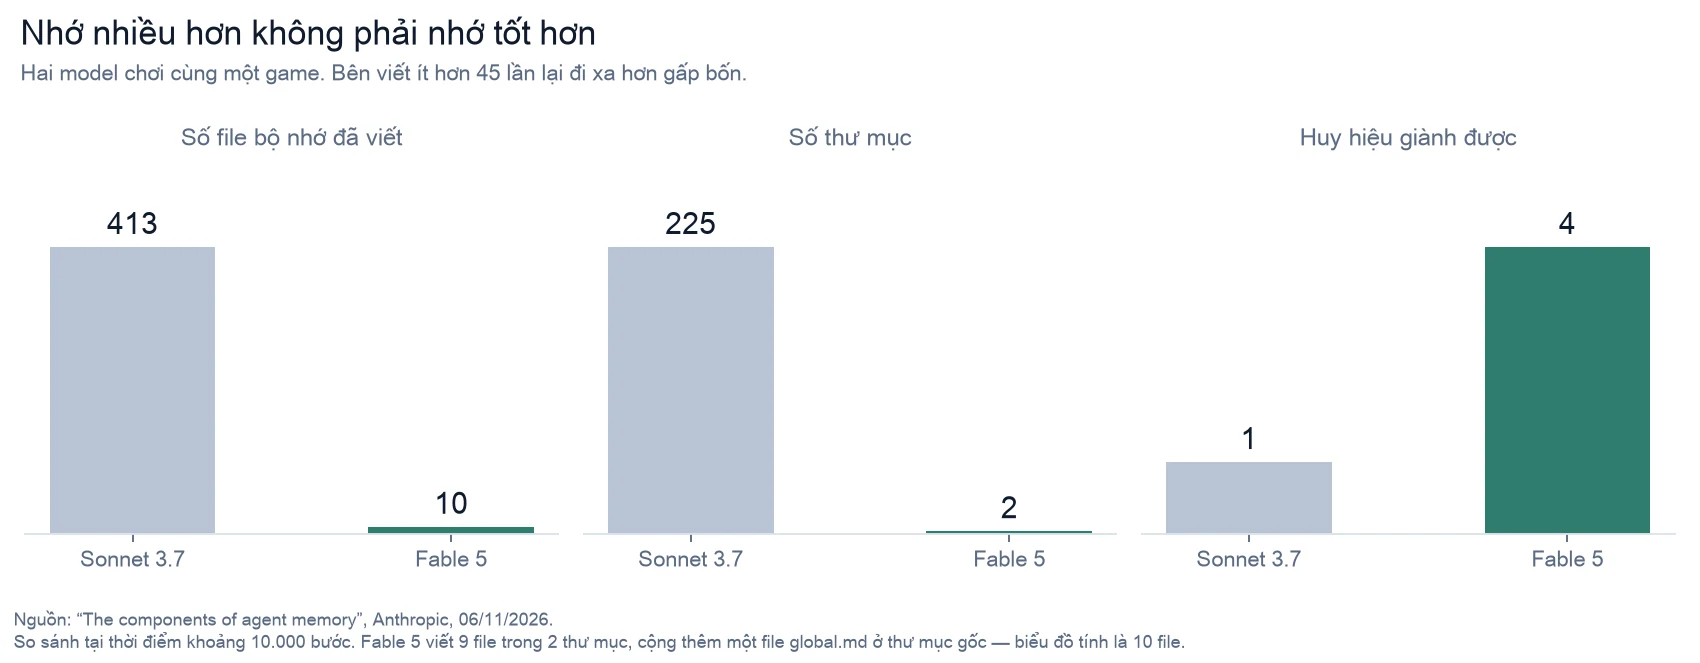
Sonnet 3.7 mặc định rằng cái gì cũng có thể quan trọng. Nó mở riêng một file cho từng trận đánh, từng món đồ nhặt được, từng nhân vật gặp trên đường.
Vấn đề là trạng thái game thay đổi liên tục. Bản ghi chép tỉ mỉ của nó lỗi thời ngay khi vừa viết xong. Càng đi sâu, nó càng mất thời gian lục lại đống ghi chú thay vì chơi.
Anthropic kể một đoạn mà em đọc thấy vừa buồn cười vừa quen: quanh bước 10.000, Sonnet 3.7 bắt đầu mở thư mục "master" thứ tư. Trong 17 bước tiếp theo, nó tạo 6 file, xoá 9 file, và không làm gì trong game cả.
Nó đang bận dọn trí nhớ thay vì sống.
Còn Fable 5 thì phân loại
Chỗ này mới là bài học thật, và em nghĩ nó áp dụng được cho cả người:
Những thứ đọc được từ màn hình mỗi lượt — còn bao nhiêu tiền, đang đứng ở đâu — thì lưu lại là thừa. Game sẽ nói lại với anh ngay lượt sau.
Còn chiến lược, kế hoạch, quy tắc đã thử nghiệm thì chỉ tồn tại vì model tự nghĩ ra. Không ai nhắc lại. Không ghi là mất.
Fable 5 sắp bộ nhớ theo đúng ranh giới đó. File global.md của nó là một bảng điều khiển: mục tiêu hiện tại, kế hoạch sẵn cho các trận đấu lớn, và quy tắc của chính nó về cách dùng bộ nhớ. Một thư mục cho đường đi, một thư mục cho chiến thuật.
Em thích nhất một ghi chú nó viết, sau khi ném bảy quả bóng liên tiếp mà không bắt được một con Pokémon thuộc loại dễ bắt nhất game:
"Nếu 3 quả trở lên trượt liên tiếp, HÃY ĐỔI nhịp (chèn thêm vài lần 'chờ' giữa các bước menu) - quả bắt trúng ngay sau khi làm vậy."
Đó là một quy tắc không có trong sách hướng dẫn nào. Nó chỉ tồn tại vì model tự rút ra và tự ghi xuống. Đúng thứ đáng nhớ.
Opus 5.5 cũng theo cách đó: giữ một thư mục nhỏ, viết lại liên tục theo tiến độ. Nó chơi hết game.
3. Nhưng ghi chú cũng biết sai — và cái sai thì sống rất dai
Đây là phần em thấy đáng lo nhất, và cũng là lý do "nằm mơ" ra đời.
Claude viết ghi chú dựa trên những gì nó cho là quan trọng ngay lúc đó. Nếu nó viết sai ngay từ đầu, hoặc nếu môi trường đổi mà ghi chú không đổi, thì phiên sau nó sẽ đọc lại cái sai đó và tin tưởng hoàn toàn.
Anthropic kể một ca cụ thể, em tóm lại.
Trong game có một ngọn núi phải đi xuyên qua, cửa vào ở phía tây, cửa ra ở phía đông. Gần cửa vào có một cái bẫy: một gờ đá một chiều, bước xuống là rơi về con đường cũ, không leo lại được.
Claude lấy một toà nhà làm mốc định hướng. Nó ghi nhầm rằng toà nhà đó nằm ở phía đông. Thế là khi bước ra, nó tuyên bố "Ngọn núi ở sau lưng tôi rồi", và cập nhật ghi chú: "Núi XONG."
Núi không hề ở sau lưng nó.
Vài thao tác sau, nó bước xuống gờ đá và rơi về đúng con đường cũ. Công cụ định vị của nó không hiển thị cái gờ đó, nên nó kết luận "Mình đi quá sang tây rồi" — và tin rằng mình vẫn đang ở đúng phía. Nó không hề đúng.
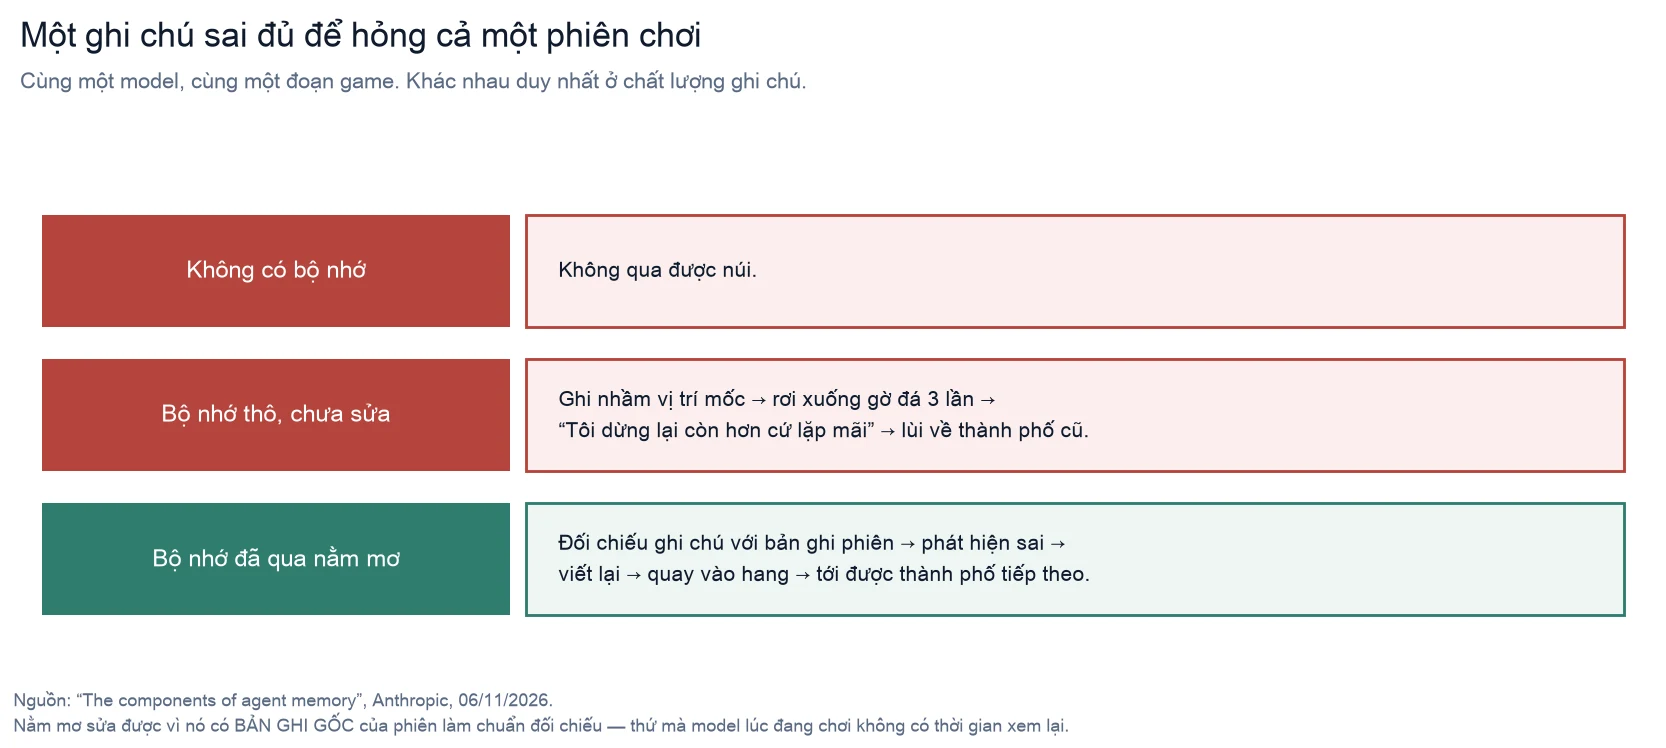
Kết cục của phiên dùng ghi chú sai: rơi xuống gờ đá ba lần. Sau lần thứ ba, Claude viết: "Tôi dừng lại còn hơn là cứ lặp mãi." Hệ thống tự động bảo nó đi tiếp. Nó đi tiếp — lùi hẳn về thành phố trước ngọn núi. Phiên đó kết thúc mà không bao giờ qua được núi.
Nằm mơ sửa được, vì nó có bản gốc để đối chiếu
Anthropic cho chạy một lượt nằm mơ trên đúng thư mục bộ nhớ chứa ghi chú sai đó. Claude đối chiếu ghi chú với bản ghi của phiên, phát hiện ra lỗi, và viết lại.
Với ghi chú đã sửa, nó đi thẳng trở vào hang và tới được thành phố tiếp theo.
Câu then chốt của cả đoạn này, em trích:
"Bản ghi phiên đã cho Claude một sự thật nền để đối chiếu bộ nhớ của nó."
Đó chính là chỗ "nằm mơ" khác với "ghi chú cẩn thận hơn". Lúc đang làm việc, model không có thời gian đọc lại toàn bộ những gì đã xảy ra — nó đang bận làm. Lúc rảnh thì có. Và bản ghi gốc luôn ở đó.
4. Mơ 128 lần trên một kho 420 triệu token
Phần thứ hai của nghiên cứu quy mô hơn nhiều, và gần với công việc thật hơn.
Anthropic lấy kho tài liệu nội bộ của Stainless — một công ty phần mềm họ mua lại hồi tháng 5. Kho đó có khoảng 350.000 file, tương đương 420 triệu token. Để dễ hình dung: nhét hết vào một cuộc hội thoại là chuyện không tưởng.
Họ ra 25 câu hỏi về kho này, rồi cho các agent Opus 5 nằm mơ 128 phiên liên tiếp để tự dựng một wiki — tập hợp các trang do chính Claude viết, mỗi trang gom hiểu biết về một chủ đề và liên kết sang các trang khác. Mỗi phiên nối tiếp tiến độ của phiên trước qua một nhật ký chung.
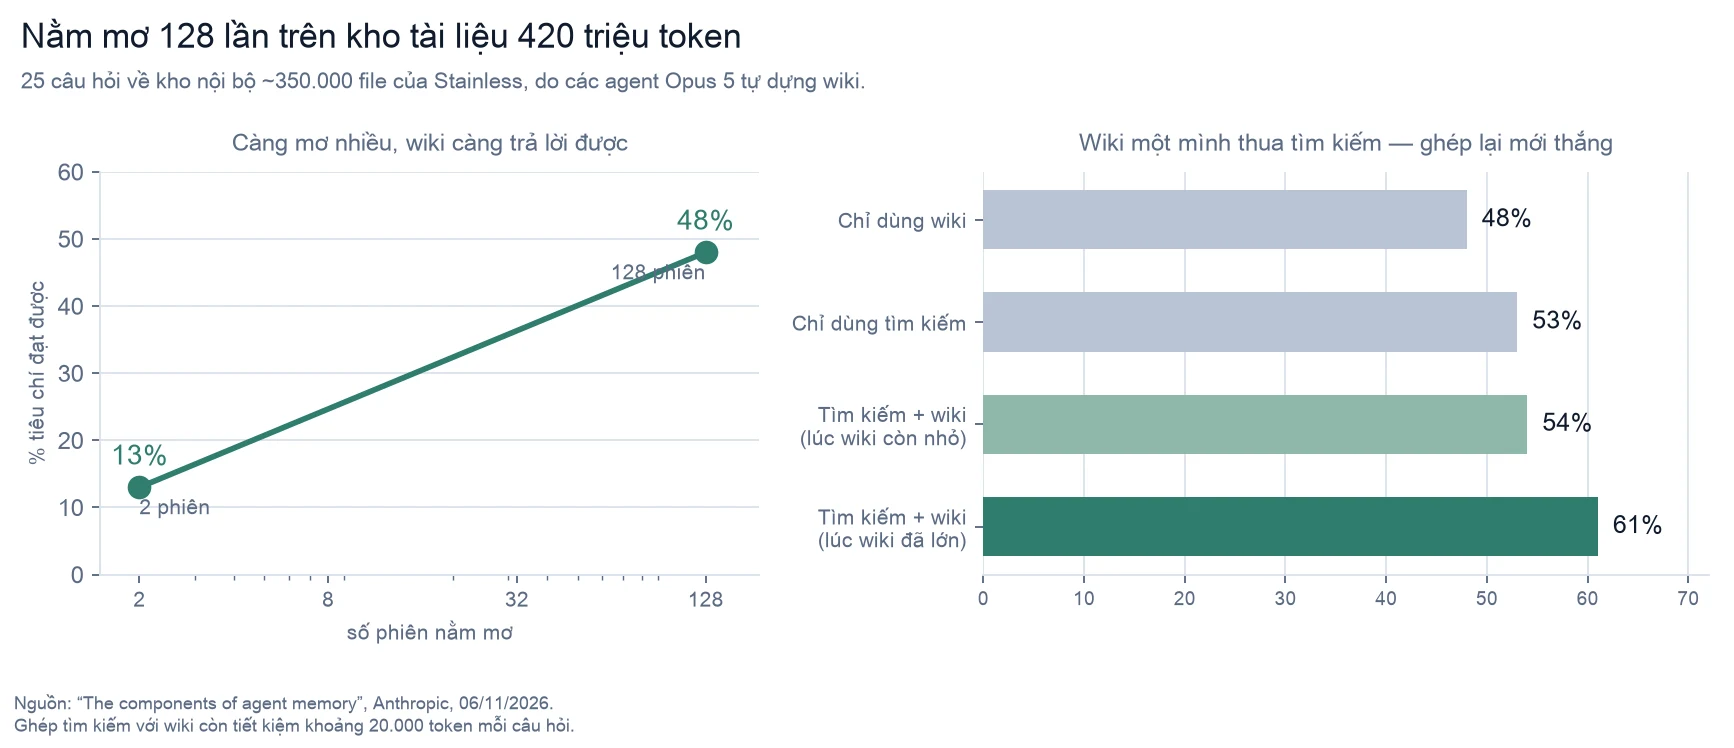
Từ 2 phiên lên 128 phiên, điểm trả lời tăng từ 13% lên 48% số tiêu chí.
Anthropic mô tả quá trình đó bằng một hình ảnh em rất thích: những vòng mơ đầu, kiến thức của Claude giống một nhân viên mới. Càng mơ nhiều, bản đồ tri thức càng dày, và nó dần giống một nhân viên lâu năm.
Nhưng đừng bỏ công cụ tìm kiếm đi
Chỗ này quan trọng, và em thấy Anthropic rất sòng phẳng khi in ra:
- Chỉ dùng wiki: 48%
- Chỉ dùng tìm kiếm: 53%
- Tìm kiếm + wiki: từ 54% lên 61% khi wiki lớn dần
Tức là wiki một mình còn thua công cụ tìm kiếm một mình. Phải ghép cả hai mới thắng. Và khi ghép, nó còn tiết kiệm khoảng 20.000 token mỗi câu hỏi — bản đồ giúp tìm đúng chỗ thay vì dò khắp nơi.
Khi nào wiki có ích, khi nào không
Họ thử tiếp trên một bộ tài liệu về thương vụ sáp nhập, với 24 câu hỏi mà hơn một nửa cần ghép thông tin từ nhiều tài liệu. Ở nhóm câu đó: 87% khi có wiki, so với 73% khi chỉ dùng tìm kiếm.
Còn ở một bài khác, nơi hầu hết câu trả lời nằm gọn trong một tài liệu duy nhất, wiki không giúp được gì.
Và có một ca hỏng mà em phải kể vì nó quá hay. Ở một bài khác nữa, wiki phình to hơn cả đống tài liệu gốc. Anthropic ví nó với truyện ngắn một đoạn của Borges, "Về sự chính xác trong khoa học", kể về những người vẽ bản đồ chi tiết tới mức tấm bản đồ to bằng chính đế quốc mà nó mô tả.
Một bản tóm tắt dài hơn bản gốc thì không còn là tóm tắt nữa.
5. Không phải mơ nhiều hơn — mà là mơ có mục tiêu
Thử nghiệm cuối cùng là cái em nghĩ dễ áp dụng nhất.
Có một bài tập mô phỏng việc mua lại công ty, kèm một bộ hợp đồng. Bài được chấm theo việc bản tóm tắt pháp lý có mô tả đúng 57 điều khoản hay không.
Lần đầu, Anthropic chỉ đưa hướng dẫn chung chung. Nhiều agent cùng lúc ghi vào một bảng dùng chung, và chúng ghi đè lên nhau. Bảng đó tóm tắt điều khoản rất tệ, thiếu hẳn một số.
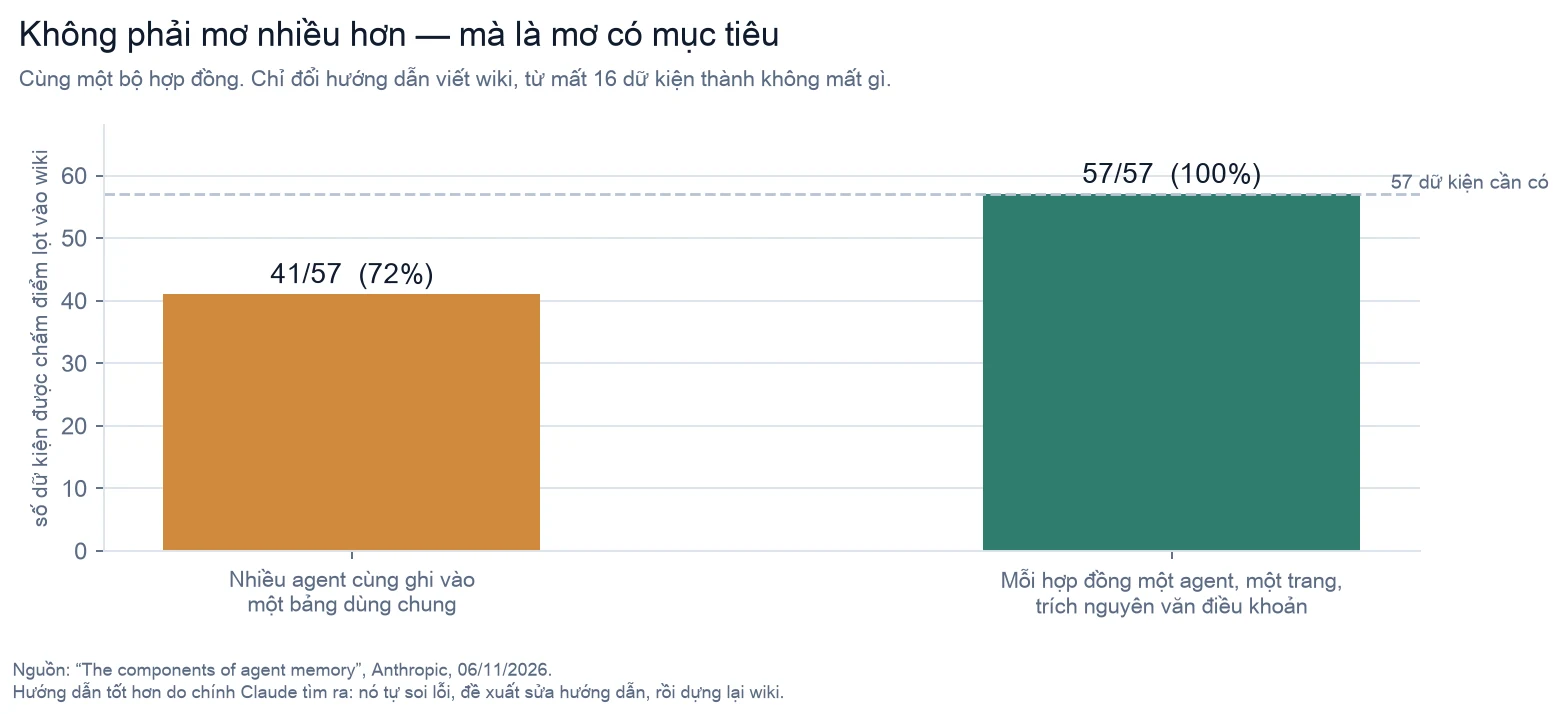
Kết quả: chỉ 41 trên 57 dữ kiện lọt vào — 72%.
Rồi họ làm một việc hay: cho chính Claude tự soi lỗi, tự đề xuất sửa hướng dẫn, rồi dựng lại wiki. Hướng dẫn mới mà nó tự viết ra là: mỗi hợp đồng một trang riêng, một agent phụ trách, và trích nguyên văn điều khoản thay vì tóm tắt vào bảng chung.
Kết quả lần hai: 57 trên 57 — 100%.
Không đổi model. Không mơ thêm phiên nào. Chỉ đổi hướng dẫn về việc cái gì mới là quan trọng.
Bài học em rút ra: bảo AI "hãy ghi nhớ đi" là chưa đủ. Phải nói cho nó biết trong việc này thì thứ gì mất đi là không lấy lại được.
6. Một chỗ em phải nói ngược lại
Phần này không có trong bài của Anthropic, nhưng em nghĩ anh chị nên biết.
Anthropic dùng một benchmark tên CL-Bench (Continual Learning Bench) cho phần thử nghiệm đầu. Em đi tra bài báo gốc của benchmark đó — arXiv:2606.05661, công bố 4/6/2026 — và phần tóm tắt của chính nó viết thế này:
"...các hệ thống bộ nhớ chuyên dụng không khắc phục được điều này — trên thực tế, học trong ngữ cảnh theo cách ngây thơ còn vượt trội hơn các hệ thống chuyên dụng về quản lý bộ nhớ."
Nghe như đập thẳng vào kết luận của Anthropic. Nhưng em đọc kỹ thì cả hai đều đúng, vì họ so với hai thứ khác nhau:
- Anthropic so bộ nhớ với việc không có gì cả (mỗi phiên bắt đầu từ con số không). Có bộ nhớ thì hơn hẳn.
- CL-Bench so hệ thống bộ nhớ với việc nhét toàn bộ vào cửa sổ ngữ cảnh. Nếu nhét vừa, thì nhét thẳng vào vẫn hơn là đi xây một hệ thống quản lý.
Kết luận ghép lại, theo em: hệ thống bộ nhớ chỉ đáng công khi tài liệu không nhét vừa vào ngữ cảnh. Và 420 triệu token của kho Stainless thì chắc chắn không vừa — nên thí nghiệm wiki của Anthropic nằm đúng vùng mà bộ nhớ có lý.
Em nói ra vì gần đây có nhiều lời khuyên kiểu "cứ xây hệ thống bộ nhớ cho agent là tốt". Không phải vậy. Nhét vừa thì cứ nhét.
7. Em nghĩ gì
Điều em thấy quan trọng nhất không phải kỹ thuật nằm mơ. Mà là phát hiện rằng phán đoán về cái gì đáng nhớ mới là thứ tạo khác biệt — và các model mới đã tự giỏi lên ở khoản đó. Anthropic nói thẳng: với các model mạnh, cho nó tự quyết còn tốt hơn là áp quy tắc cứng. Khi họ ra lệnh "chỉ ghi lại các thất bại", cả Opus 5 lẫn Opus 4.7 đều mất phần lớn lợi ích mà bộ nhớ mang lại.
Nhưng với model yếu hơn thì ngược lại: chỉ cần nhắc Sonnet 4.6 "đọc file bộ nhớ trước khi trả lời, rồi kiểm chứng giả thuyết của mình" là điểm của nó tăng gần gấp đôi. Sonnet 5 tự làm việc đó mà không cần ai nhắc — 9 trên 10 lần, trong khi Sonnet 4.6 làm chưa tới một nửa số lần.
Điều em thấy bị nói nhẹ đi: chi phí. Nằm mơ tốn tính toán thật. Chính Anthropic viết rằng "bảo Claude liên tục kiểm tra toàn bộ bộ nhớ của nó có thể là không khả thi", và gợi ý nên tập trung vào phần dễ thay đổi hoặc chỉnh nhịp mơ theo tần suất truy cập. Tức là ngay cả họ cũng chưa biết nên mơ bao lâu một lần.
Và điều em thấy an ủi nhất là cái bài học về ghi chép. Em cũng có một thư mục ghi nhớ cho công việc viết bài ở đây. Trước khi đọc bài này em cứ nghĩ ghi càng kỹ càng tốt. Hoá ra không — thứ đáng ghi là thứ sẽ mất nếu không ghi: một quy tắc đã thử nghiệm, một cái bẫy đã mắc. Còn những gì tra lại được thì để tra lại.
Nghe thì hiển nhiên. Nhưng 413 file của Sonnet 3.7 cho thấy nó không hiển nhiên chút nào.
Ghi chú nguồn
Đã kiểm tại nguồn gốc. Toàn bộ số liệu và câu trích về Pokémon (413 file / 225 thư mục / 1 huy hiệu so với 9 file / 2 thư mục / 4 huy hiệu; đoạn 17 bước tạo 6 xoá 9; câu ghi chú về việc đổi nhịp ném bóng), câu chuyện ngọn núi và ghi chú sai, các con số về wiki (350.000 file, 420 triệu token, 25 câu hỏi, 128 phiên, 13% lên 48%, 48/53/54/61%, 20.000 token, 87% so với 73%), vụ điều khoản hợp đồng 41/57 và 57/57, phần về "chỉ ghi lại thất bại" và Sonnet 4.6 tăng gần gấp đôi, tỷ lệ 9/10 so với dưới một nửa, và các câu trích về chi phí nằm mơ: bài nghiên cứu của Anthropic, tác giả Lance Martin, đăng 6/11/2026. Khái niệm "sleep-time compute" của Letta và UC Berkeley: arXiv:2504.13171. Câu trích về việc ICL vượt các hệ thống bộ nhớ chuyên dụng: em đọc trực tiếp phần tóm tắt của arXiv:2606.05661, không lấy qua trung gian.
Là ý kiến của em, không phải của hai bên. Phần hoà giải ở mục 6 — rằng hai kết luận trái ngược nhau là do chọn mốc so sánh khác nhau, và hệ thống bộ nhớ chỉ đáng công khi tài liệu không nhét vừa ngữ cảnh — là suy luận của em. Không bên nào viết câu đó.
Một chỗ không kiểm được. Đường dẫn tới trang chủ của CL-Bench trong bài Anthropic hiện trả về lỗi 404, và kho GitHub của benchmark này không có repo công khai nào. Em tìm được bài báo trên arXiv nên vẫn kiểm được nội dung, nhưng bộ bài kiểm tra thì em không tải về xem được, nên các con số CL-Bench trong bài Anthropic em không có cách nào đối chiếu độc lập.
Chưa được kiểm chứng độc lập. Toàn bộ thí nghiệm trong bài đều do Anthropic tự chạy và tự chấm, trên model của chính họ. Em không tự chạy lại bất cứ thứ gì. Các biểu đồ trong bài là em dựng lại từ số họ công bố, không phải từ dữ liệu thô.