Bản tin AI 11/09/2026: DeepSeek V4.1-Flash, Agents API và cuộc đua xây agent đáng tin
Mười diễn biến về model mở, hạ tầng agent, voice API và các nghiên cứu mới về bộ nhớ, GUI agent và điều phối multi-agent.
Hôm nay có 10 tin đáng chú ý. Tâm điểm là DeepSeek phát hành model mở V4.1-Flash, OpenAI đưa hạ tầng Codex thành Agents API và mở GPT-Live-1 cho nhà phát triển; ở mảng nghiên cứu, các bài mới tập trung vào GUI agent xuyên thiết bị, bộ nhớ dài hạn và cách tổ chức multi-agent đáng tin cậy hơn.
1. DeepSeek V4.1-Flash: model mở 552B, context một triệu token và KV cache nhỏ hơn bốn lần
Phát hành API và weights: 10/09/2026
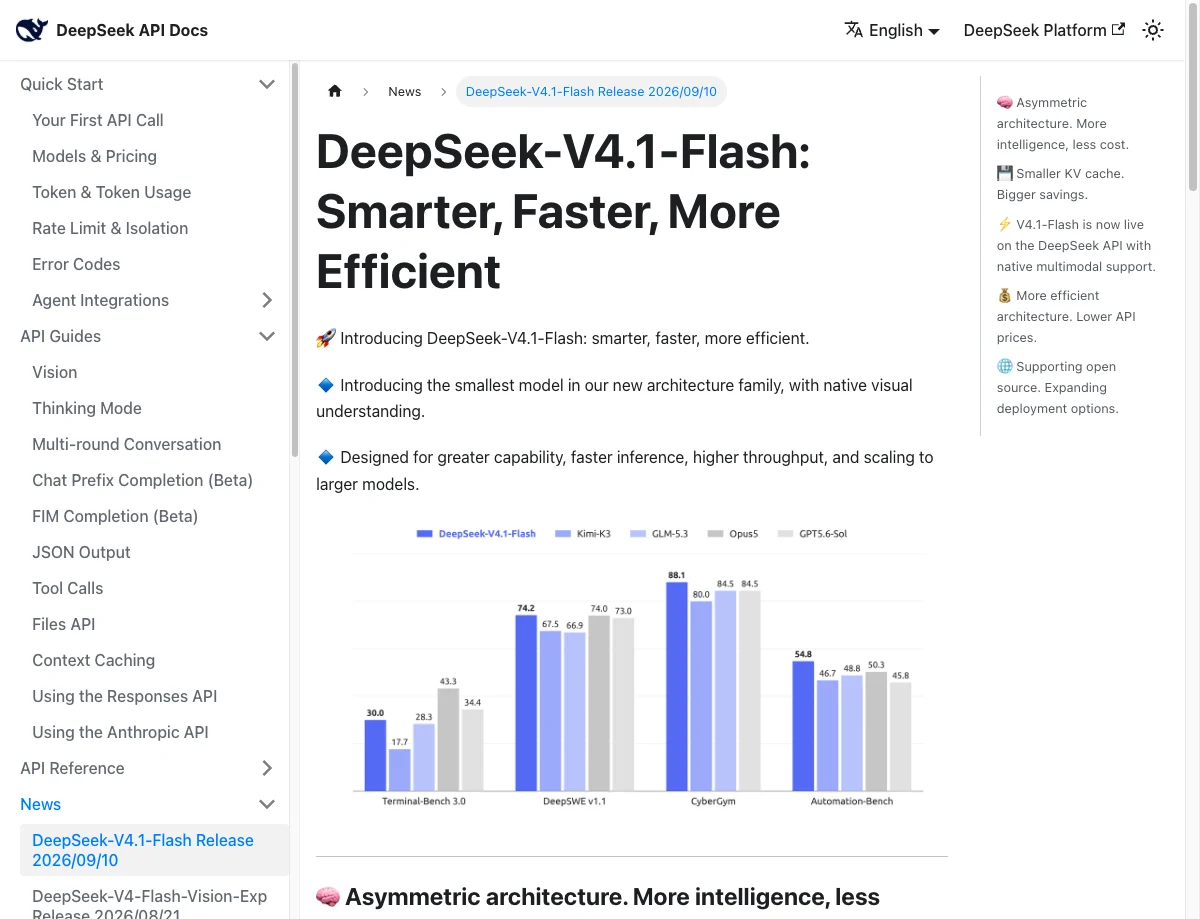
DeepSeek phát hành V4.1-Flash, model đa phương thức Mixture-of-Experts theo giấy phép MIT. Backbone có 552 tỷ tham số, nhưng kiến trúc Causal Encoder–Decoder bất đối xứng chỉ kích hoạt khoảng 8B tham số cho mỗi token đầu vào và 16B khi sinh output; model nhận văn bản, hình ảnh và hỗ trợ context tới một triệu token.
Trọng tâm kỹ thuật là giảm chi phí agent phải đọc lại context dài. DeepSeek cho biết KV cache dùng một phần tư HBM và phần lưu bền vững chỉ bằng một phần tám V4-Flash. Model đã có trên API với tên deepseek-flash; các endpoint V4-Flash cũ được chuyển sang bản mới, còn V4-Pro sẽ bắt đầu được định tuyến sang V4.1-Flash từ 04:00 UTC ngày 14/09 cho tới khi V4.1-Pro ra mắt. Các tuyên bố benchmark hiện chủ yếu là số liệu của hãng.
Vì sao đáng chú ý: Đây là bản nâng cấp model đáng kể nhất trong ngày và nhắm thẳng vào chi phí của coding/research agent có prompt rất dài. Giấy phép MIT mở thêm lựa chọn tự triển khai, nhưng kích thước weights vẫn đòi hỏi hạ tầng lớn; việc tự động đổi endpoint cũng khiến đội production cần chạy regression test trước ngày 14/09.
Thông báo và lịch chuyển API: DeepSeek · Weights và model card: Hugging Face
2. OpenAI ra Agents API, đưa harness của Codex lên dịch vụ cloud
Công bố và mở public beta: 10/09/2026
Agents API cho phép tạo agent cloud bằng một lệnh gọi, khai báo model, tool, vault và môi trường thực thi. OpenAI vận hành cùng harness phía sau Codex; nhà phát triển có thể dùng sandbox do OpenAI quản lý, hạ tầng của mình hoặc nhà cung cấp sandbox đối tác.
API tích hợp compaction cho phiên dài nhiều context window, tool search để chỉ nạp định nghĩa cần thiết, gọi tool bằng code và hỗ trợ MCP, function tùy chỉnh, web search lẫn subagent song song. Public beta mở cho mọi nhà phát triển và không thu phí nền tảng riêng ngoài token và tool sử dụng; lõi harness Codex vẫn là mã nguồn mở.
Vì sao đáng chú ý: Các thành phần trước đây phải tự ghép—sandbox, lưu trạng thái, rút gọn context, chọn tool và điều phối subagent—đang trở thành hạ tầng managed. Điều này có thể rút ngắn đáng kể đường từ prototype tới agent chạy hàng giờ hoặc hàng ngày, đổi lại doanh nghiệp phải đánh giá kỹ ranh giới dữ liệu, credential và phụ thuộc nhà cung cấp.
Thông báo và chi tiết kỹ thuật: OpenAI
3. GPT-Live-1 đưa hội thoại giọng nói full-duplex vào API với giá 0,05 USD/phút
Phát hành API: 10/09/2026
OpenAI mở GPT-Live-1 cho nhà phát triển. Model xử lý nghe và nói đồng thời, cho phép người dùng ngắt lời, đổi ý hoặc tạm dừng tự nhiên; khi cần suy luận sâu hay gọi tool, lớp thoại có thể giao việc cho GPT-6 Astra, model khác hoặc agent backend mà không làm cuộc hội thoại bị đứng lại.
Bản API hỗ trợ điều khiển giọng điệu và tốc độ qua system prompt, transcript ASR, keyword biasing, phiên dài và điện thoại. OpenAI báo cáo GPT-Live-1 tăng 30 điểm trên Full Duplex Bench so với GPT-Realtime-2.1; Speak cho biết số lần agent chen vào lúc người học đang suy nghĩ giảm gần 80% trong đánh giá sớm. Giá lớp thoại phía trước là 0,05 USD mỗi phút, chưa gồm model backend và tool.
Vì sao đáng chú ý: Voice agent có thể bỏ bớt chuỗi STT–LLM–TTS dễ phát sinh độ trễ và lỗi chuyển giao. Giá theo phút làm mô hình chi phí dễ dự báo hơn cho tổng đài, đặt lịch và trợ lý nói chuyện, nhưng tổng chi phí vẫn phụ thuộc phần reasoning phía sau.
Công bố, benchmark và giá: OpenAI
4. Data agent biến dữ liệu doanh nghiệp thành phân tích, dashboard và hành động
Công bố: 10/09/2026
OpenAI giới thiệu Data agent trong ChatGPT Work. Agent kết nối các nguồn được quản trị như Redshift, BigQuery, ClickHouse, Databricks, MongoDB, Snowflake, Google Drive và SharePoint; sau đó điều tra biến động, trình bằng chứng và tạo dashboard tương tác bằng ngôn ngữ tự nhiên.
Hệ thống sử dụng định nghĩa metric và quan hệ dữ liệu từ semantic layer như dbt, Databricks Genie Ontology, Snowflake Horizon và BI hiện hữu. Nó còn có thể xây hoặc cập nhật dashboard trong Power BI, Tableau, Sigma, Omni, Oracle BI và ThoughtSpot, rồi chia sẻ kết quả qua Slack/email hoặc thực hiện hành động đã được người dùng phê duyệt. Quyền truy vấn kế thừa giới hạn bảng, hàng và cột của tài khoản kết nối.
Vì sao đáng chú ý: Đây là bước từ chatbot hỏi dữ liệu sang một analyst có thể để lại dashboard dùng tiếp và nối insight với workflow. Giá trị thực tế sẽ phụ thuộc chất lượng semantic layer và kiểm soát quyền; nếu metric doanh nghiệp chưa được chuẩn hóa, agent vẫn có thể trả lời nhất quán nhưng sai ý nghĩa kinh doanh.
Thông báo và danh sách tích hợp: OpenAI
5. ChatGPT for Financial Services tích hợp dữ liệu tài chính cao cấp và GPT-6 Astra
Công bố: 10/09/2026
ChatGPT for Financial Services là biến thể ChatGPT Work dành cho ngân hàng đầu tư và nghiên cứu cổ phiếu, được thiết kế cùng Morgan Stanley và Evercore. Sản phẩm tích hợp sẵn dữ liệu từ Daloopa, PitchBook, LSEG News và Crunchbase; OpenAI lưu chỉ mục dữ liệu để cải thiện truy xuất và cung cấp trích dẫn tới bảng hoặc đoạn nguồn.
GPT-6 Astra được dùng cho các việc như phân tích earnings, dựng LBO, sàng lọc người mua và chuẩn bị pitchbook. Doanh nghiệp có thể xuất theo template Excel, Word hoặc PowerPoint đã được quản trị, đồng thời dùng đăng nhập dùng chung với những gói dữ liệu hiện có từ S&P Capital IQ, LSEG, MSCI, Factiva và Moody’s khi các tích hợp hoàn tất. Sản phẩm chỉ dành cho tổ chức đủ điều kiện.
Vì sao đáng chú ý: OpenAI đang đóng gói model, dữ liệu có bản quyền, provenance và template đầu ra thành sản phẩm dọc thay vì chỉ bán chatbot chung. Nếu hoạt động đúng như mô tả, lợi thế cạnh tranh nằm ở dữ liệu và quy trình kiểm soát được, không chỉ ở model nền.
Thông báo và phạm vi cung cấp: OpenAI
6. Anthropic: AI đã chuyển từ trợ lý sang điều phối viên trong một số chiến dịch tấn công
Báo cáo công bố: 10/09/2026; dữ liệu bao phủ 12/2025–08/2026
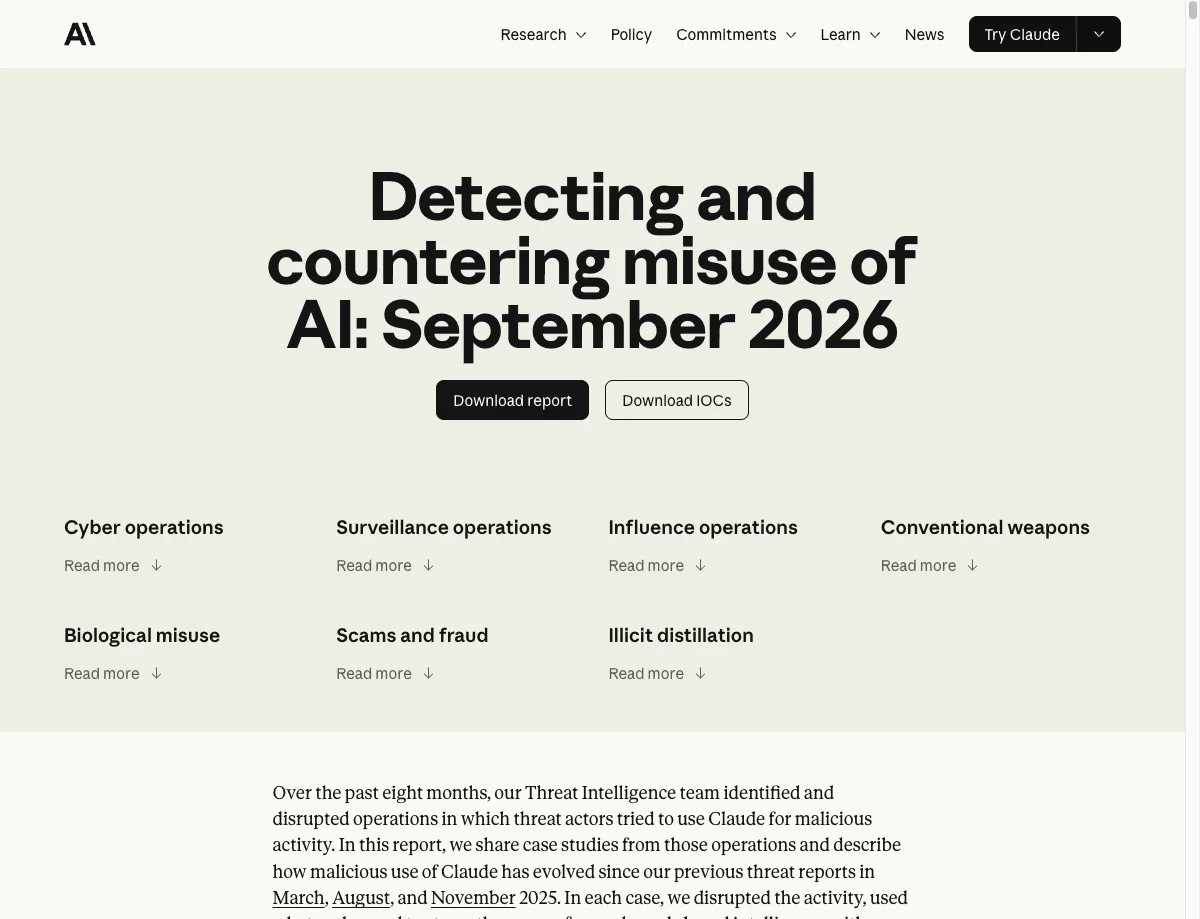
Báo cáo threat intelligence mới của Anthropic mô tả các hoạt động bị hãng phát hiện và chặn trong bảy nhóm rủi ro, từ cyber, giám sát và lừa đảo tới sinh học, vũ khí thông thường và distillation. Một số framework multi-agent đã tự chạy trinh sát, khai thác và đánh cắp trên nhiều mục tiêu song song trong nhiều giờ hoặc nhiều ngày, dù con người vẫn chọn mục tiêu và quyết định cách kiếm tiền.
Trong một chiến dịch, tác nhân dùng Claude xuyên suốt chuỗi tấn công, gồm tạo hạ tầng phishing, chạy lệnh, lấy credential, di chuyển ngang và tổ chức hàng trăm GB dữ liệu; một vụ xâm nhập làm lộ hơn 300.000 hồ sơ định danh cùng dữ liệu đăng ký của hơn nửa triệu doanh nghiệp. Anthropic cũng nêu năm ca sử dụng có thể hỗ trợ nghiên cứu sinh học dual-use và các chiến dịch distillation quy mô lớn. Đây là báo cáo tự điều tra của nhà cung cấp, nên việc quy trách nhiệm chưa phải xác minh độc lập.
Vì sao đáng chú ý: Đơn vị rủi ro không còn là một prompt độc hại mà là toàn bộ chuỗi hành động kéo dài và phối hợp nhiều agent. Phòng thủ cần theo dõi trajectory, danh tính, luồng dữ liệu và hành động qua nhiều dịch vụ; refusal ở từng lượt không đủ để chứng minh hệ thống an toàn.
7. JarvisGUI: agent tốt nhất chỉ hoàn thành 8% workflow nhiều thiết bị
Đăng arXiv: 09/09/2026; xuất hiện trong danh sách mới ngày 10/09; được nhận tại EMNLP 2026
JarvisGUI đánh giá agent qua 150 workflow tổng hợp có dependency trên Android, Windows và Ubuntu, gồm 442 tác vụ con. Các nhiệm vụ được mô hình hóa bằng input/output có kiểu để hệ thống có thể tạo chuỗi công việc động, truyền file hoặc dữ liệu giữa thiết bị và chấm trạng thái cuối bằng bộ kiểm tra xác định.
Sáu agent open-source đạt 28,8–42,4% trên tác vụ đơn lẻ nhưng chỉ 1,3–8,0% trên workflow tổng hợp. Ở nhóm có dependency xuyên thiết bị, không model nào vượt 2% thành công; thay planner Qwen3-VL-Plus bằng Kimi K2.6 chỉ đưa điểm multi-task tổng thể từ 8,0 lên 11,3%.
Vì sao đáng chú ý: Benchmark trên một máy có thể đánh giá quá lạc quan computer-use agent. Workflow thật thường phải chuyển trạng thái giữa điện thoại, desktop và server; một lỗi nhỏ ở bước gửi file hay đăng nhập có thể làm hỏng cả chuỗi.
Bài báo gốc và liên kết mã nguồn: arXiv 2609.10451
8. ConvMem biến đọc context gần 900K token thành cây xử lý song song
Đăng arXiv: 09/09/2026; xuất hiện trong danh sách mới ngày 10/09
ConvMem là cách xử lý context dài không cần huấn luyện: một LLM đóng vai “kernel” tóm tắt các đoạn văn song song, rồi hợp nhất chúng theo nhiều tầng giống convolution. Query được tách thành các kênh ngữ nghĩa riêng, còn skip connection giữ lại bằng chứng thô quan trọng để tránh mất chi tiết qua nhiều lượt tóm tắt.
Trên RULER-HotpotQA và 2WikiMultiHopQA với context từ 28K tới 896K token, ConvMem dẫn đầu các phương pháp không huấn luyện. Ở 896K trên tập ngoài phân phối 2WikiMultiHopQA, F1 đạt 59,06 so với 49,65 của MemAgent không RL và 20,93 của Qwen2.5-32B trực tiếp; độ sâu suy luận giảm từ chuỗi tuyến tính xuống cây logarithmic và có thể song song hóa.
Vì sao đáng chú ý: Thay vì buộc một agent đọc tuần tự rồi liên tục ghi đè memory, hệ thống có thể chia context rất dài thành nhiều nhánh độc lập và giữ provenance của bằng chứng. Đây là hướng thực dụng cho nghiên cứu kho tài liệu lớn, dù số lượt gọi song song và chi phí tổng vẫn cần đo theo từng workload.
9. Skill có hợp đồng rõ ràng hoạt động tốt hơn khi chạy bằng subagent riêng
Đăng arXiv: 07/09/2026; xuất hiện trong danh sách mới ngày 10/09
Nghiên cứu Subagents vs Agent Skills so sánh hai cách dùng skill: nạp hướng dẫn vào context chính hoặc mở context mới để một subagent thực hiện. Trên 64 tác vụ SkillsBench, subagent tốt hơn khi skill chứa quy trình cùng hợp đồng input–output rõ ràng; ngược lại, với skill chỉ là kiến thức tham khảo lỏng, nạp trực tiếp vào agent chính thường tốt hơn.
Khi số tool gây nhiễu tăng, subagent suy giảm chậm hơn. Với GPT-5.3 Codex và Kimi K2.6, cách này giảm peak context trên hơn 80% tác vụ, nhưng tổng token tăng vì phải truyền thông tin giữa agent chính và subagent. Thiết kế tốt nhất trong thí nghiệm dùng skill inline cho node định tuyến và subagent cho leaf skill có đầu vào–đầu ra tự chứa.
Vì sao đáng chú ý: “Skill hay subagent” không phải lựa chọn tuyệt đối. Kiến thức nền nên ở context chính; quy trình độc lập có hợp đồng rõ nên được cô lập thành subagent để giảm áp lực context—một nguyên tắc trực tiếp áp dụng cho Hermes, OpenClaw và các hệ multi-agent dài hạn.
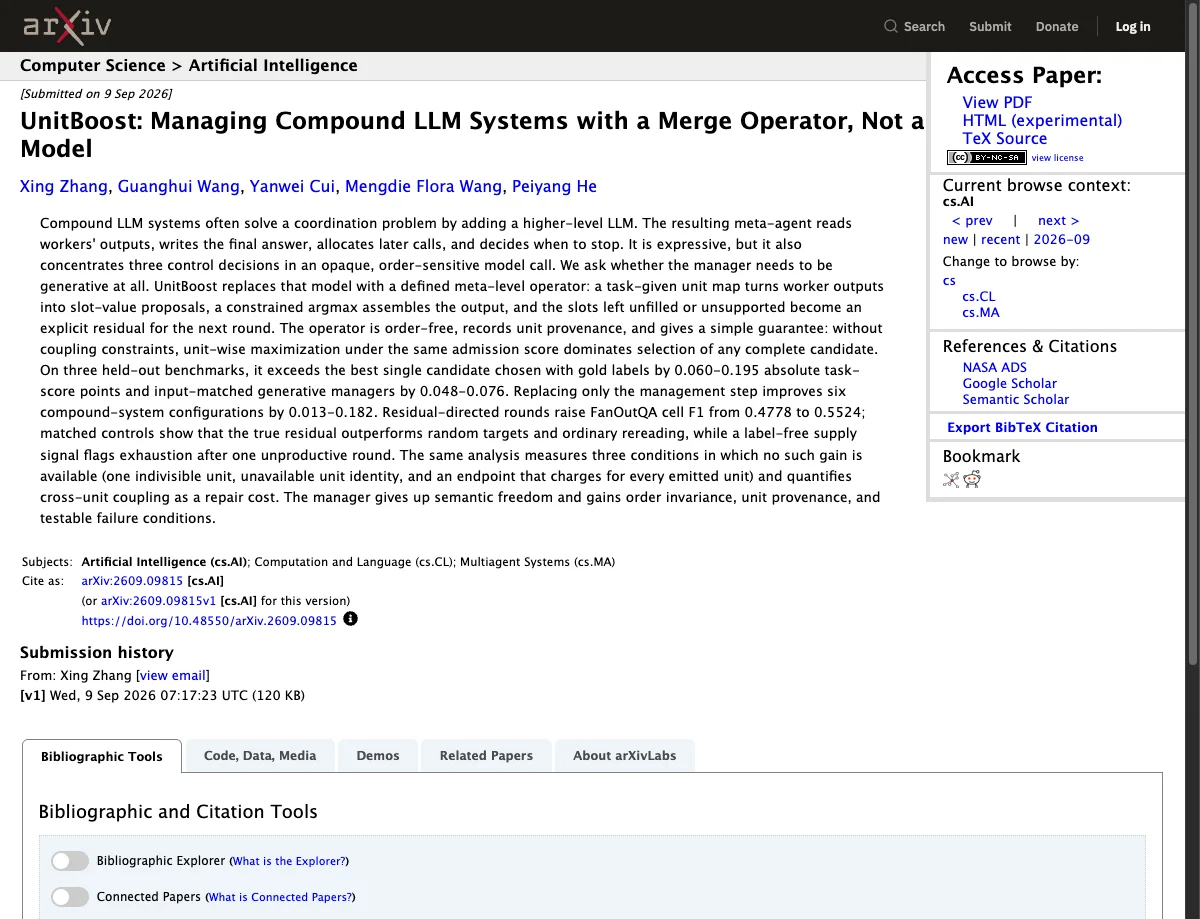
10. UnitBoost thay model quản lý multi-agent bằng phép gộp có thể kiểm tra
Đăng arXiv: 09/09/2026; xuất hiện trong danh sách mới ngày 10/09
UnitBoost bỏ meta-agent sinh văn bản vốn phải đọc output của mọi worker rồi tự quyết định ghép, gọi tiếp hay dừng. Thay vào đó, hệ thống ánh xạ đầu ra thành các đề xuất theo từng “slot”, chọn giá trị bằng phép tối ưu có ràng buộc và biến những slot còn thiếu thành residual rõ ràng cho vòng kế tiếp; mỗi đơn vị kết quả giữ lại nguồn gốc.
Trên ba benchmark giữ riêng, UnitBoost cao hơn ứng viên đơn tốt nhất được chọn bằng nhãn vàng 0,060–0,195 điểm tuyệt đối và hơn manager sinh tạo với input tương đương 0,048–0,076. Riêng FanOutQA, vòng lặp hướng theo residual nâng cell F1 từ 0,4778 lên 0,5524.
Vì sao đáng chú ý: Thêm một LLM làm “sếp” tạo ra điểm mù mới về thứ tự, provenance và điều kiện dừng. Với nhiệm vụ có thể chia thành trường thông tin độc lập, phép gộp xác định giúp kết quả dễ audit hơn và cho biết chính xác phần nào còn thiếu; đổi lại nó kém linh hoạt khi các phần phụ thuộc chặt vào nhau.