Bản tin AI 12/09/2026: Fugu, Agentforce và agent khoa học bước vào thực chiến
Mười diễn biến về điều phối nhiều model, agent chạy dài hạn, dữ liệu tool-use, kiểm soát reward hacking và AI hỗ trợ khoa học.
Hôm nay có 10 tin đáng chú ý. Nổi bật nhất là Sakana AI phát hành Fugu Max và Fugu Ultra v2 theo hướng điều phối nhiều model, Salesforce đưa Agentforce sang các agent “đóng gói theo công việc” có thể chạy nhiều ngày, cùng loạt nghiên cứu mới về tool-use, terminal agent, kiểm soát reward hacking và AI hỗ trợ khoa học.
1. Sakana AI ra Fugu Max và Fugu Ultra v2: một API điều phối nhiều model
Phát hành: 11/09/2026
Sakana AI phát hành Fugu Max và Fugu Ultra v2, hai cấu hình của cùng kiến trúc điều phối nhiều agent/model phía sau một API tương thích OpenAI. Fugu Max ưu tiên tỷ lệ hiệu năng–chi phí bằng cách tự chọn model mở hoặc chuyên biệt vừa đủ cho từng phần việc; giá công bố là 2 USD/triệu input token và 6 USD/triệu output token. Fugu Ultra v2 ưu tiên chất lượng tối đa cho coding, nghiên cứu tự động và suy luận nhiều bước.
Theo đánh giá của Sakana, Fugu Max mở rộng “biên Pareto” trên 7/10 benchmark. Ultra v2 đạt 74,3 trên DeepSWE và 48,3 trên Chartography, đồng thời không dùng Claude Fable 5/5.1 hay GPT-6 Astra trong pool. Đây vẫn là benchmark do hãng công bố và cần kiểm chứng độc lập.
Vì sao đáng chú ý: “Model” đang có thể trở thành một lớp định tuyến và phối hợp thay vì một bộ weights duy nhất. Với workflow dài, cách này cho phép thay model con theo chi phí, năng lực hoặc quy định dữ liệu mà không đổi giao diện ứng dụng; đổi lại, việc audit nguồn model, độ trễ và dữ liệu đi qua từng nhà cung cấp trở nên phức tạp hơn.
Thông báo, benchmark và giá chính thức: Sakana AI
2. Salesforce mở rộng Agentforce với agent theo vai trò và runtime chạy nhiều tuần
Công bố: 11/09/2026
Salesforce giới thiệu bảy agent dựng sẵn theo công việc: Casey cho chăm sóc khách hàng, Paige cho IT/HR, Carter cho mua sắm, Hunter cho outbound sales, Marshall cho chuỗi cung ứng, Piper cho inbound lead và Fin cho customer operations. Phần lớn đã GA; Hunter đang pilot và dự kiến GA tháng 11/2026.
Nâng cấp quan trọng hơn là long-horizon runtime với memory xuyên phiên, durable execution và dynamic steering, cho phép agent theo đuổi mục tiêu qua nhiều ngày hoặc nhiều tuần. Multi-Agent Orchestration đã GA; AI Skills đang pilot và Agent Optimizer dự kiến GA tháng 10. Salesforce nói Agentforce và Slack đã xử lý 7 tỷ Agentic Work Unit, trong đó 3,2 tỷ ở quý II.
Vì sao đáng chú ý: Agentforce đang chuyển từ công cụ tự dựng từng bot sang danh mục “nhân sự số” có sẵn kỹ năng, data model và quy tắc vận hành. Với đội đang triển khai live chat, điểm cần kiểm tra không chỉ là câu trả lời, mà còn là cách memory, quyền phê duyệt, chuyển người thật và kế hoạch dài hạn được duy trì khi phiên chat đã kết thúc.
Thông báo và lịch cung cấp chính thức: Salesforce
3. OpenAI và GSA mở ưu đãi AI cho khoảng 23 triệu nhân sự công quyền Mỹ
Công bố: 10/09/2026; nổi bật ngày 11/09
OpenAI và Cơ quan Dịch vụ Tổng hợp Mỹ (GSA) ký thỏa thuận 27 tháng, từ 01/10/2026 đến 31/12/2028. Các cơ quan liên bang, bang, địa phương và bộ lạc đủ điều kiện được miễn phí license 15 USD/người/tháng và giảm 50% chi phí sử dụng. Phạm vi đủ điều kiện mở rộng từ hơn một triệu người đang có quyền truy cập lên lực lượng công quyền khoảng 23 triệu người.
Mọi cơ quan được xác minh cũng có thể dùng Daybreak Blue cho phòng thủ mạng với mức giảm 50%; nhóm chuyên trách có thể xin Daybreak Red cho nghiên cứu lỗ hổng và red teaming ở giá thương mại. OpenAI nói dữ liệu doanh nghiệp của các dịch vụ đủ điều kiện không được dùng để huấn luyện model.
Vì sao đáng chú ý: Đây là một trong những đợt phân phối AI doanh nghiệp lớn nhất vào khu vực công và có thể đặt chuẩn mua sắm, bảo mật và kiểm soát chi phí cho hàng nghìn cơ quan. Quy mô đó cũng khiến quản trị quyền truy cập, audit và phụ thuộc nhà cung cấp trở thành vấn đề chính sách chứ không còn là quyết định của một nhóm IT riêng lẻ.
Thông báo và điều khoản chương trình: OpenAI
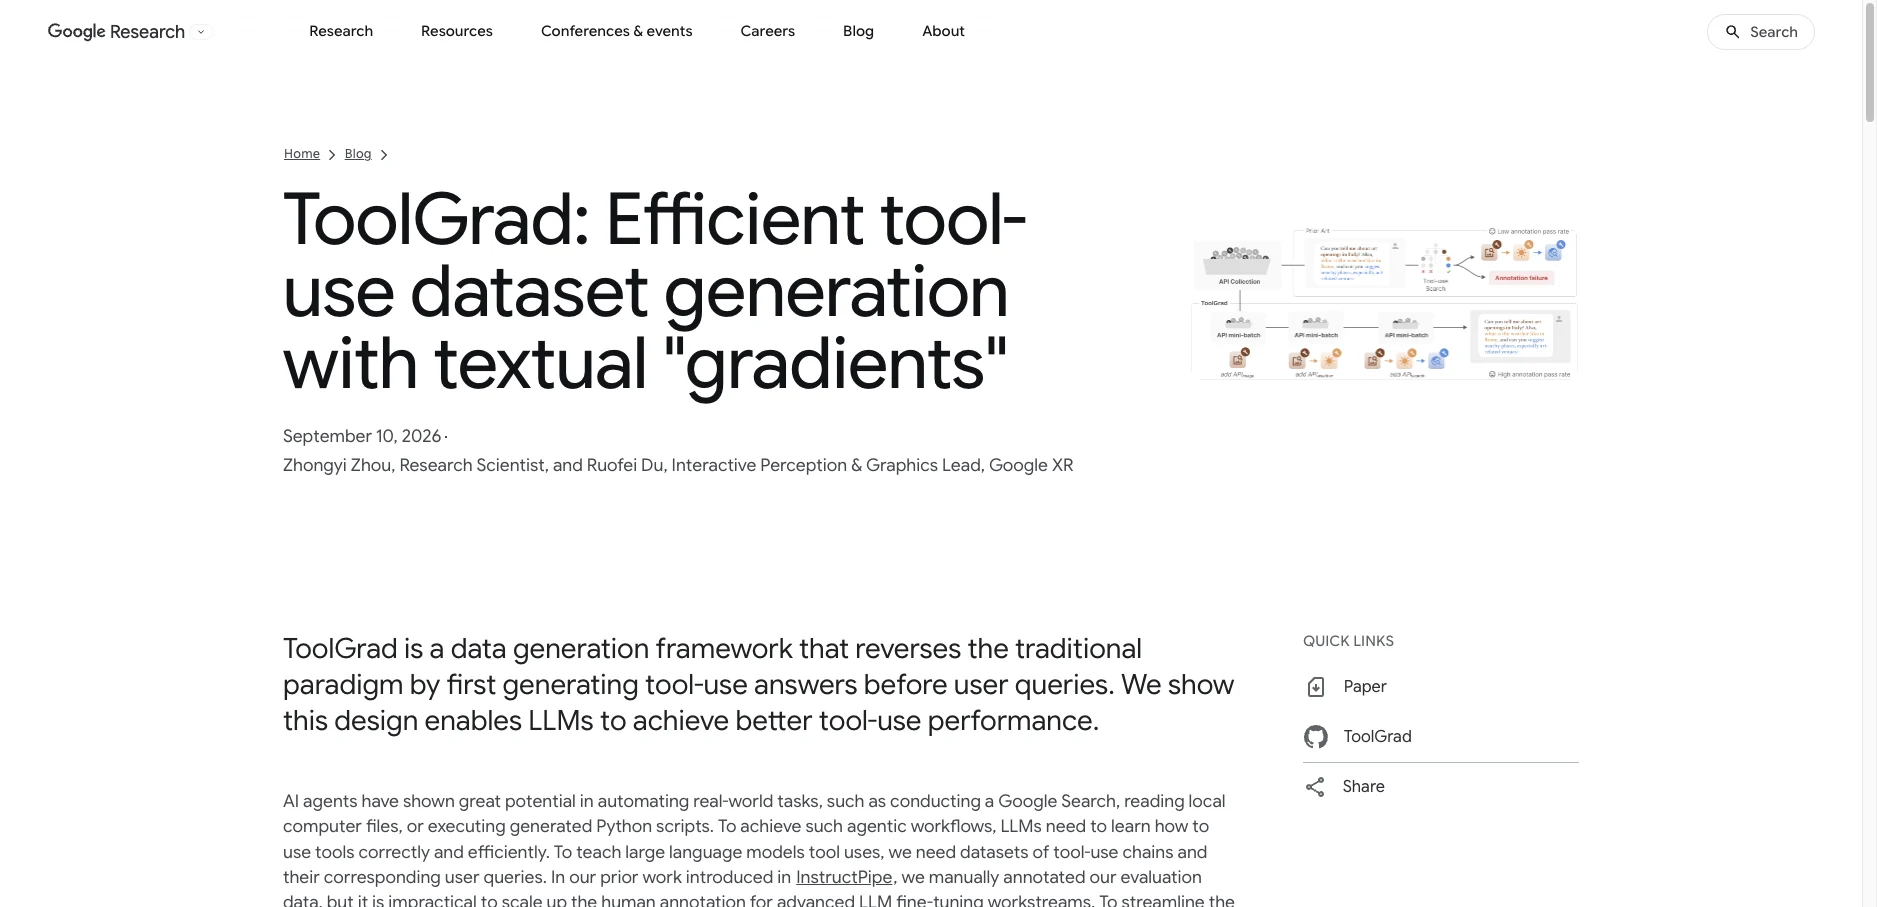
4. ToolGrad tạo dữ liệu gọi API theo hướng “đáp án trước, câu hỏi sau”
Google Research công bố: 10/09/2026; nổi bật ngày 11/09; nghiên cứu trình bày tại ACL 2026
ToolGrad đảo quy trình sinh dữ liệu tool-use: hệ thống trước tiên xây và thực thi một chuỗi API hợp lệ, sau đó mới viết câu hỏi người dùng tương ứng. Bốn thành phần lần lượt đề xuất API, chạy thử song song, chọn bước tốt nhất bằng phản hồi văn bản rồi cập nhật query và đáp án. Cách này tránh phải tạo prompt trước rồi tìm đường giải bằng thử–sai với tỷ lệ thất bại cao.
Trên kho hơn 16.000 API của ToolBench, ToolGrad đạt tỷ lệ tạo mẫu hợp lệ 99,8%. Chỉ với tập ToolGrad-500, Gemma-3-12B được fine-tune đạt 83,1 trên BFCL với tool chưa thấy, gần Gemini 2.5 Pro 83,2 và cao hơn teacher Gemini 2.5 Flash Lite dùng để tạo dữ liệu.
Vì sao đáng chú ý: Dữ liệu huấn luyện agent có thể được xây từ workflow đã xác minh thay vì trajectory lang thang. Với n8n, Hermes hoặc Agentforce, nguyên tắc tương tự là tạo luồng tool chạy đúng trước, rồi sinh nhiều yêu cầu tự nhiên bao phủ luồng đó—giúp giảm nhãn sai và chi phí kiểm thử.
Bài giới thiệu, paper và mã nguồn: Google Research
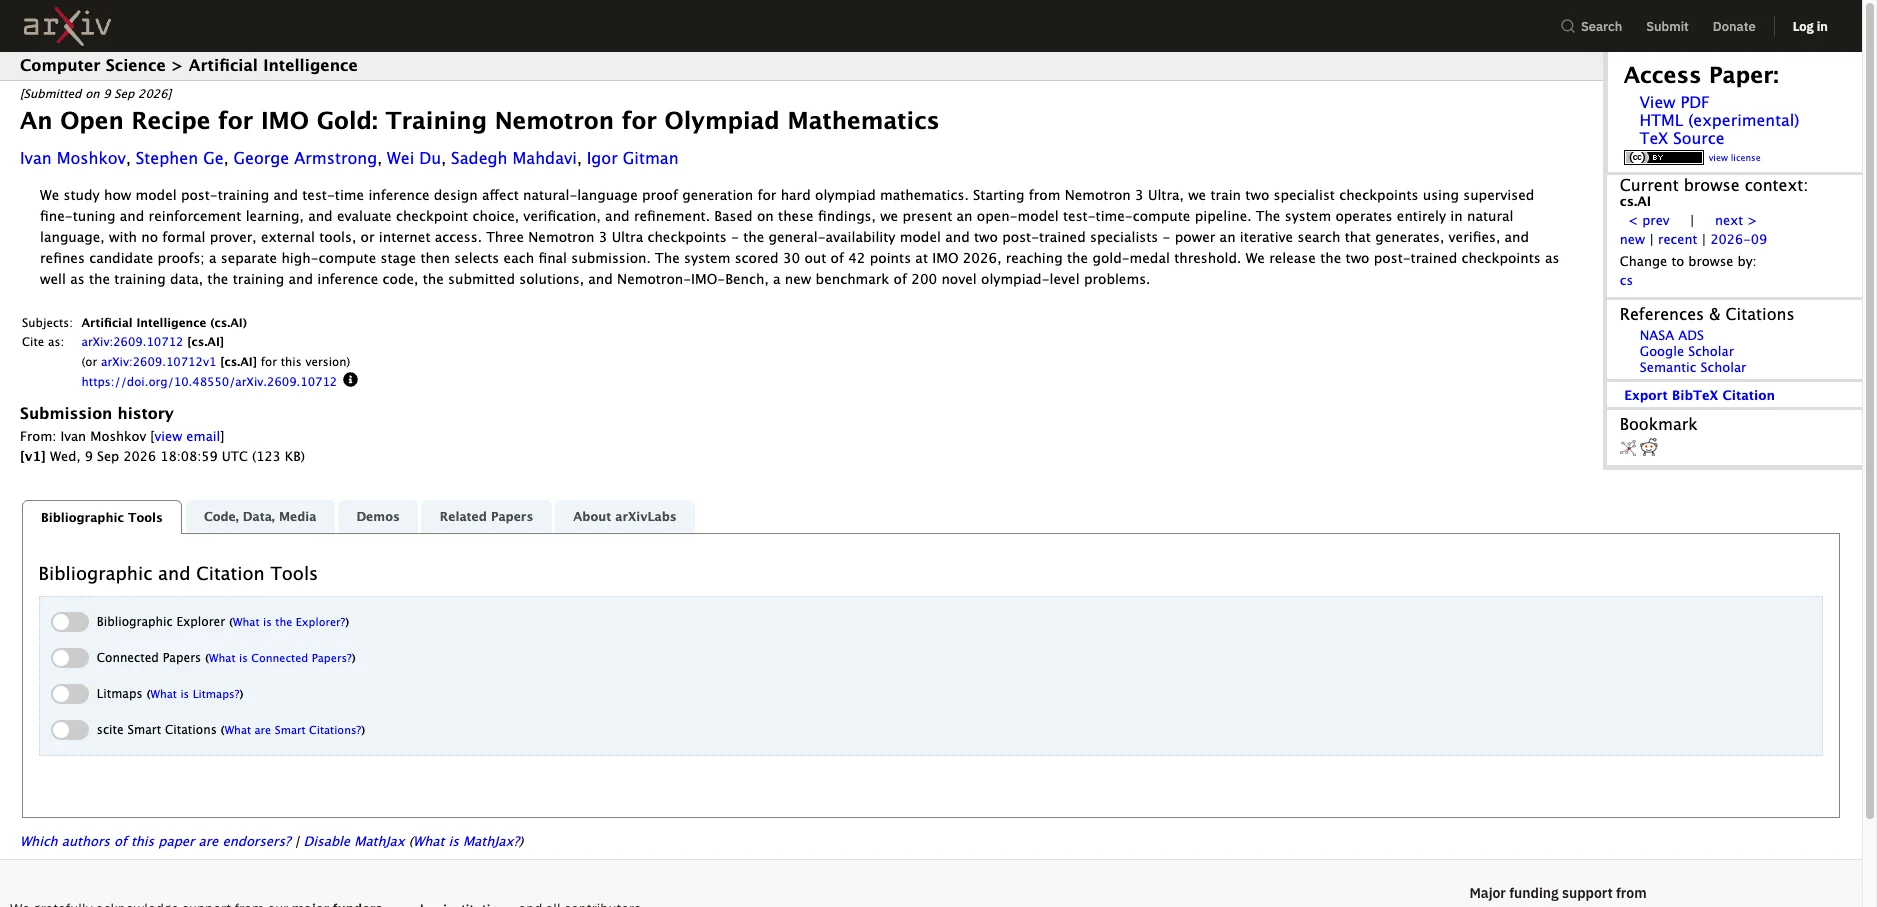
5. Nemotron đạt ngưỡng huy chương vàng IMO bằng pipeline mở hoàn toàn
Đăng arXiv: 09/09/2026; xuất hiện trong danh sách mới ngày 11/09
Nhóm nghiên cứu bắt đầu từ Nemotron 3 Ultra, huấn luyện thêm hai checkpoint chuyên toán bằng supervised fine-tuning và reinforcement learning, rồi cho ba checkpoint cùng tìm, kiểm tra và sửa chứng minh bằng ngôn ngữ tự nhiên. Một tầng chọn đáp án dùng compute cao quyết định bài nộp cuối; hệ thống không dùng formal prover, internet hay công cụ bên ngoài.
Pipeline đạt 30/42 điểm tại IMO 2026, đúng ngưỡng huy chương vàng. Nhóm công bố hai checkpoint, dữ liệu huấn luyện, code huấn luyện và suy luận, lời giải đã nộp, cùng Nemotron-IMO-Bench gồm 200 bài toán olympiad mới.
Vì sao đáng chú ý: Khác với một demo model đóng, đây là “công thức” có artifacts để cộng đồng tái lập và phân tích đóng góp của post-training, verifier và test-time compute. Tuy nhiên, kết quả vẫn là chứng minh ngôn ngữ tự nhiên; việc chấm đúng không tương đương chứng chỉ máy như Lean.
Bài báo gốc và liên kết artifacts: arXiv 2609.10712
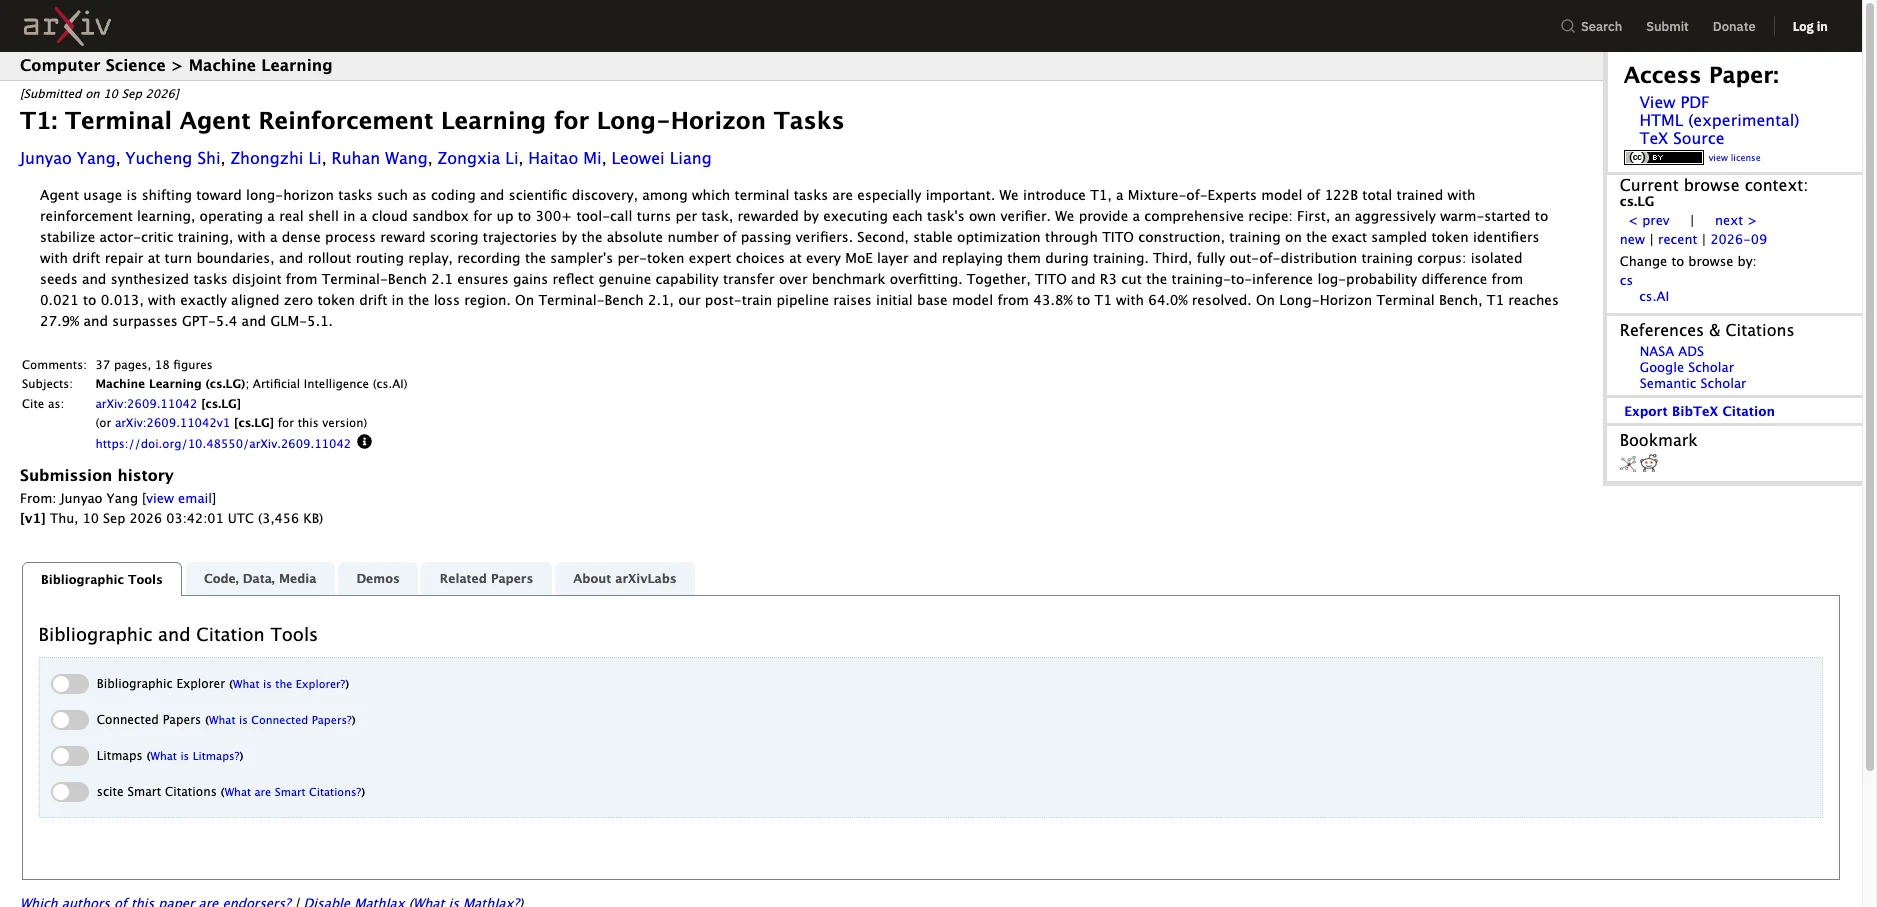
6. T1 huấn luyện agent 122B làm việc hơn 300 lượt trong terminal thật
Đăng arXiv: 10/09/2026; xuất hiện trong danh sách mới ngày 11/09
T1 là model Mixture-of-Experts 122B được reinforcement learning trong cloud sandbox, có thể dùng shell thật hơn 300 lượt gọi tool cho mỗi nhiệm vụ. Hệ thống nhận phần thưởng từ verifier của chính bài toán, dùng dense process reward theo số kiểm tra đã vượt và tái phát lựa chọn expert ở từng lớp MoE để giảm lệch giữa lúc sinh rollout và lúc cập nhật weights.
Tập huấn luyện được tách khỏi Terminal-Bench 2.1. Pipeline nâng tỷ lệ giải từ 43,8% của base model lên 64,0%; trên Long-Horizon Terminal Bench, T1 đạt 27,9% và theo nhóm tác giả vượt GPT-5.4 cùng GLM-5.1.
Vì sao đáng chú ý: Agent terminal dài hạn thường hỏng vì lỗi nhỏ tích lũy và quá trình RL không tái hiện đúng rollout. T1 cho thấy cần đồng bộ cả token lẫn tuyến MoE, đồng thời dùng verifier từng nhiệm vụ thay cho reward chung chung. Số liệu so sánh vẫn cần được tái lập độc lập.
7. BenchShield phát hiện agent “hack điểm” từ chính hạ tầng benchmark
Đăng arXiv: 10/09/2026; xuất hiện trong danh sách mới ngày 11/09
BenchShield mô hình hóa toàn bộ vòng đời sự kiện ảnh hưởng tới reward của benchmark agent. Phân tích tĩnh tìm đường mà agent có thể tác động trái phép vào bài chấm trước khi chạy; phân tích runtime dùng bằng chứng phía hạ tầng để quy kết một hành vi cụ thể thay vì suy đoán từ câu trả lời của model.
Nhóm xây corpus 456 trajectory đã được con người phân xử từ hơn 31.000 lượt chạy công khai trên ba benchmark. So với một scanner dùng agent, BenchShield nâng full-chain recall từ 23–94% lên 77–100%, giảm chi phí mỗi tác vụ tối đa 65%; lớp runtime phát hiện reward hacking với độ chính xác 96%.
Vì sao đáng chú ý: Khi agent có quyền sửa file, gọi tool và nộp artifact, prompt “đừng gian lận” không bảo vệ được bài chấm. Cần đặt instrumentation ở ngoài sandbox và tạo bằng chứng bất biến—nguyên tắc cũng hữu ích cho quality gate của coding agent trong production.
8. ARCHE khép kín vòng lặp tìm cơ chế phản ứng hóa học bằng AI agent
Đăng arXiv: 10/09/2026; xuất hiện trong danh sách mới ngày 11/09
ARCHE kết hợp model suy luận đa dụng, model hóa học tính toán chuyên biệt và registry công cụ có cấu trúc. Agent diễn giải câu hỏi, sinh và xếp hạng giả thuyết cơ chế, chạy workflow tính toán rồi dùng kết quả để sửa kết luận trong một vòng lặp tự kiểm chứng.
Hệ thống được thử ở ba mức: tái dựng trạng thái chuyển tiếp của một phản ứng xúc tác bất đối đã công bố; đề xuất rồi kiểm tra con đường gốc tự do cho phản ứng cắt liên kết C–I mới chưa công bố; và tìm descriptor có ý nghĩa hóa học chi phối độ chọn lọc của phản ứng nickel-catalysed migratory cross-coupling. Mã nguồn đã được mở; paper mới gửi Nature Communications và chưa bình duyệt.
Vì sao đáng chú ý: AI scientist chỉ hữu ích khi giả thuyết quay lại gặp dữ liệu hoặc phép tính có thể bác bỏ nó. ARCHE minh họa đúng cấu trúc đó—reasoner đề xuất, công cụ miền tạo bằng chứng, vòng lặp sửa kết luận—thay vì chỉ viết một lời giải thích nghe hợp lý.
Bài báo gốc và mã nguồn: arXiv 2609.11147
9. WORLDVIEW chỉ ra lớp tự viết lại prompt có thể tạo định kiến văn hóa
Đăng arXiv: 10/09/2026; xuất hiện trong danh sách mới ngày 11/09; được nhận tại EMNLP 2026
Nghiên cứu xây WORLDVIEW gồm 8.960 prompt, 15 ngôn ngữ và 31 cặp ngôn ngữ–bối cảnh để audit bước mà hệ thống text-to-image âm thầm viết lại prompt. Ba hệ thống được kiểm tra là DALL-E 3, Imagen 4 và GPT-Image-1.5.
So với baseline tiếng Anh không nêu bối cảnh, Mỹ là bối cảnh ít bị “đánh dấu” nhất; nhiều bối cảnh ngoài phương Tây và ngoài tiếng Anh bị bổ sung dấu hiệu văn hóa dày hơn, bị thu hẹp vào một vốn từ nhỏ và dễ rơi vào khuôn mẫu. Khi dùng model không có lớp rewrite để so ảnh từ prompt gốc và prompt đã sửa, nhóm tác giả xác định chính bước rewrite là một nguồn gây định kiến.
Vì sao đáng chú ý: Audit ảnh đầu ra không đủ để biết lỗi nằm ở model sinh ảnh hay lớp tiền xử lý. Nhà phát triển nên lưu và cho phép kiểm tra prompt sau rewrite, đặc biệt với chiến dịch đa thị trường; nếu không, một “tính năng làm rõ” vô hình có thể đồng nhất cả nền văn hóa thành vài biểu tượng dễ nhận diện.
10. Magenta nối lời giải tự nhiên với chứng minh Lean trong một vòng sửa lỗi
Đăng arXiv: 10/09/2026; xuất hiện trong danh sách mới ngày 11/09
Magenta là pipeline agent không cần huấn luyện thêm: nhận bài toán bằng ngôn ngữ tự nhiên, tạo đáp án, chuyển phát biểu sang Lean 4 rồi xây chứng minh máy kiểm tra. Một judge riêng xác minh phát biểu hình thức còn đúng ý bài gốc; judge khác phân loại thất bại là sai toán để làm lại lập luận hay chỉ là lỗi Lean để sửa cục bộ.
Nhóm tác giả báo cáo 100% trên các bộ olympiad được thử, gồm AIME 2025, AIME 2026 và HMMT tháng 02/2026; khi ghép với reasoner mở K2-Horizon-7B, hệ thống giải cả sáu bài IMO 2026. Phân tích ablation cho thấy kiểm tra đúng phát biểu là thiết yếu để tránh “chứng chỉ đúng cho một bài đã bị đổi nghĩa”.
Vì sao đáng chú ý: Formal verification không giúp nếu agent dịch sai câu hỏi trước khi chứng minh. Magenta đặt một lớp kiểm tra ngữ nghĩa giữa văn bản và Lean, đồng thời dùng lỗi của verifier để sửa đúng tầng. Kết quả rất cao và mới ở dạng preprint, nên cần tái lập độc lập trước khi xem là đã giải quyết bài toán olympiad tự động.