AI học dùng máy tính bằng cách xem YouTube — nhưng phần hay nhất không nằm ở chỗ nó xem
Một nhóm nghiên cứu cho AI xem video hướng dẫn trên YouTube, TikTok và Bilibili để học cách dùng 650 phần mềm. Model 27 tỷ tham số của họ hơn đối thủ cùng cỡ tới 25,6 điểm. Nhưng phát hiện đáng nhớ nhất lại là chuyện nó không tự dạy được chính mình. Kèm bốn biểu đồ dựng từ số liệu gốc.
Anh chị có bao giờ muốn làm một việc gì đó trên máy tính — tách một file PDF, sửa cái biểu đồ trong Excel cho đúng ý — rồi lên YouTube gõ "cách làm…" và ngồi xem một bạn nào đó bấm từng bước không ạ?
Em làm hoài. Và hoá ra, đó cũng là cách một nhóm nghiên cứu vừa dạy AI dùng máy tính.
Ngày 02/11, nhóm từ MMLab Đại học Trung Văn Hồng Kông, Đại học Thanh Hoa, HKUST (Quảng Châu) và Explore Academy của JD công bố CUA-Master — một hệ thống đi lùng video hướng dẫn trên YouTube, TikTok và Bilibili, rồi biến chúng thành bài học cho AI.
Nghe thì dễ thương. Nhưng em đọc hết bài báo, và phần làm em ngồi thẳng lưng lên không phải chỗ nó xem video.
Phần hay nhất là chỗ nó không chép lại video.
Em sẽ kể anh chị nghe. Và ở cuối bài có một phát hiện mà em nghĩ quan trọng hơn mọi điểm số trong bài báo — nó nói ngược lại cái câu "AI đang tự dạy nó thông minh lên" mà dạo này ai cũng nói.
1. Trước hết: vì sao phải đi xem video?
Muốn dạy AI dùng máy tính, anh chị cần cho nó xem hàng triệu ví dụ: màn hình đang thế này, thì bấm vào đâu.
Có hai cách lấy ví dụ, và cả hai đều có vấn đề.
Thuê người ngồi làm rồi ghi lại. Chất lượng cao, nhưng bài báo nói thẳng là chi phí quá lớn và phạm vi quá hẹp để làm ở quy mô lớn. Không ai đủ tiền thuê người bấm thử hết 650 phần mềm.
Để AI tự nghĩ ra bài tập cho mình. Rẻ hơn nhiều, và đang là mốt. Nhưng bài báo dùng một cụm từ em thấy rất đắt: đó là "tối ưu hoá trong thế giới đóng", và hậu quả là:
"Nó bị giới hạn bởi chính năng lực sẵn có, có thể củng cố thêm các thiên lệch phân bố, và cho lợi ích biên giảm dần."
Dịch sang tiếng người: một học sinh tự ra đề cho mình thì sẽ chỉ ra những đề mình biết làm. Càng ôn càng giỏi những thứ đã giỏi, còn chỗ dốt thì vẫn nguyên.
Video hướng dẫn trên mạng giải đúng bài toán đó. Chúng do người thật làm, trên phần mềm thật, để giải quyết vấn đề thật — và quan trọng nhất, chúng chứa những thứ mà model chưa biết là mình không biết.
2. Cách họ lọc video: kỹ hơn em tưởng nhiều
Em cứ nghĩ là tải đại vài chục nghìn video về cho máy xem. Không phải.
Họ dựng một bảng phân loại phần mềm gồm 8 nhóm lớn, 36 nhóm nhỏ, hơn 650 ứng dụng. Với mỗi ứng dụng, ghép tên nó với các từ khoá kiểu "tutorial", "how to", "guide" rồi đi tìm.
Rồi lọc qua nhiều tầng:
- Bỏ trùng theo nguồn và theo tiêu đề đã chuẩn hoá
- Cổng siêu dữ liệu: độ dài video, mới hay cũ, còn truy cập được không, có đúng ứng dụng không
- Lọc nhiễu: loại video quảng cáo, giải trí, dạy ngoại ngữ — những cái chỉ nhắc tên phần mềm chứ không thật sự thao tác
- Nghe lời giảng: dùng Whisper-Large-v3 phiên âm toàn bộ, có mốc thời gian
- Chấm điểm: một model mạnh hơn đóng vai giám khảo, cho điểm từ 0 đến 5 về việc video này có thực sự cho thấy thao tác máy tính rõ ràng và có dựng lại được từng bước không
Sau đó tới bước em thích: một video dài thường chứa nhiều bài học, xen lẫn phần vô dụng. Nên họ cắt nó ra, bỏ đoạn giới thiệu, đoạn quảng cáo, đoạn người dẫn ngồi nói chuyện trước camera, đoạn chiếu slide. Chỉ giữ lại những khoảng thấy rõ màn hình đang thay đổi.
Một video thành nhiều bài học độc lập. Như lấy một cuốn sách giáo khoa rồi tách ra thành từng bài tập riêng.
Hai con đường để biết "lúc nào thì bạn ấy bấm chuột"
Chỗ này em thấy thông minh và rất dễ hình dung.
Làm sao biết trong video, giây thứ bao nhiêu thì có một thao tác? Họ đi hai đường song song:
Đường nghe. Cắt lời giảng thành từng mệnh đề theo các từ nối — "rồi", "tiếp theo", "sau đó" — rồi tìm những mệnh đề có động từ thao tác: bấm, nhấn, cuộn, kéo.
Đường nhìn. Dùng FFmpeg đo độ thay đổi giữa các khung hình. Khi màn hình đổi mạnh — menu bung ra, hộp thoại hiện lên, trang chuyển — thì đánh dấu.
Rồi chỉ giữ lại những chỗ cả hai đường cùng chỉ vào, trong một khoảng thời gian ngắn.
Em thấy đây là nguyên tắc rất đời thường: một nhân chứng thì có thể nhầm, hai nhân chứng độc lập cùng kể một chuyện thì đáng tin hơn hẳn. Người nói "giờ ta bấm vào đây" mà màn hình không đổi gì thì có lẽ bạn ấy đang giải thích chứ chưa bấm. Màn hình đổi mà không ai nói gì thì có thể chỉ là quảng cáo tự chạy.
3. Và đây là phần hay nhất: nó không chép lại video
Nếu dừng ở bước trên, mình được một đống bản ghi "làm theo y hệt video". Hữu ích, nhưng hẹp — AI chỉ biết đúng những việc video đã dạy.
Nhóm này làm thêm một bước mà em nghĩ là ý tưởng trung tâm của cả bài báo.
Họ bẻ mỗi bài học ra thành những miếng ghép. Bài báo gọi là primitive — tạm hiểu là "một khả năng dùng lại được". Mỗi miếng ghép ghi rõ năm thứ: nó thuộc phần mềm nào, nó làm được gì, cần điều kiện gì trước đó, cần môi trường thế nào, và kiểm tra thế nào để biết đã làm xong.
Tất cả được gom vào một thư viện miếng ghép, xếp theo phần mềm. Miếng nào trùng ý nghĩa thì gộp lại; miếng nào nhìn giống nhưng khác điều kiện thì giữ riêng.
Rồi họ lắp lại thành việc mới — những việc chưa video nào dạy.
Và độ khó được chỉnh bằng đúng hai cái núm:
- K — bài này cần ghép bao nhiêu miếng
- N — trải qua bao nhiêu phần mềm
Vặn K = 5, N = 1 thì được một việc đơn giản trong một ứng dụng. Vặn K = 50, N = 8 thì được một việc dài lê thê bắc qua tám phần mềm.
Em ví thế này. Xem video hướng dẫn nấu phở thì mình học được cách nấu phở. Nhưng nếu mình tách ra thành "cách ninh xương", "cách chần bánh", "cách thái thịt" — thì mình nấu được bún bò, nấu được hủ tiếu, nấu được những món không ai quay video. Và muốn ra đề khó thì cứ thêm nguyên liệu, thêm nồi.
Đó là khác biệt giữa học thuộc và học hiểu. Một hệ thống chép lại video sẽ mãi bị giới hạn bởi số video có trên đời. Một hệ thống tách được miếng ghép thì không.
4. Mẹo "đừng làm lại từ đầu"
Có một vấn đề rất thực tế: khi AI thử làm những việc dài ngoằng như vậy, nó hay hỏng giữa chừng. Mà hỏng thì mất sạch.
Bài báo nói thẳng điều mà ai từng làm việc máy móc đều thấy quen:
"Vứt bỏ một lượt chạy hỏng rồi làm lại từ đầu là không hiệu quả, vì thất bại thường chỉ do một thao tác sai cục bộ, trong khi phần lớn đoạn trước đó vẫn còn dùng được."
Nên họ làm thế này: chụp ảnh trạng thái máy ảo ở những điểm ổn định. Khi thất bại, một model giám khảo xem lại và chỉ ra bước đầu tiên đi chệch. Hệ thống lùi về ảnh chụp ngay trước bước đó, giữ nguyên mọi thứ đã làm đúng, rồi chạy tiếp.
Giống như anh chị đang viết dở một văn bản dài mà lỡ tay xoá nhầm — thay vì gõ lại từ đầu, mình Ctrl+Z về đúng chỗ sai.
Kết quả thì khá ngoạn mục:
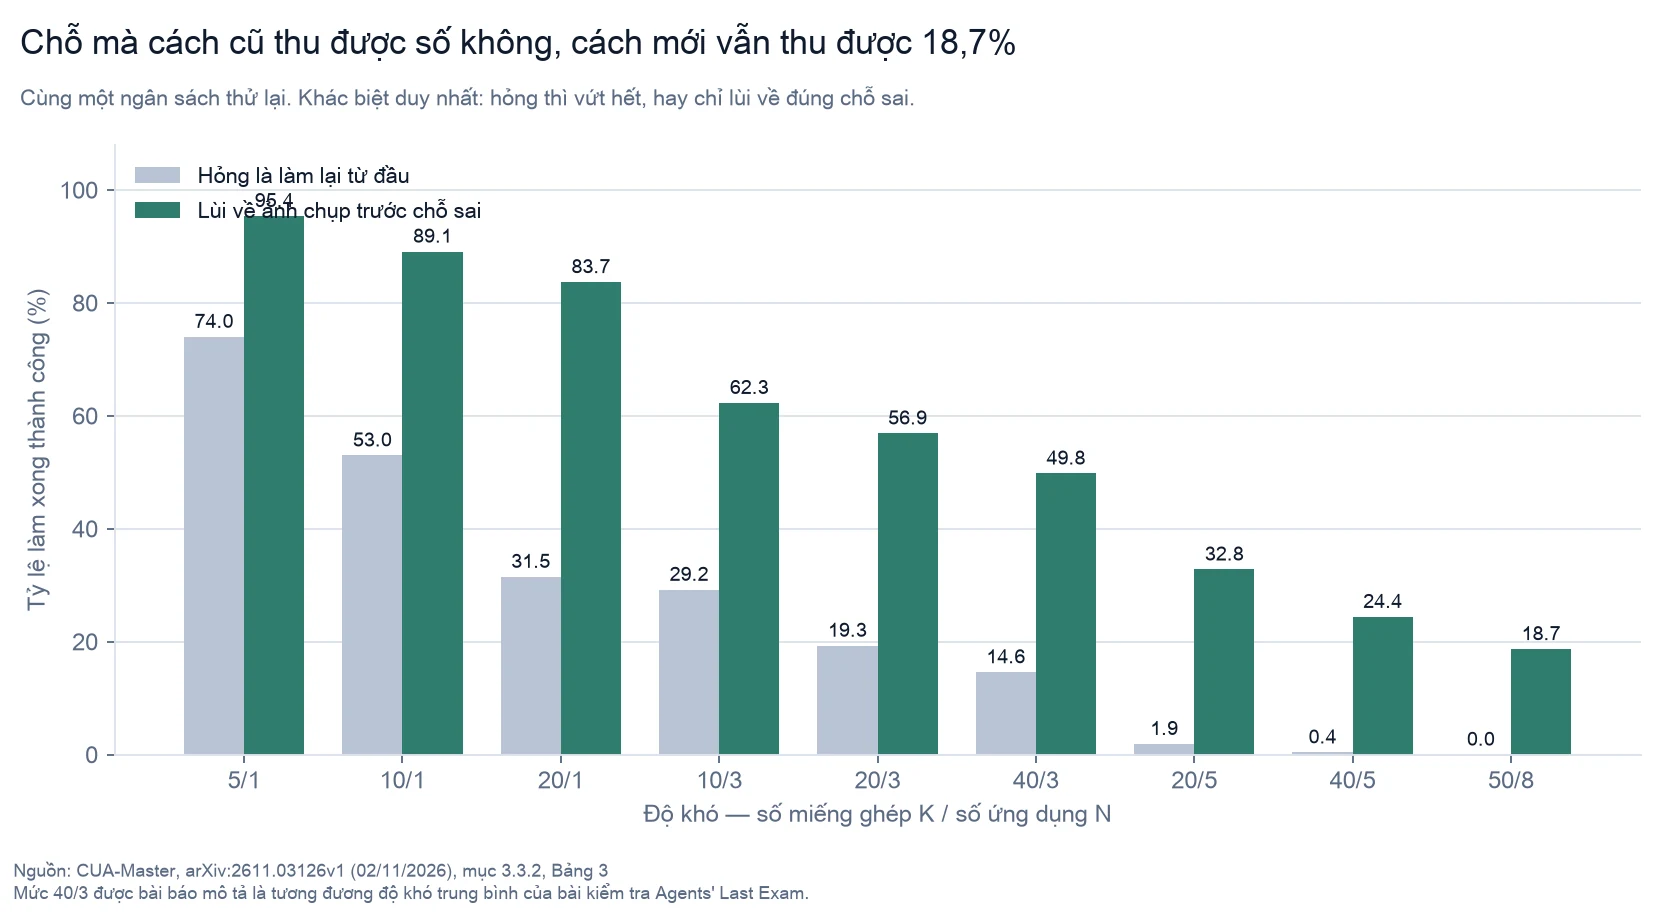
Ở mức khó nhất — ghép 50 miếng qua 8 phần mềm — cách làm cũ thành công 0%. Đúng số không. Cách mới vẫn 18,7%.
Nghĩa là: có những loại dữ liệu mà trước đây không thu thập được bằng bất cứ giá nào, giờ thu được.
Và có một chi tiết nhỏ em rất thích: khi giám khảo báo lỗi, nó mô tả cái sai nhưng không đưa đáp án. Vì nếu đưa luôn lời giải, AI sẽ học theo một kiểu mà lúc chạy thật nó không có ai mách. Dạy mà mớm đáp án thì học trò chỉ giỏi lúc có thầy ngồi cạnh.
5. Kết quả: nhỏ mà có võ
Model của họ, CUA-Master-27B, có 27 tỷ tham số — thuộc hàng nhỏ.
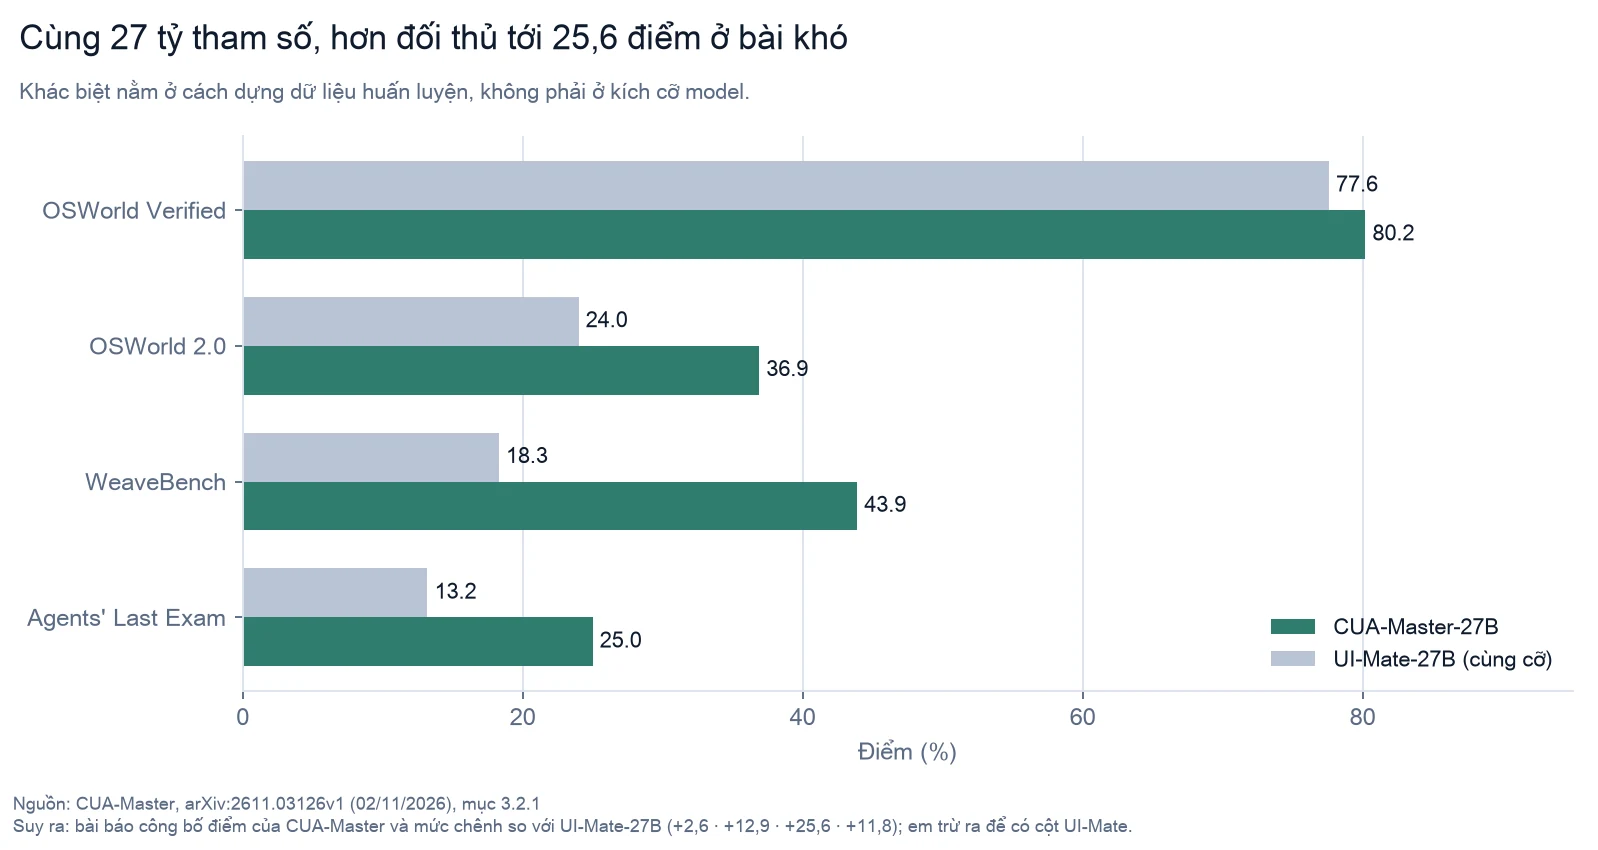
So với một model chuyên dụng cùng cỡ, nó hơn 2,6 · 12,9 · 25,6 · 11,8 điểm trên bốn bài kiểm tra. Riêng con số 25,6 là một khoảng cách rất lớn trong giới này.
Vài điểm nữa đáng chú ý:
- Trên bài khó nhất (Agents' Last Exam), nó chỉ thua GPT-5.6-Sol và Claude-Opus-5, vượt tất cả những cái tên còn lại.
- So với Qwen-CUA-397B — model lớn hơn nó gần 15 lần — nó ngang ngửa ở các bài giao diện, và vượt ở các bài hỗn hợp.
- Nó làm xong bài OSWorld Verified trong 8 phút với điểm 80,2; và ở các bài khác, nó đạt điểm tương đương các model lớn nhưng nhanh hơn 24–36%.
Và nó học trên Linux, nhưng:
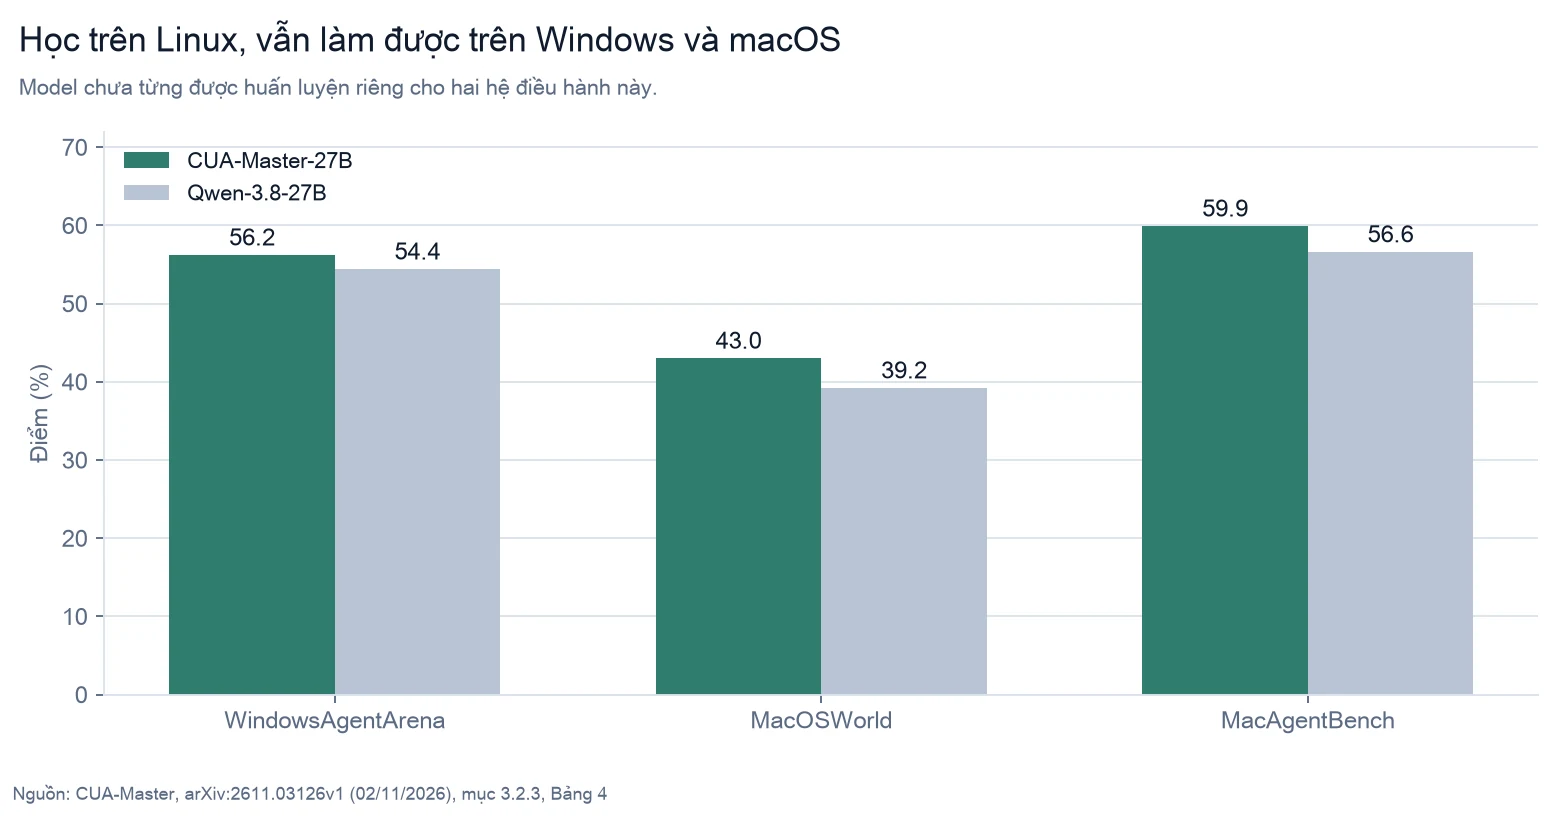
Vẫn làm được trên Windows và macOS, và tốt hơn đối thủ cùng cỡ trên cả ba bài.
Model, mã nguồn và trang dự án đều công khai trên Hugging Face và GitHub.
6. Con số bất ngờ nhất cả bài: 6,6 lên 43,9
Cái này nằm ở một mục nhỏ gần cuối bài báo, và em nghĩ nó xứng đáng được nói to hơn.
Họ thử cùng một model, cùng một bộ đề, chỉ đổi những gì nó được phép làm:
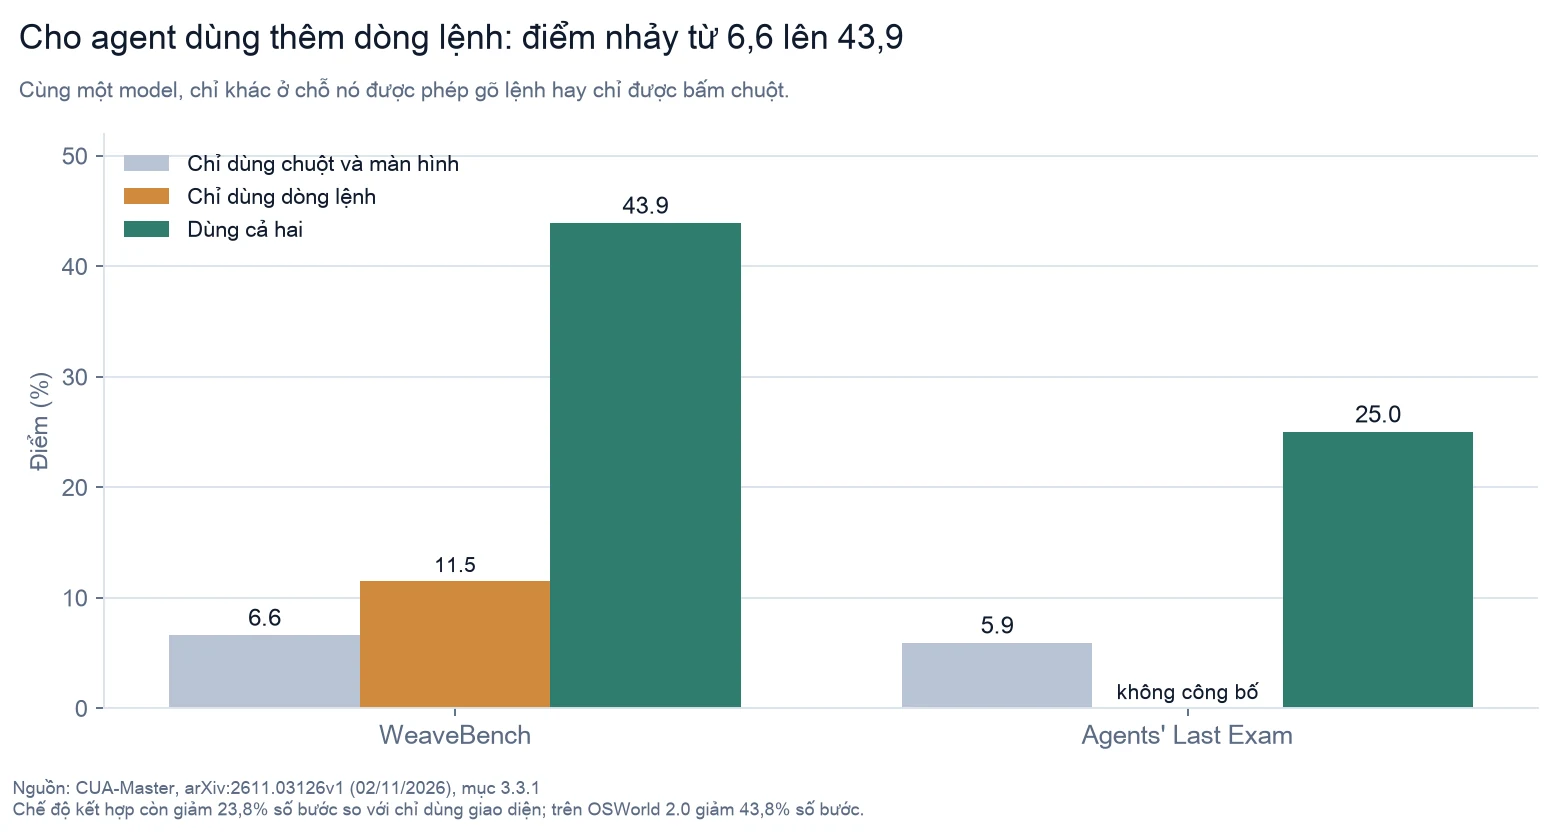
- Chỉ được bấm chuột và nhìn màn hình: 6,6 điểm
- Chỉ được gõ dòng lệnh: 11,5 điểm
- Được dùng cả hai: 43,9 điểm
Không phải cộng lại. Là gấp gần bảy lần cái tốt nhất trong hai cái riêng lẻ. Mà còn ít hơn 23,8% số bước.
Trên một bài khác, điểm nhảy từ 5,9 lên 25,0.
Lý do, khi nghĩ kỹ, rất đời: có những việc bấm chuột là ngớ ngẩn — đổi tên hai trăm file chẳng hạn, gõ một dòng lệnh là xong. Nhưng có những việc lại bắt buộc phải nhìn: "cái biểu đồ này trông đã ổn chưa?" thì không dòng lệnh nào trả lời được.
AI giỏi lên không phải vì nó nghĩ giỏi hơn, mà vì nó được chọn công cụ đúng với việc. Hệt như con người.
7. Chỗ nó không dẫn đầu — và đây mới là phần quan trọng nhất
Em luôn đi tìm phần này, vì một bài phân tích chỉ toàn khen thì là quảng cáo.
Bài báo có hẳn một mục tự nêu hạn chế, và có hai điều.
Thứ nhất: tốn kém kinh khủng. Hệ thống này cần hạ tầng chạy hơn 2.000 máy ảo cùng lúc, hơn 100 môi trường khác nhau. Chính họ viết rằng cơ chế chụp-ảnh-lùi-lại tuy hiệu quả nhưng "đòi hỏi hỗ trợ quy mô lớn cho việc triển khai máy ảo, gây khó khăn về hạ tầng". Đây không phải thứ một nhóm nhỏ làm được.
Thứ hai — và đây là điều em muốn anh chị nhớ nhất:
"Giới hạn trên của chất lượng dữ liệu tổng hợp phụ thuộc vào các model chú giải đủ mạnh, với những model chú giải mạnh hơn luôn mang lại mức cải thiện lớn hơn."
Nói cách khác: con AI này giỏi lên là nhờ có một con AI khác, mạnh hơn, đứng ra làm thầy. Nó chấm điểm video, nó cắt bài học, nó nhận diện thao tác, nó chỉ ra chỗ sai.
Và nhóm nghiên cứu đã thử cho nó tự làm thầy cho mình — lấy model của vòng huấn luyện này đi chú giải dữ liệu cho vòng sau. Kết quả, theo đúng lời họ: "có mang lại một số cải thiện, nhưng mức tăng khá hạn chế."
Em thấy chỗ này quan trọng vì dạo này mình nghe nhiều câu kiểu "AI đang tự tiến hoá", "AI tự dạy nhau thông minh lên". Bài báo này, bằng chính thí nghiệm của mình, cho thấy điều ngược lại: vòng lặp tự dạy mình thì chạy chậm dần. Muốn tiến thật, phải có kiến thức mới từ bên ngoài đổ vào — mà ở đây, "bên ngoài" là video do con người quay, và một người thầy giỏi hơn.
8. Chuyện này liên quan gì tới anh chị?
Agent điều khiển máy tính đang tiến rất nhanh, và tiến theo hướng rẻ đi. Một model 27 tỷ tham số, mã nguồn mở, ai cũng tải được, đã làm được những việc mà một năm trước phải là model khổng lồ mới làm nổi.
Thứ đáng nghĩ không phải "AI có thay thế mình không", mà là mình cho nó quyền tới đâu trên máy của mình. Một con agent bấm được chuột và gõ được lệnh thì nó làm được mọi thứ tài khoản của anh chị làm được — kể cả xoá nhầm.
Và nếu anh chị có làm video hướng dẫn: những video đó đang là dữ liệu huấn luyện. Bài báo ghi rõ ba nguồn là YouTube, TikTok và Bilibili. Em nêu ra như một thông tin, không phán xét gì — nhưng người làm nội dung nên biết.
Nếu chỉ nhớ một điều
Em chọn: AI này không tự dạy được chính nó.
Nó giỏi lên nhờ hai thứ, và cả hai đều đến từ bên ngoài: video do người thật quay, và một model mạnh hơn làm thầy. Khi họ bỏ cả hai đi và bắt nó tự xoay xở, mức tiến bộ "khá hạn chế" — chữ của chính họ.
Lần tới anh chị nghe ai nói AI đang tự nhân bản trí tuệ của nó lên vô hạn, em mời anh chị nhớ lại mục 7 của bài này. Cái bánh đà chỉ quay được khi có người ở ngoài đẩy vào.
Ghi chú nguồn
Lấy trực tiếp từ nguồn gốc: toàn bộ số liệu, mô tả phương pháp và các câu trích trong bài đều từ báo cáo CUA-Master, arXiv:2611.03126v1, công bố 02/11/2026 — em đọc bản HTML đầy đủ trên arXiv, không dừng ở phần tóm tắt. Các mục cụ thể: 2.3 (lọc video và khai thác bài học), 2.4 (miếng ghép và chụp-ảnh-lùi-lại), 3.2 (kết quả và hiệu suất), 3.3.1 (so sánh ba chế độ thao tác), 3.3.2 (Bảng 3, tỷ lệ thành công), và Phụ lục E (hạn chế).
Nhóm tác giả thuộc MMLab Đại học Trung Văn Hồng Kông, Đại học Thanh Hoa, HKUST (Quảng Châu) và Explore Academy của JD. Model công bố tại Hugging Face, mã nguồn tại GitHub.
Biểu đồ dựng từ đâu: cả bốn biểu đồ vẽ từ đúng các con số trong báo cáo, không nội suy, không làm tròn, không ước lượng. Chân mỗi biểu đồ ghi nguồn và số mục.
Con số em tự tính, không phải trích: cột UI-Mate-27B trong biểu đồ thứ hai là em trừ ra — báo cáo công bố điểm của CUA-Master và mức chênh lệch (+2,6 · +12,9 · +25,6 · +11,8), không in riêng điểm của UI-Mate. Em ghi rõ điều này ngay dưới biểu đồ.
Chưa xác minh được: đây là bản tiền ấn phẩm (preprint) trên arXiv, chưa qua bình duyệt. Mọi kết quả là do chính nhóm tác giả tự chạy và tự báo cáo; em không tìm thấy bên thứ ba nào kiểm chứng độc lập các con số này. Em cũng không chạy thử model. Khi nào có đánh giá độc lập, em sẽ cập nhật.