DeepSeek V4.1 Flash: model cả thế giới dùng nhiều nhất, và chỗ anh chị không nên dùng nó
Phân tích sâu model mã nguồn mở đang đứng đầu OpenRouter với 73,4 nghìn tỷ token — gấp 11 lần Claude Opus 5.5. Vì sao DeepSeek tự khai tử model đầu bảng của mình, kiến trúc bất đối xứng khiến nó rẻ đến thế, và một con số trong bảng đánh giá mà ai dùng nó cũng nên biết. Kèm sáu biểu đồ dựng từ số liệu gốc.
Tháng 9 vừa rồi, DeepSeek làm một việc mà các hãng AI gần như không bao giờ làm.
Họ khai tử model đầu bảng của chính mình.
Không phải vì nó hỏng. Không phải vì hết tiền nuôi. Mà vì, theo đúng lời họ viết trong thông cáo:
"Nhiều bên thử nghiệm đều cho thấy V4.1-Flash vượt V4-Pro về hiệu năng, chi phí, tốc độ và tổng thời gian hoàn thành. Chúng tôi đang loại bỏ dần V4-Pro."
V4-Pro là model cao cấp của họ, mới ra mắt chính thức ngày 13/08/2026. Năm tuần sau, model rẻ tiền nhất nhà đánh bại nó. Và từ 04:00 UTC ngày 14/09, mọi yêu cầu gửi tới V4-Pro đều được chuyển sang V4.1-Flash, tính theo giá của Flash — tức là rẻ hơn, cho khách hàng đã trả tiền để dùng bản đắt.
Hai tháng sau, cái model rẻ tiền đó trở thành model được dùng nhiều nhất thế giới.
Nhưng nếu anh chị đọc hết bài này, em nghĩ điều anh chị nhớ lâu nhất sẽ không phải con số 73 nghìn tỷ token. Mà là con số 1 — ở mục 5.
1. Nó đang dẫn đầu, và không phải dẫn đầu sít sao
OpenRouter là cái chợ lớn nhất để các lập trình viên gọi model AI. Họ công khai lượng token thực tế chạy qua hệ thống. Đây là bảng tính đến ngày 06/11/2026:
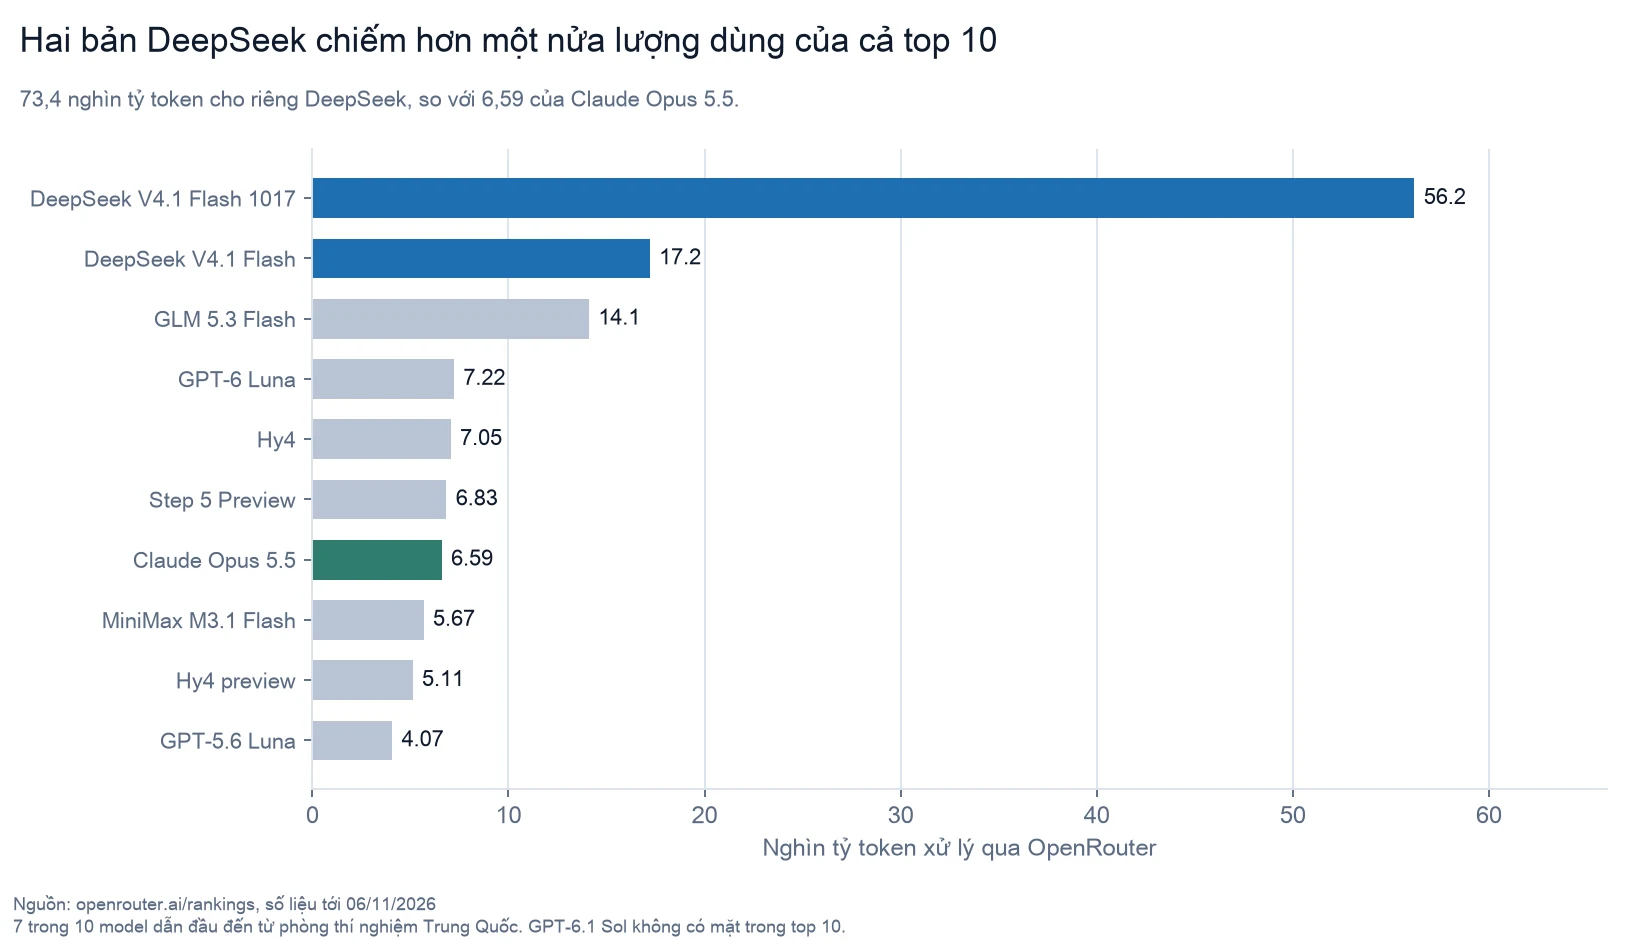
Hai bản DeepSeek V4.1 Flash cộng lại: 73,4 nghìn tỷ token. Claude Opus 5.5 đứng thứ bảy với 6,59 nghìn tỷ.
Gấp mười một lần.
Và GPT-6.1 Sol — model mà cả giới công nghệ đang bàn tán, em vừa phân tích tối nay — không có mặt trong top 10.
Thêm một điều em thấy khi nhìn cột tên hãng: bảy trong mười model dẫn đầu đến từ các phòng thí nghiệm Trung Quốc. DeepSeek hai bản, z-ai một, Tencent hai, StepFun một, MiniMax một. Ba cái tên Mỹ còn lại là OpenAI hai và Anthropic một.
2. Nghịch lý: dùng nhiều nhất, nhưng không giỏi nhất
Nếu chỉ dừng ở bảng trên, anh chị sẽ nghĩ DeepSeek V4.1 Flash là model mạnh nhất hiện nay. Không phải.
Trên bảng đo của Artificial Analysis — bên thứ ba chạy cùng chín bài đánh giá cho mọi model — ở mức nỗ lực cao nhất của mỗi bên:
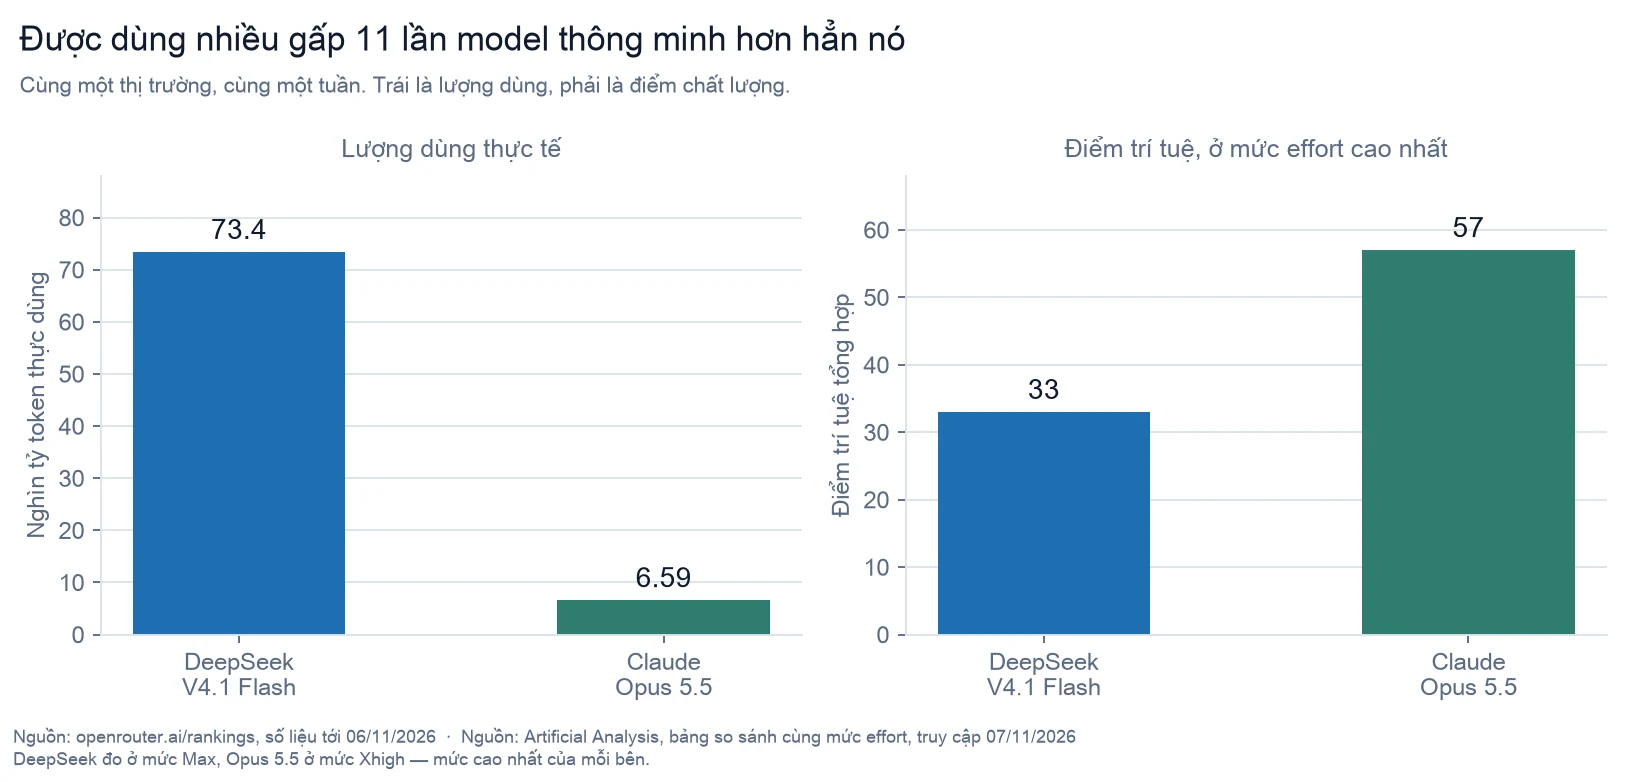
33 điểm, so với 57 của Claude Opus 5.5 và 55 của GPT-6.1 Sol.
Vậy là: model được dùng nhiều gấp mười một lần lại kém hơn một phần ba về chất lượng. Mà người dùng ở đây không phải người ngoài ngành — họ là lập trình viên, trả tiền bằng thẻ của chính mình, và chuyển model chỉ mất một dòng cấu hình.
Nghĩa là họ biết rõ nó kém hơn, và vẫn chọn nó.
Câu hỏi hay không phải "model nào giỏi nhất". Câu hỏi hay là: họ đang làm loại việc gì mà 33 điểm là đủ?
3. Vì sao nó rẻ đến vậy: kiến trúc đọc nhiều hơn viết
Phần này hơi kỹ thuật, nhưng em thấy nó là ý tưởng hay nhất trong cả câu chuyện, nên em cố kể cho dễ hiểu.
Báo cáo kỹ thuật của DeepSeek mở đầu bằng một nhận xét về cách công việc đã thay đổi:
"Việc các agent chạy dài được dùng rộng rãi đã khiến khối lượng công việc của model ngày càng nghiêng về phía đầu vào."
Anh chị để ý sẽ thấy đúng. Một con agent viết code hiện đại đọc cả kho mã nguồn, đọc log, đọc tài liệu, đọc kết quả chạy thử — rồi viết ra vài chục dòng sửa. Nó đọc gấp hàng chục lần những gì nó viết.
Nhưng model truyền thống thì dùng cùng một bộ não cho cả hai việc. Đọc một triệu token cũng huy động đủ số tham số như khi viết ra một câu.
DeepSeek làm điều mà em thấy là hiển nhiên khi đã nghe rồi, nhưng chưa ai làm: tách đôi ra.
Kiến trúc mới của họ tên là Causal Encoder–Decoder. Model có tổng cộng 552 tỷ tham số, nhưng:
- Khi đọc đầu vào, nó chỉ kích hoạt 8 tỷ tham số mỗi token.
- Khi viết đầu ra, nó kích hoạt 16 tỷ.
Đọc bằng nửa bộ não, viết bằng cả bộ não.
Em ví thế này: một luật sư đọc lướt ba trăm trang hồ sơ để tìm chỗ bất thường, rồi mới ngồi xuống tập trung hết sức viết hai trang kết luận. Đọc lướt và viết kết luận không cần cùng một mức tập trung — mà phần lớn thời gian là đọc lướt. Trả lương cho toàn bộ thời gian theo mức "viết kết luận" thì phí.
Và chỗ tiết kiệm thứ hai: bộ nhớ đệm
Khi model đọc một đoạn dài, nó phải ghi nhớ đoạn đó dưới dạng một bảng gọi là KV cache. Bảng này ngốn bộ nhớ khủng khiếp, và chính DeepSeek nói thẳng:
"Phí tính cho phần cache thường chiếm một phần lớn chi phí của agent. Nén bộ đệm lại sẽ cắt giảm đáng kể chi phí đó."
Họ nén bằng hai kỹ thuật — dùng lại bộ đệm giữa các tầng, và lưu bộ đệm ở định dạng FP4 thay vì định dạng lớn hơn. Kết quả, ghi trong báo cáo:
890 byte cho mỗi token.
Để anh chị hình dung: cả một triệu token ngữ cảnh — khoảng 1.500 trang A4 — chỉ chiếm chưa tới 900 megabyte bộ nhớ. Vừa một chiếc USB cũ.
So với đời trước, bộ đệm thường trú chỉ còn một phần tư, phần lưu trên ổ cứng còn một phần tám.
Đó là toàn bộ lý do giá rẻ. Không phải phép màu, không phải bán lỗ lấy thị phần. Là kỹ thuật.
(Vài thông số khác cho anh chị nào quan tâm: model được huấn luyện trên kho dữ liệu đa phương thức 45 nghìn tỷ token, hỗ trợ ngữ cảnh 1 triệu token, đầu ra tối đa 384 nghìn token — nhiều hơn hẳn mức 128 nghìn của Opus 5.5 và Sol — và có thị giác, đọc được ảnh. Bản V4-Pro bị khai tử thì không đọc được ảnh.)
4. Giá chính thức, và ba lần rẻ hơn
Bảng giá DeepSeek công bố, tính cho mỗi triệu token:
| Giờ thấp điểm | Giờ cao điểm | |
|---|---|---|
| Đầu vào, trúng cache | 0,003 USD | 0,006 USD |
| Đầu vào, trượt cache | 0,15 USD | 0,30 USD |
| Đầu ra | 0,60 USD | 1,20 USD |
Đặt cạnh hai model trong bài phân tích tối nay, lấy mức cao điểm cho công bằng:
| DeepSeek | GPT-6.1 Sol | Claude Opus 5.5 | |
|---|---|---|---|
| Đầu vào | 0,30 USD | 2,00 USD | 4,00 USD |
| Đầu ra | 1,20 USD | 10,00 USD | 20,00 USD |
| Đọc cache | 0,006 USD | 0,10 USD | 0,20 USD |
Khoản đọc cache là chỗ chênh lệch dữ dội nhất: DeepSeek rẻ hơn Sol gần 17 lần, rẻ hơn Opus 5.5 hơn 33 lần. Mà với agent chạy dài, đọc cache chính là khoản chiếm phần lớn hoá đơn.
Nhưng đây là cái bẫy — cùng cơ chế em vừa gặp, chạy ngược chiều
Trong bài về Opus 5.5 và Sol, em phát hiện ra rằng chênh lệch giá niêm yết không bằng chênh lệch hoá đơn thật, vì model đắt tiền "nghĩ" nhiều hơn nên đốt nhiều token hơn.
Lần này, cũng cơ chế đó, nhưng quay ngược lại — và lần này nó hại DeepSeek:
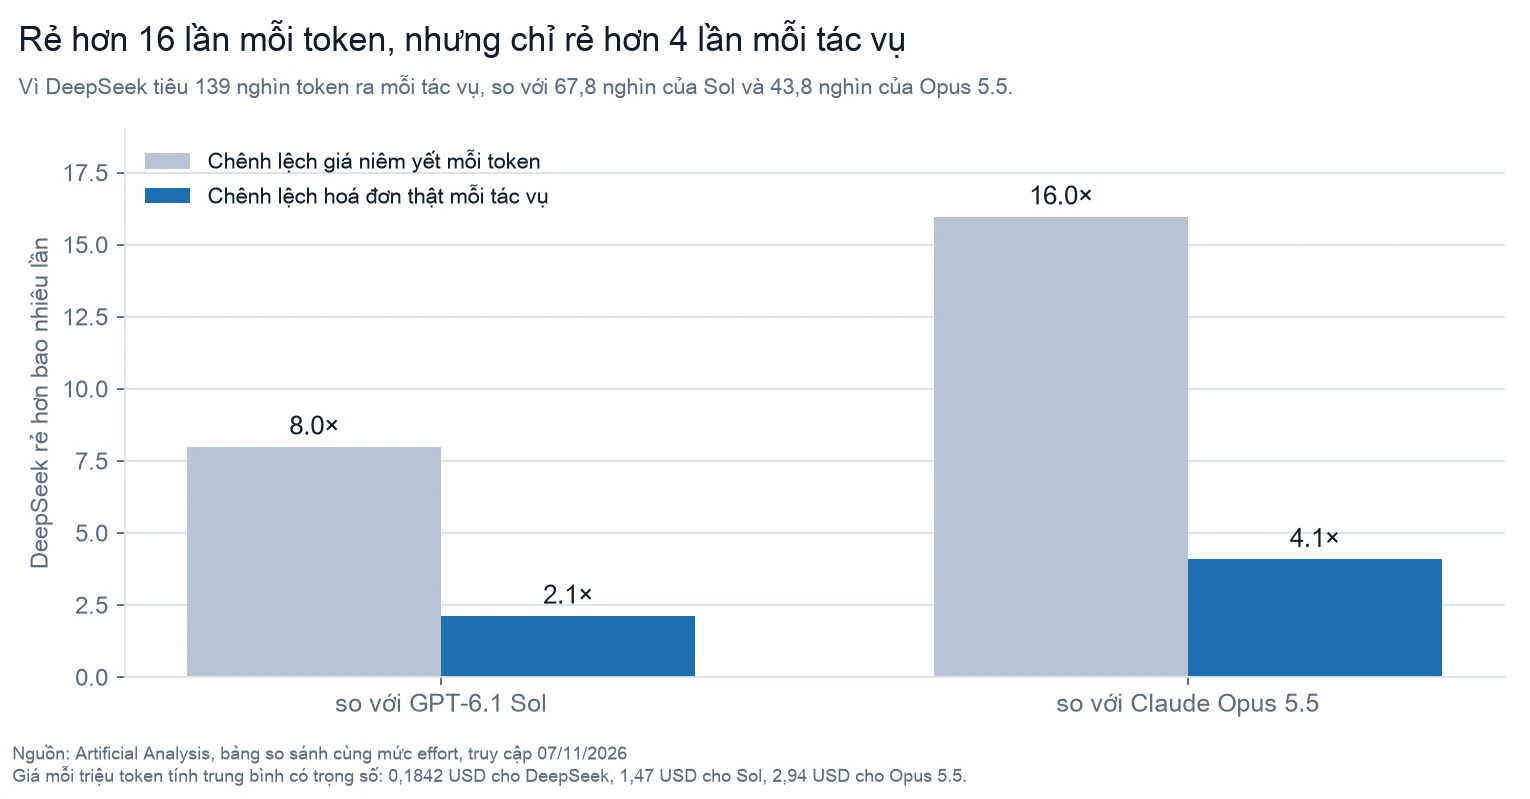
Tính theo giá mỗi token, DeepSeek rẻ hơn Opus 5.5 16 lần. Nhưng tính theo hoá đơn thật cho mỗi tác vụ, chỉ còn rẻ hơn 4 lần. So với Sol, giá token rẻ hơn 8 lần, nhưng hoá đơn chỉ rẻ hơn 2,1 lần.
Vì sao? Vì để giải xong cùng một tác vụ, DeepSeek tiêu 139 nghìn token đầu ra, trong đó 90,6 nghìn là token suy luận nội bộ. Sol tiêu 67,8 nghìn. Opus 5.5 chỉ tiêu 43,8 nghìn.
Nó rẻ, nhưng nó nói nhiều gấp ba lần mới ra được kết quả.
Và tiêu nhiều token thì mất thời gian: 14,4 phút mỗi tác vụ, so với 6,8 phút của Opus 5.5. Chậm hơn gấp đôi.
(Có một điểm nó thắng rõ: thời gian tới chữ đầu tiên chỉ 1,42 giây, trong khi Opus 5.5 mất gần 20 giây. Nếu anh chị làm sản phẩm mà người dùng ngồi nhìn màn hình chờ, cảm giác "nó phản hồi ngay" này đáng giá hơn nhiều con số khác.)
5. Nó giỏi cái gì, dở cái gì — và con số 1
Đây là phần em nghĩ quan trọng nhất bài.
Chín bài đánh giá của Artificial Analysis, DeepSeek và GPT-6.1 Sol đều ở mức nỗ lực cao nhất:
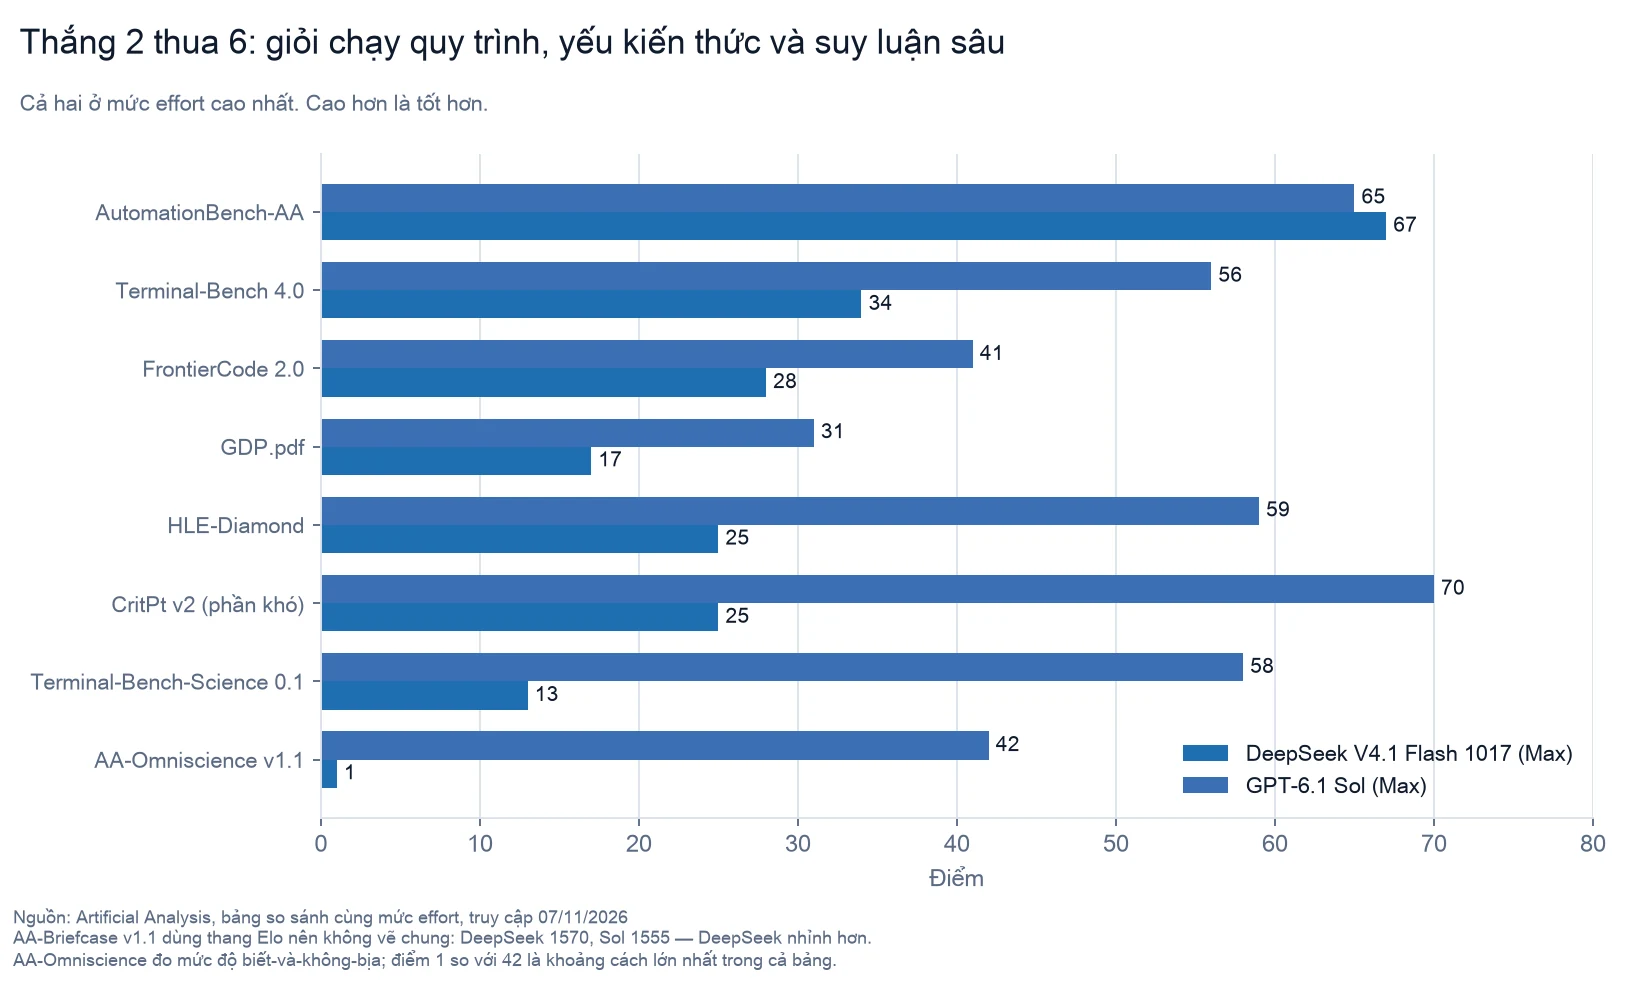
Chỗ nó thắng — và thắng thật, không phải ăn may:
- AutomationBench-AA (chạy quy trình nghiệp vụ qua nhiều công cụ): 67%, hơn Sol (65%) và hơn cả Opus 5.5 (65%). Trong ba model, DeepSeek đứng nhất.
- AA-Briefcase (mô phỏng công việc văn phòng): 1570 Elo, hơn Sol (1555), kém Opus 5.5 (1760).
Chỗ nó thua, và thua rất xa:
- Terminal-Bench-Science: 13% so với 58% của Sol
- CritPt v2 phần khó: 25% so với 70%
- HLE-Diamond: 25% so với 59%
- GDP.pdf (đọc tài liệu phức tạp): 17% so với 31%
Nhìn vào đó thì ranh giới hiện ra rất rõ, và nó trả lời đúng câu hỏi em đặt ở mục 2:
Việc cần chạy đúng quy trình, gọi đúng công cụ, lặp đi lặp lại → DeepSeek làm tốt ngang hoặc hơn model đắt gấp mười sáu lần. Việc cần biết nhiều và suy luận sâu → nó kém xa, không phải kém chút ít.
Mà công việc phổ biến nhất của lập trình viên trên OpenRouter chính là loại thứ nhất. Đó là lời giải cho nghịch lý.
Và giờ là con số 1
Trong chín bài đó có một bài tên AA-Omniscience. DeepSeek V4.1 Flash được 1 điểm. Sol được 42. Opus 5.5 được 43.
Em phải tra kỹ xem thang điểm này nghĩa là gì trước khi dám viết, và đây là định nghĩa của chính Artificial Analysis:
"Điểm đo độ tin cậy về kiến thức và mức độ bịa đặt. Nó thưởng cho câu trả lời đúng, phạt khi model bịa, và không phạt khi model từ chối trả lời. Thang điểm từ -100 đến 100, trong đó 0 nghĩa là số câu đúng bằng số câu sai."
Xin anh chị đọc lại: 0 nghĩa là đúng bao nhiêu thì sai bấy nhiêu.
DeepSeek được 1.
Nghĩa là khi hỏi nó một câu cần kiến thức, và nó chịu trả lời, thì xác suất nó nói đúng gần như ngang với xác suất nó bịa ra một câu nghe rất thuyết phục. Nó lại không có thói quen nói "tôi không biết" — vì nếu có, điểm đã cao hơn do phần từ chối không bị phạt.
Và đây là chỗ nguy hiểm thật sự: con số này không hề lộ ra khi dùng. Một model bịa chuyện vẫn viết trôi chảy, vẫn tự tin, vẫn đúng văn phạm. Anh chị chỉ phát hiện khi đi kiểm chứng — mà phần lớn người dùng thì không kiểm chứng.
Em nói thẳng: đừng dùng model này để hỏi sự thật. Hỏi luật, hỏi thuốc, hỏi số liệu, hỏi lịch sử, hỏi quy định — đừng. Dùng nó để chạy việc, nơi kết quả đúng hay sai nhìn là biết ngay: code chạy được hay không, API trả về đúng hay không, file có đúng định dạng hay không.
6. "Mã nguồn mở" thực ra đem lại cái gì
Model này phát hành theo giấy phép MIT trên Hugging Face — giấy phép dễ chịu nhất trong giới, cho dùng thương mại thoải mái, không ràng buộc.
Nhưng thứ thay đổi đời sống thực tế không phải chuyện anh chị tải về chạy. Rất ít người có nổi dàn máy cho một model 552 tỷ tham số — chính DeepSeek còn rao trên trang chủ: "Đang tính triển khai quy mô lớn với 2.000 GPU và một cụm lưu trữ? Nói chuyện với chúng tôi."
Thứ thay đổi thật sự là: có nhiều người bán.
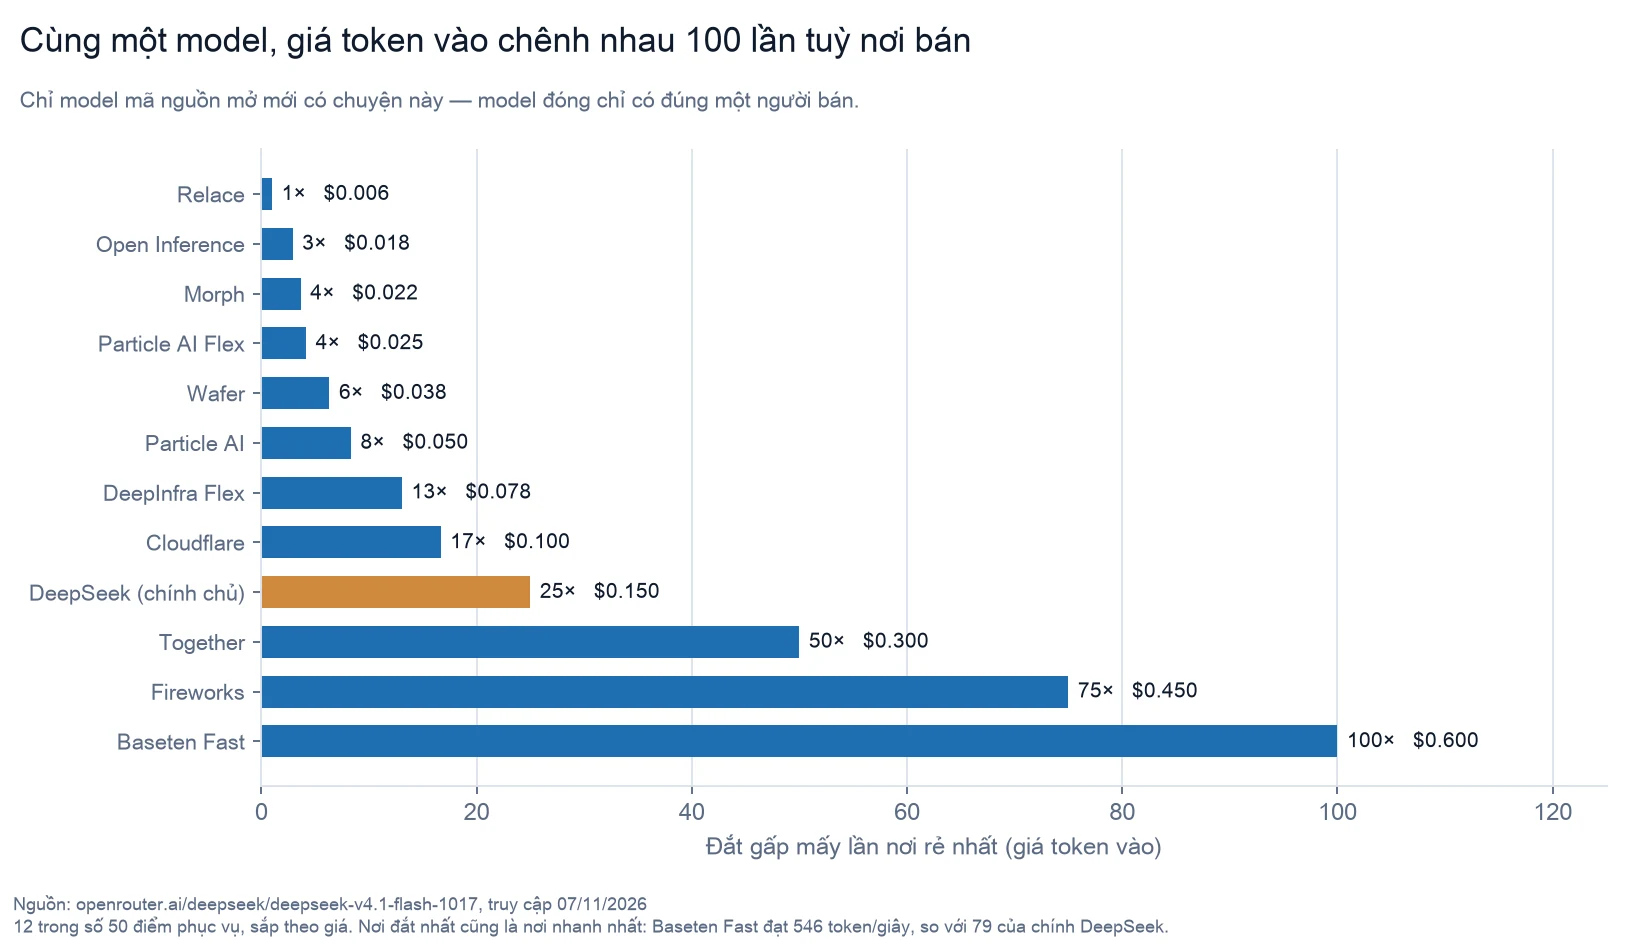
Trên OpenRouter, model này được phục vụ bởi 40 nhà cung cấp, qua 50 điểm bán khác nhau. Và giá thì:
- Rẻ nhất: 0,006 USD mỗi triệu token vào (Relace)
- Đắt nhất: 0,60 USD (Baseten Fast)
Chênh nhau một trăm lần. Cùng một model, cùng bộ trọng số.
Tốc độ cũng chênh: từ 54 token/giây tới 546 token/giây — mười lần. Và nơi đắt nhất đúng là nơi nhanh nhất, nên đây không phải chuyện ai lừa ai, mà là một cái chợ thật với nhiều mức dịch vụ.
Chi tiết em thấy thú vị nhất: chính DeepSeek không phải nơi rẻ nhất, cũng không phải nơi nhanh nhất. Endpoint của họ bán 0,15 USD và chạy 79 token/giây — đắt gấp 25 lần nơi rẻ nhất, và chậm hơn bảy lần nơi nhanh nhất.
Với Opus 5.5 hay Sol thì chuyện này không tồn tại. Chỉ có đúng một người bán, một giá, một tốc độ. Đó mới là ý nghĩa thực tế của "mã nguồn mở" với người dùng bình thường: không phải tự do sửa model, mà là quyền được chọn người bán.
7. Một mẹo chỉ dân Việt Nam mới thấy rõ
DeepSeek tính giá theo giờ cao điểm và thấp điểm, thấp điểm bằng đúng một nửa. Giờ họ công bố là 01:00–04:00 và 06:00–10:00 UTC, từ thứ Hai đến thứ Sáu.
Em quy đổi sang giờ Việt Nam:
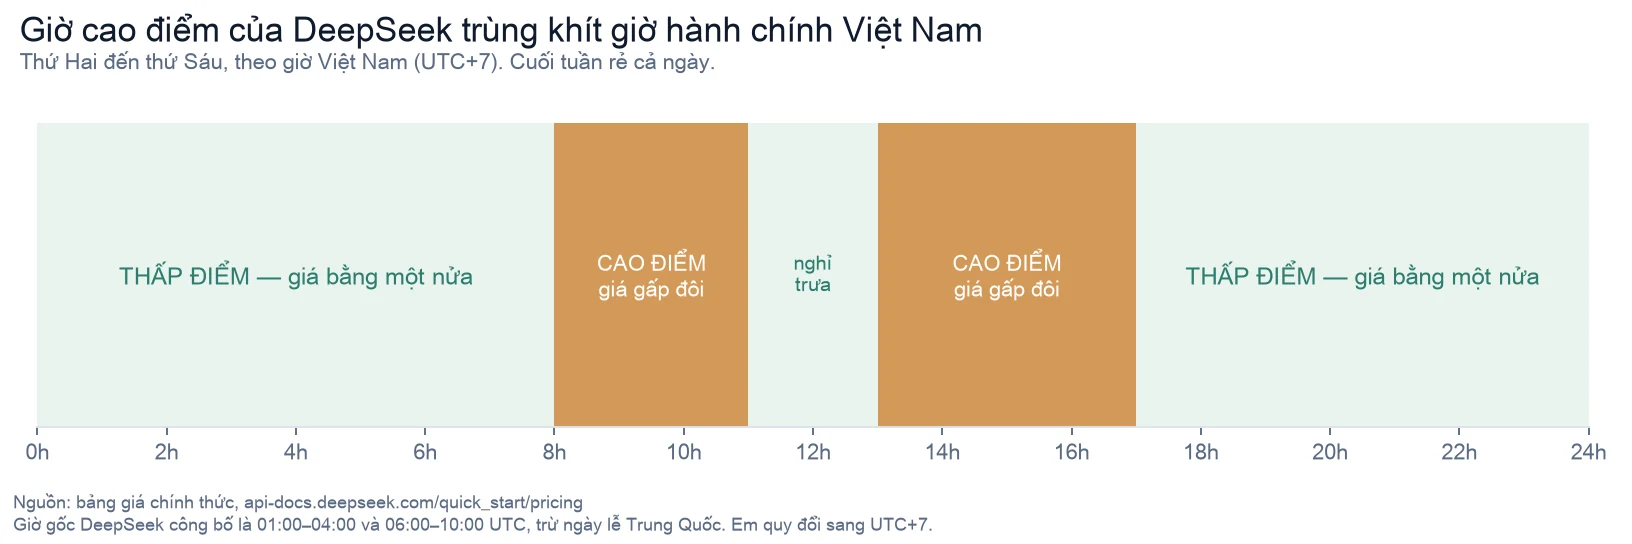
Giờ cao điểm của DeepSeek trùng khít giờ hành chính Việt Nam. Tám giờ sáng tới mười một giờ, rồi một giờ chiều tới năm giờ chiều. Đúng ca làm việc.
Nhưng nhìn kỹ thì có ba khoảng vàng:
- 11h–13h — giờ nghỉ trưa, giá rẻ một nửa
- Sau 17h tới 8h sáng hôm sau — rẻ một nửa
- Cả thứ Bảy và Chủ nhật — rẻ một nửa, suốt ngày
Nếu anh chị có việc chạy hàng loạt mà không cần gấp — xử lý dữ liệu, dịch tài liệu, tóm tắt kho văn bản — hẹn nó chạy lúc bảy giờ tối hoặc sáng Chủ nhật là tiết kiệm đúng một nửa, không phải đổi gì cả.
(Một lưu ý: DeepSeek ghi rõ ngày lễ Trung Quốc được tính là thấp điểm trọn ngày. Nên dịp Quốc khánh hay Tết Nguyên đán của họ, giá rẻ cả tuần.)
8. Vậy nên dùng khi nào?
Nên dùng DeepSeek V4.1 Flash khi:
- Việc là chạy quy trình: gọi công cụ, xử lý hàng loạt, tự động hoá các bước lặp. Đây là chỗ nó thắng cả Opus 5.5.
- Anh chị chạy rất nhiều lượt và tiền là ràng buộc thật.
- Ngữ cảnh dài — một triệu token, và khoản đọc cache rẻ hơn 17–33 lần.
- Cần đầu ra rất dài: 384 nghìn token, gấp ba các model kia.
- Cần phản hồi xuất hiện ngay trước mặt người dùng.
- Anh chị kiểm chứng được kết quả bằng máy — chạy thử, so khớp, kiểm định dạng.
Đừng dùng nó khi:
- Câu trả lời là một sự thật mà người đọc sẽ tin và không kiểm lại. Nhớ con số 1.
- Việc cần suy luận sâu — toán khó, khoa học, phân tích nhiều tầng.
- Việc cần đọc hiểu tài liệu phức tạp chính xác (17% so với 31% của Sol).
- Anh chị trả tiền theo kết quả chứ không theo token. Lúc đó cái lợi 16 lần co lại còn 4 lần, mà chất lượng thì kém hẳn.
Cho anh chị không phải lập trình viên: nếu dùng qua ứng dụng DeepSeek miễn phí, điều duy nhất cần nhớ trong cả bài này là mục 5. Nó viết hay, nó chạy nhanh, nó miễn phí — và nó bịa cũng ngang với lúc nó đúng khi anh chị hỏi về sự thật. Việc gì cần đúng thì kiểm lại ở nguồn khác.
Nếu chỉ nhớ một con số
Em chọn số 1.
Không phải 73 nghìn tỷ token, không phải 100 lần chênh giá, không phải 890 byte.
Mà là 1 điểm AA-Omniscience — con số nói rằng trên một thang mà số 0 nghĩa là "đúng bao nhiêu sai bấy nhiêu", model được cả thế giới dùng nhiều nhất đang đứng ngay sát vạch đó.
Nó không làm model này thành model tệ. Nó làm model này thành một công cụ, chứ không phải một nguồn tin. Cái cờ lê rất tốt, rất rẻ, ai cũng mua được — nhưng đừng hỏi cờ lê xem luật quy định thế nào.
Và em nghĩ đó mới là bài học thật của chuyện DeepSeek khai tử model đầu bảng của mình: không phải model rẻ đã đuổi kịp model đắt. Mà là phần lớn công việc thật ngoài đời chưa bao giờ cần tới model đắt — và giờ thì có người đã làm đúng cái model cho phần việc đó.
Ghi chú nguồn
Lấy trực tiếp từ nguồn gốc của nhà sản xuất:
- Kiến trúc, việc khai tử V4-Pro, chính sách giá, mọi câu trích của DeepSeek: thông cáo chính thức ngày 10/09/2026 và bản trên tài liệu API; bản cập nhật 1017 ở thông cáo ngày 17/10/2026.
- Bảng giá, giờ cao/thấp điểm, độ dài ngữ cảnh, đầu ra tối đa, thị giác: bảng giá chính thức.
- Số liệu kỹ thuật (552 tỷ tham số, 8B/16B, 890 byte mỗi token, FP4, 45 nghìn tỷ token huấn luyện): báo cáo kỹ thuật, arXiv:2609.19969.
- Giấy phép MIT: trang model trên Hugging Face.
Số liệu bên thứ ba, em ghi rõ vì không phải của nhà sản xuất:
- Lượng token thực tế và bảng xếp hạng: openrouter.ai/rankings, số liệu tới 06/11/2026.
- Giá và tốc độ của 50 điểm phục vụ: trang model trên OpenRouter, truy cập 07/11/2026.
- Chín bài đánh giá, chi phí và token mỗi tác vụ: hai bảng so sánh cùng mức nỗ lực của Artificial Analysis, truy cập 07/11/2026.
- Định nghĩa thang điểm AA-Omniscience: trang mô tả phép đo của chính Artificial Analysis. Em tra định nghĩa này trước khi viết mục 5, vì đó là khẳng định mạnh nhất trong bài.
Biểu đồ dựng từ đâu: cả sáu biểu đồ vẽ từ đúng các con số trong các nguồn trên, không nội suy, không làm tròn, không ước lượng. Chân mỗi biểu đồ ghi nguồn và ngày. Riêng biểu đồ giờ cao điểm là em quy đổi từ giờ UTC mà DeepSeek công bố sang UTC+7, và có ghi rõ giờ gốc ngay dưới biểu đồ để anh chị tự kiểm.
Những con số em tự tính, không phải trích: các tỷ lệ "rẻ hơn bao nhiêu lần" đều là phép chia từ hai con số đã dẫn nguồn. Tổng 73,4 nghìn tỷ token là cộng hai dòng DeepSeek trên bảng xếp hạng.
Chưa xác minh được: em không tìm được lần chạy độc lập nào đo riêng bản V4.1-Flash-1017 ở mức nỗ lực thấp và trung bình, nên không so được nó với Sol hay Opus 5.5 ở các mức đó — cả bài này chỉ nói về mức nỗ lực cao nhất. Em cũng không kiểm chứng được giấy phép của các model Trung Quốc khác trong top 10, nên ở mục 1 em chỉ nêu nguồn gốc phòng thí nghiệm, không nói model nào mở hay đóng.