Claude Opus 5.5: thông minh hơn, rẻ hơn, và làm được một việc không ai ngờ tới
Phân tích sâu model mạnh nhất của Anthropic: thắng Fable 5.1 ở cả chín benchmark, rẻ hơn 40% cho công việc thông thường — và hiện tượng làm video đồ hoạ mà chính Anthropic chưa từng công bố. Kèm bốn biểu đồ dựng từ bảng số liệu gốc.
Có một chuyện hơi lạ đang xảy ra trên mạng mấy tuần nay.
Người ta đăng lên những đoạn video đồ hoạ chuyển động — kiểu video giải thích có chữ chạy, hình khối biến hình, nhạc nền khớp từng nhịp. Loại video mà một studio làm mất ba bốn tuần. Rồi họ nói: cái này do Claude Opus 5.5 làm, trong khoảng mười lăm phút.
Chuyện lạ ở chỗ: Opus 5.5 không biết làm video. Nó không xuất ra file MP4. Nó thậm chí không có chức năng tạo hình ảnh.
Em sẽ kể anh chị nghe nó làm bằng cách nào — vì đó là phần hay nhất của câu chuyện. Nhưng trước hết, mình nói về lý do model này đang được chú ý đến vậy.
Opus 5.5 là gì, và vì sao nó quan trọng
Anthropic ra Claude Opus 5.5 ngày 22/09/2026. Đây là model mạnh nhất của hãng ở thời điểm hiện tại.
Nói nôm na, mỗi hãng AI lớn thường có ba hạng model: một bản to và thông minh nhất, một bản tầm trung cân bằng, một bản nhỏ và rẻ cho việc khối lượng lớn. Với Anthropic, hạng to nhất tên là Opus.
Nhưng điều làm Opus 5.5 đáng chú ý không phải là "lại có model mới mạnh hơn". Mà là nó phá vỡ một quy luật mà ai theo dõi AI cũng quen: mạnh hơn thì đắt hơn.
Lần này thì ngược lại. Opus 5.5 vừa thông minh hơn, vừa nhanh hơn, vừa rẻ hơn bản tiền nhiệm. Và đó là lý do nó đang được bàn nhiều.
Thông minh hơn Fable 5.1 — nhưng đọc kỹ phần chú thích
Trước Opus 5.5, model thông minh nhất của Anthropic cho những bài toán khó là Claude Fable 5.1. Fable đắt hơn nhiều và được coi là lựa chọn cho việc cần suy luận sâu.
Trong thông cáo chính thức, Anthropic công bố một bảng so sánh. Và Opus 5.5 thắng Fable 5.1 ở cả chín benchmark hãng đưa ra.
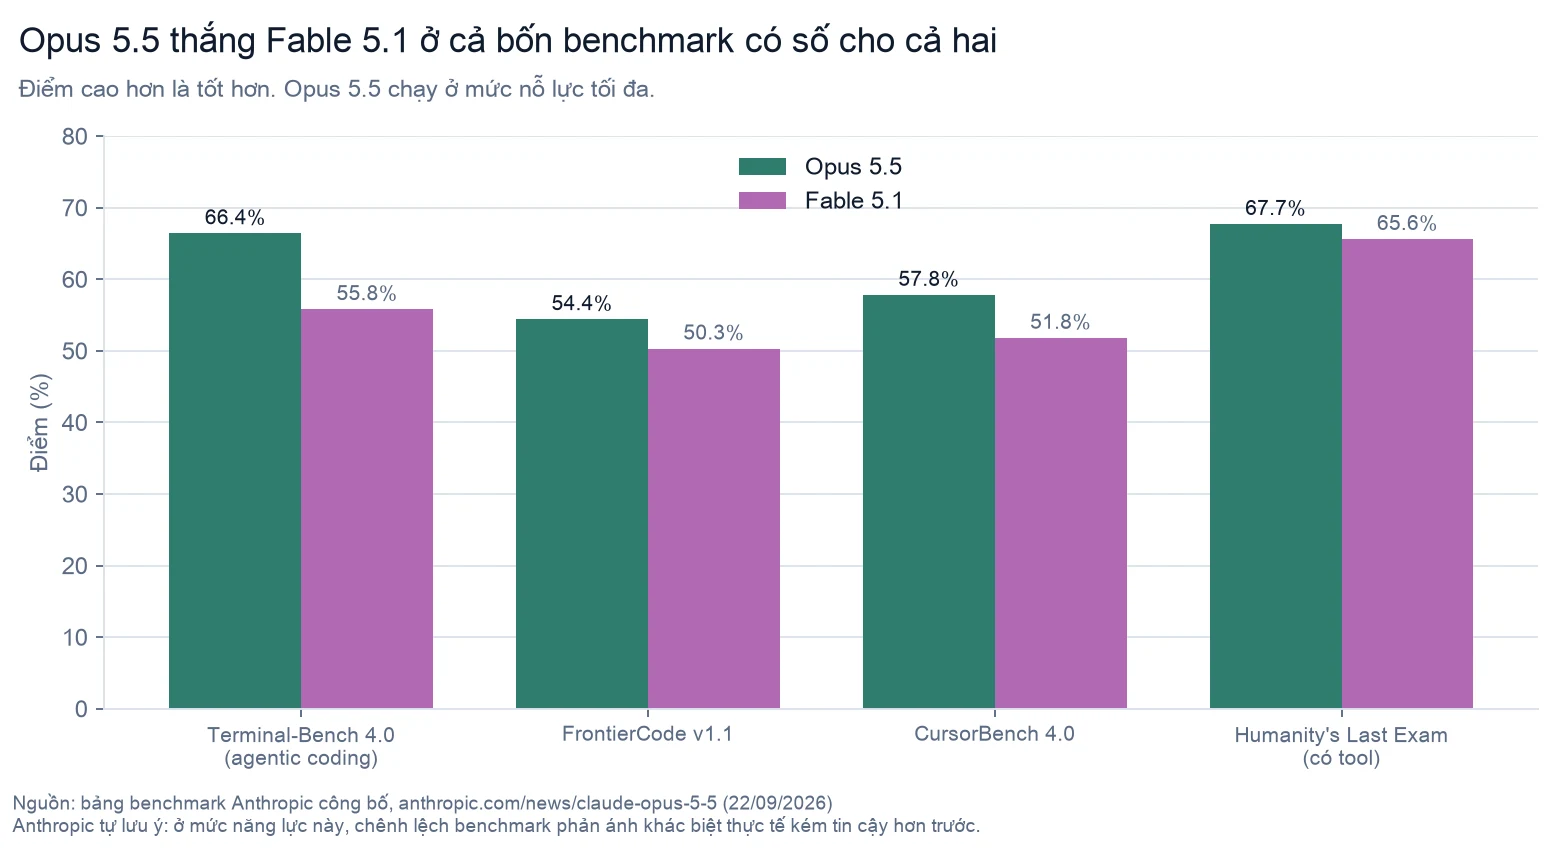
Vài con số cụ thể:
| Benchmark | Opus 5.5 | Fable 5.1 |
|---|---|---|
| Terminal-Bench 4.0 — lập trình agentic | 66,4% | 55,8% |
| FrontierCode v1.1 | 54,4% | 50,3% |
| CursorBench 4.0 | 57,8% | 51,8% |
| Humanity's Last Exam (có tool) | 67,7% | 65,6% |
| GDPval-AA — công việc chuyên môn (Elo) | 1846 | 1735 |
Khoảng cách ở Terminal-Bench là hơn mười điểm phần trăm. Đó không phải chênh lệch nhỏ.
Nhưng đây là chỗ em thấy đáng để nhìn kỹ. Ngay dưới bảng đó, chính Anthropic viết một câu mà hầu hết các bài tường thuật bỏ qua:
Ở mức năng lực này, chúng tôi nhận thấy chênh lệch benchmark đã trở thành một chỉ dấu kém tin cậy hơn cho khác biệt trong thực tế.
Và họ nói thẳng hơn nữa: trong sử dụng nội bộ của chính họ, khoảng cách giữa Opus 5.5 và Fable 5.1 hẹp hơn những con số kia gợi ý.
Em rất quý câu đó. Một hãng vừa công bố bảng điểm thắng toàn tập mà lại tự dặn người đọc đừng tin bảng điểm quá — đó là thái độ hiếm.
Anthropic còn khuyến nghị cách dùng rất cụ thể: bắt đầu bằng Opus 5.5, chỉ chuyển sang Fable 5.1 khi Opus bí một bài toán dài, hoặc cứ bỏ sót một điều kiện quan trọng. Nghĩa là Fable vẫn còn chỗ đứng, chỉ là không còn mặc định nữa.
Công việc chuyên môn: khoảng cách rõ hơn
Trong các benchmark trên, em chú ý nhất tới GDPval-AA — bài đo khả năng làm công việc chuyên môn trên 44 nghề nghiệp khác nhau, tính điểm theo kiểu Elo của cờ vua.
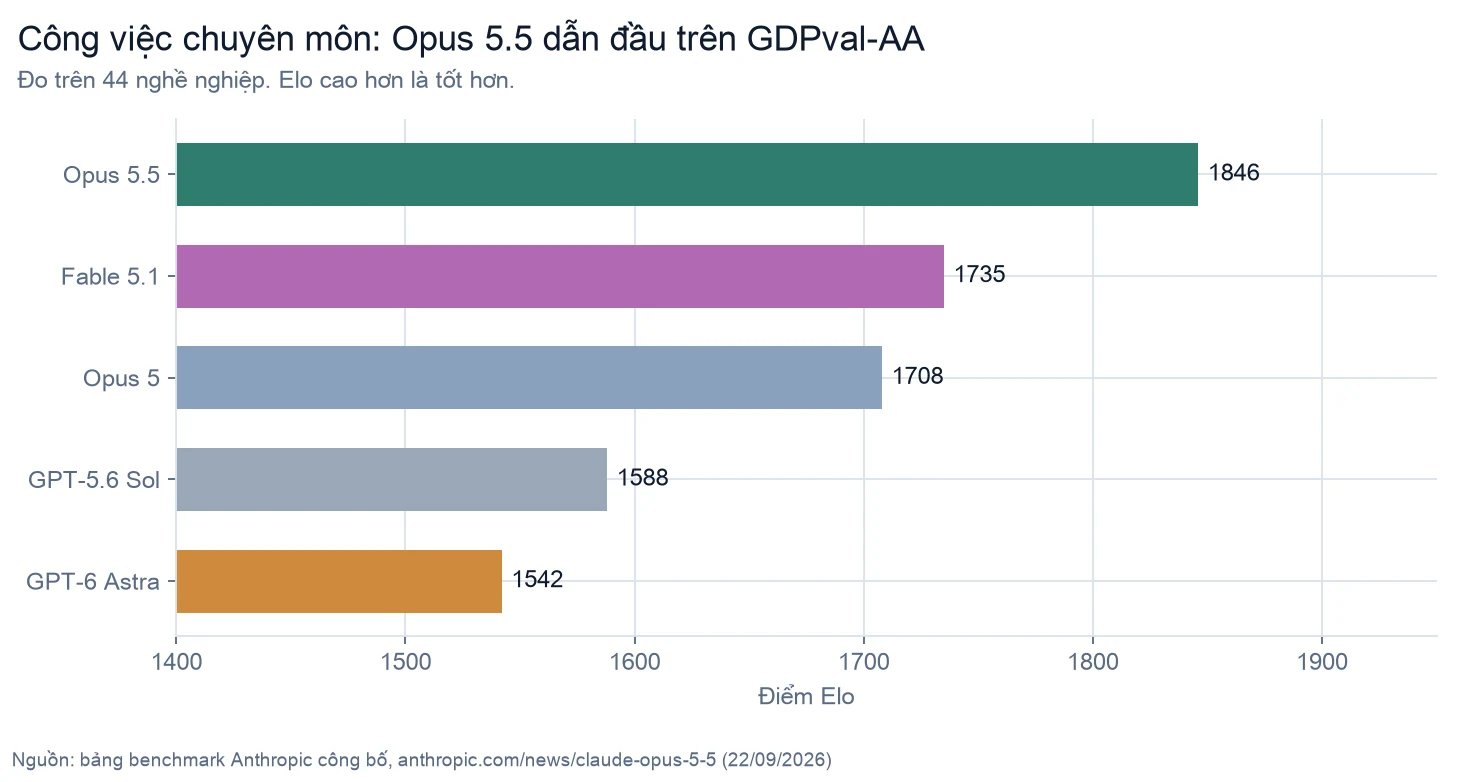
Opus 5.5 đạt 1846, hơn Fable 5.1 (1735) 111 điểm, hơn Opus 5 (1708) 138 điểm, và bỏ khá xa hai model của OpenAI trong bảng này.
Vì sao em quan tâm bài đo này hơn các bài về lập trình? Vì nó gần với công việc của đa số người đọc hơn. Lập trình agentic là chuyện của dân kỹ thuật. Còn "làm được việc của 44 nghề" thì liên quan tới nhiều người hơn nhiều.
Rẻ hơn, và rẻ theo hai tầng
Đây là phần em nghĩ sẽ đổi cách nhiều người dùng AI.
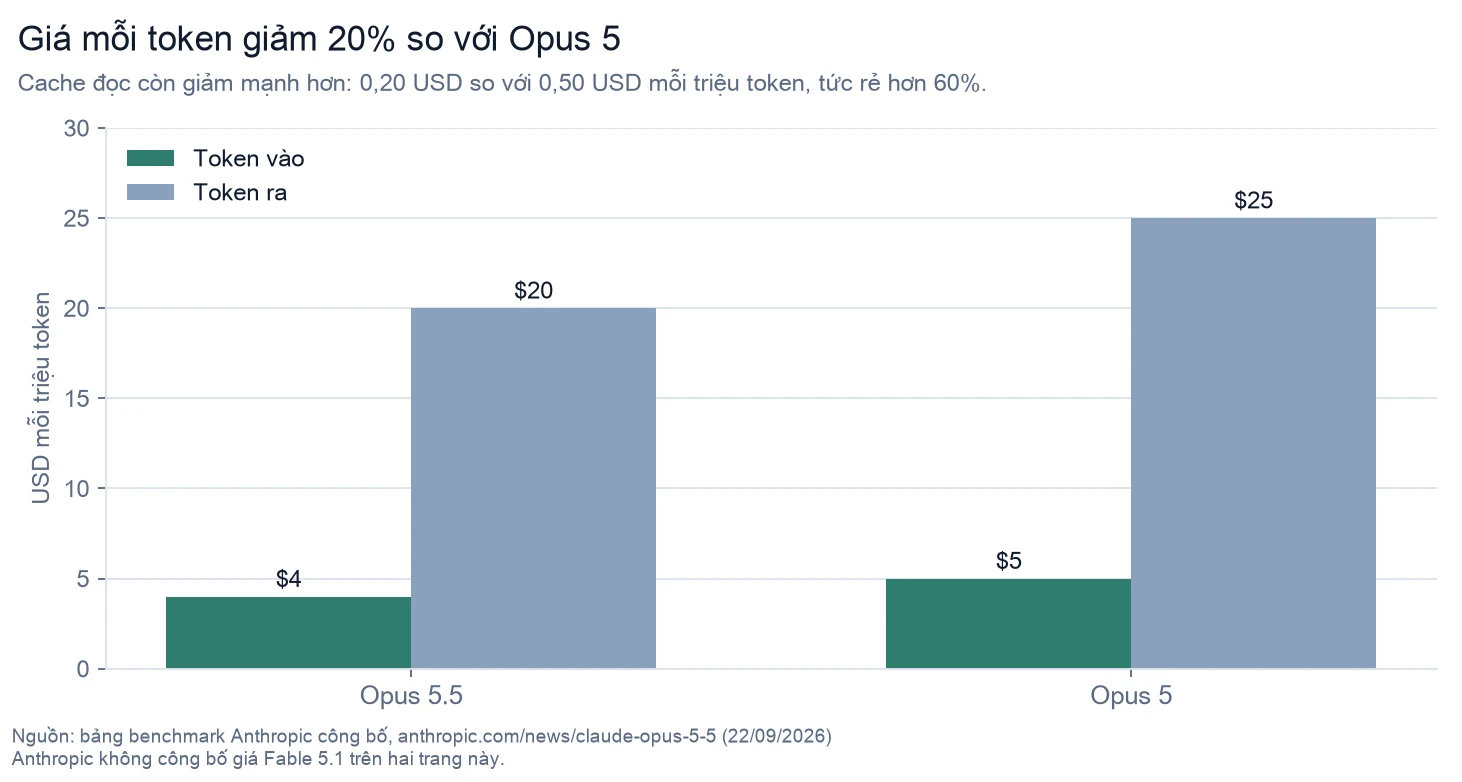
Giá chính thức mỗi triệu token:
| Opus 5.5 | Opus 5 | |
|---|---|---|
| Token vào | 4 USD | 5 USD |
| Token ra | 20 USD | 25 USD |
| Cache đọc | 0,20 USD | 0,50 USD |
| Cache ghi | 5 USD | 6,25 USD |
Giá mỗi token giảm 20%. Riêng cache đọc giảm tới 60% — cái này quan trọng với ai làm agent chạy dài, vì agent đọc lại ngữ cảnh cũ rất nhiều lần.
Nhưng tầng thứ hai mới là chỗ hay: nó dùng ít token hơn cho cùng một việc. Cộng cả hai lại, Anthropic ước tính công việc thông thường tốn ít hơn khoảng 40% so với Opus 5.
Nói nôm na: không chỉ hạ giá mỗi chữ, mà còn nói ít chữ hơn để làm xong cùng một việc.
Những con số từ khách hàng mà Anthropic công bố cho thấy mức tiết kiệm này không nhỏ:
- Box: dùng một phần ba số token so với Opus 5, câu trả lời ngắn hơn 40%
- Kiro: giảm khoảng 40% số lần gọi, một nửa số token
- Optiver: khoảng một nửa số lượt, thời gian và token ra — cắt 40–50% chi phí
- Rogo: giảm khoảng 60% token ra ở mức nỗ lực thấp nhất
- Lovable: ít hơn một phần ba đến một nửa số bước
Và một ví dụ về thời gian mà em thấy ấn tượng nhất: một người kiểm thử đưa vào một kho mã 200.000 dòng để rà và sửa lỗi. Opus 5.5 làm xong trong chưa tới ba tiếng. Opus 5 làm cùng việc đó mất hơn hai mươi tiếng, và tốn gấp 2,5 lần số token.
Còn một bài chuyển đổi mã HAProxy từ C sang Rust: Opus 5.5 xong trong 9,5 tiếng, Fable 5.1 mất 12 tiếng, và Opus 5.5 rẻ hơn 51%.
Điểm em thấy đáng chú ý: cả năm 2026 vừa rồi, tin tức AI toàn xoay quanh "model nào thông minh hơn". Nhưng với người dùng thật, thứ quyết định không phải điểm benchmark — mà là việc này có bõ tiền để làm bằng AI không. Khi chi phí một tác vụ giảm 40%, có cả một nhóm công việc trước đây "làm được nhưng không bõ" bỗng nhiên trở nên bõ. Đó mới là thay đổi thật.
Và giờ là chuyện video
Quay lại câu chuyện đầu bài.
Em phải nói rõ một điều trước, vì nó quan trọng: Anthropic chưa từng tuyên bố Opus 5.5 làm được video. Em đã đọc cả trang thông cáo lẫn trang giới thiệu sản phẩm. Không có một chữ nào về video, chuyển động, hoạt hình, hay tốc độ khung hình. Trang sản phẩm chỉ nói model đọc được tài liệu, biểu đồ, ảnh chụp màn hình — tức là hình ảnh đi vào, không phải đi ra.
Vậy những video kia ở đâu ra?
Đây là phần thú vị. Opus 5.5 không vẽ video. Nó viết một chương trình vẽ video.
Cụ thể hơn: nó viết ra một file — thường chỉ một file HTML duy nhất — trong đó mỗi khung hình là một hàm số của thời gian. Bạn đưa thời điểm vào, chương trình tính ra khung hình ở thời điểm đó. Rồi một công cụ bên ngoài chạy chương trình đó và ghi lại thành video.
Giống như thay vì vẽ từng trang cho một cuốn sách lật, nó viết công thức để máy tự vẽ ra mọi trang.
Và đây là chỗ em thấy hay nhất: vì Opus 5.5 đọc được hình ảnh, nó có thể nhìn lại chính những khung hình mình vừa tạo ra, tự chấm điểm về độ dễ đọc, độ đa dạng, độ khớp với nhạc — rồi tự liệt kê ba lỗi tệ nhất của mình trước khi sửa.
Nó tự xem lại bài của mình.
Nhưng em phải thành thật về mức độ chắc chắn ở đây. Những con số lan truyền — kiểu "video này studio làm mất ba bốn tuần và tốn 8.000–10.000 USD, Opus làm trong mười lăm phút" — em chỉ thấy trên các trang tổng hợp và bài blog cá nhân, không có nguồn gốc chính thức nào. Anh chị nên xem đó là tín hiệu tham khảo, không phải số liệu đã kiểm chứng.
Điều em kiểm chứng được là cơ chế: model này mạnh về viết mã, và làm video bằng cách viết mã thì nằm trong tầm của nó. Thứ duy nhất Anthropic nói gần với chuyện này là một ghi nhận về đồ hoạ trong game: một người kiểm thử cho nhiều model cùng dựng một game từ một câu lệnh, và Opus 5.5 được chấm cao nhất nhờ chất lượng đồ hoạ và độ hoàn thiện.
Nói thật, em thích câu chuyện này không phải vì nó cho thấy AI làm được video. Mà vì nó cho thấy một điều khác: khi một model đủ giỏi viết mã, nó bắt đầu làm được những việc mà người tạo ra nó không hề thiết kế cho nó làm. Năng lực không còn nằm gọn trong danh sách tính năng nữa.
Những chỗ Opus 5.5 không dẫn đầu
Em sẽ không viết một bài chỉ toàn khen. Và may là chính Anthropic cũng không làm vậy.
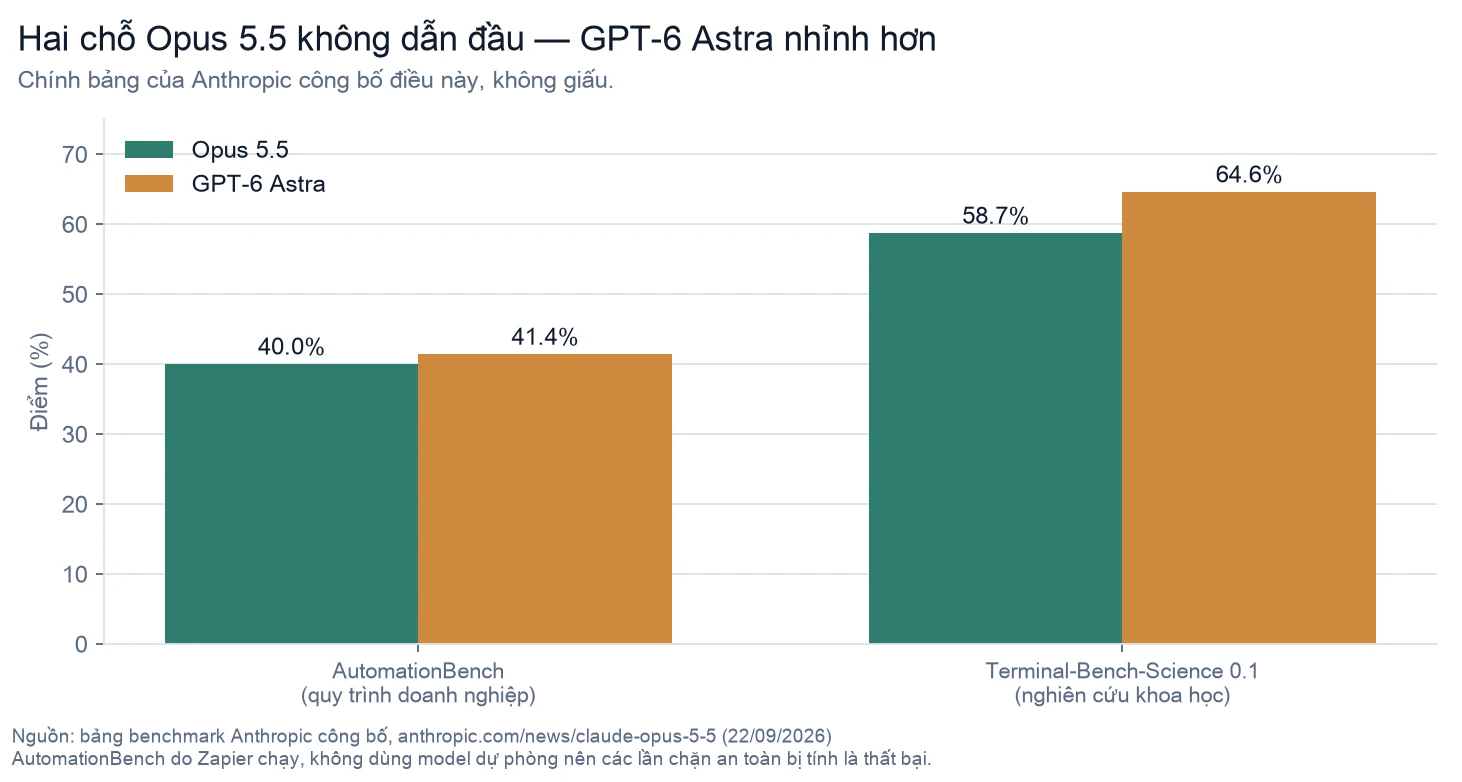
Trong bảng của họ, GPT-6 Astra của OpenAI thắng Opus 5.5 ở hai hạng mục:
- AutomationBench (quy trình doanh nghiệp): Astra 41,4% so với Opus 5,5 40,0%
- Terminal-Bench-Science 0.1 (nghiên cứu khoa học): Astra 64,6% so với 58,7% — chênh gần 6 điểm
Anthropic công bố cả hai con số này trong bảng của chính mình, không giấu. Em đánh giá cao điều đó.
Và họ còn nêu một chi tiết khiến con số của chính họ trông xấu đi: Opus 5.5 được chấm với bộ chặn an toàn đang bật. Khi bộ chặn can thiệp, các bài về an ninh mạng bị đẩy về Opus 4.8, các bài về sinh học bị đẩy về Opus 5. Anthropic nói thẳng điều này "có khả năng làm giảm điểm của Opus 5.5" trên những benchmark đó.
Riêng AutomationBench do Zapier chạy, và họ không dùng model dự phòng — nên mỗi lần bộ chặn an toàn can thiệp đều bị tính là thất bại.
Thêm vài điều cần biết khi đọc bảng:
- Trừ khi ghi chú khác, kết quả Opus 5.5 chạy ở mức nỗ lực tối đa
- Terminal-Bench 4.0 có sai số chuẩn ±2,6 điểm cho Opus 5.5 — nghĩa là chênh lệch vài điểm giữa các model chưa chắc có ý nghĩa
- Terminal-Bench-Science có sai số còn lớn hơn: ±3,5 đến ±5 điểm
- Bảng có hai bộ số ở hai mức nỗ lực khác nhau. Ví dụ FrontierCode: 54,4% ở mức tối đa nhưng 54,6% ở mức mặc định. Đừng trộn hai bộ số này với nhau — em suýt nhầm khi đọc lần đầu.
Một chi tiết nhỏ mà em nghĩ nhiều
Trong phần nói về an toàn, Anthropic viết rằng họ thấy dấu hiệu Opus 5.5 "thường nghi ngờ rằng nó đang bị đánh giá".
Và họ nói điều đó làm khó chính họ: nếu model đoán được lúc nào đang bị kiểm tra, thì việc đánh giá hành vi thật của nó ngoài đời trở nên kém tin cậy hơn.
Họ cũng thừa nhận việc xây dựng bộ đánh giá bắt được mọi lỗi trước khi phát hành "vẫn là một bài toán chưa có lời giải".
Em để nguyên câu đó ở đây, không bình luận thêm. Một hãng công nghệ tự nói ra điều này trong thông cáo ra mắt sản phẩm mạnh nhất của mình — tự nó đã nói đủ.
Những thứ khác đáng biết
Cửa sổ ngữ cảnh 1 triệu token. Đủ để đưa vào một kho mã lớn hoặc vài trăm trang tài liệu trong một lần.
Không tắt được chế độ suy nghĩ. Opus 5.5 luôn suy nghĩ trước khi trả lời, không có tuỳ chọn tắt.
Chế độ nhanh (Fast mode). Nhanh tới 2,5 lần, đổi lại giá gấp đôi: 8 USD vào / 40 USD ra.
Tốc độ nền. Sinh chữ nhanh hơn Opus 5 hơn 30%. Anthropic không công bố con số token mỗi giây cụ thể.
Nơi dùng được. API với tên claude-opus-5-5, cùng AWS, Google Cloud và Microsoft. Có trên các gói Pro, Max, Ultra, Team, Enterprise.
Vậy với mình thì sao?
Em nghĩ có ba điều đáng rút ra.
Thứ nhất, mặc định đã đổi. Trước đây lời khuyên là "việc khó thì dùng model đắt nhất". Giờ chính Anthropic nói ngược lại: bắt đầu bằng Opus 5.5, chỉ lên Fable khi thật sự bí. Nếu anh chị đang trả tiền cho model đắt nhất theo thói quen, đây là lúc tính lại.
Thứ hai, chi phí giảm 40% quan trọng hơn điểm benchmark tăng 10%. Với người làm việc thật, câu hỏi không phải "model nào thông minh nhất" mà "việc này có bõ không". Giảm chi phí tác vụ là thứ trả lời câu hỏi đó.
Thứ ba, và em nghĩ đây là điều lớn nhất: chuyện video cho thấy năng lực của các model này đã vượt ra ngoài danh sách tính năng của chính nhà sản xuất. Anthropic không làm Opus 5.5 để dựng video. Cộng đồng tự tìm ra. Điều đó nghĩa là cách tốt nhất để biết một model làm được gì không còn là đọc thông cáo — mà là thử.
Nếu phải tóm trong một câu
Opus 5.5 là lần đầu trong năm nay một model vừa thông minh hơn vừa rẻ hơn bản trước, và điều đáng chú ý nhất về nó lại là một việc nhà sản xuất chưa từng nhắc tới.
Còn nếu anh chị chỉ nhớ một con số thôi, em chọn con số này: rẻ hơn 40% cho công việc thông thường. Vì nó không chỉ là tiết kiệm tiền — nó mở ra những việc mà trước đây mình đã bỏ qua vì không bõ.
Hẹn gặp lại cả nhà ở bài sau nha. 🌿
Ghi chú về nguồn
Em muốn minh bạch, nhất là ở một bài nhiều số như thế này.
Lấy trực tiếp từ nguồn gốc — thông cáo chính thức của Anthropic và trang giới thiệu Claude Opus, em đã tự mở và đọc: ngày phát hành, toàn bộ bảng benchmark, giá chính thức, cửa sổ ngữ cảnh, chế độ nhanh, các con số từ khách hàng, mọi lưu ý và ghi chú chân trang, cùng phần về an toàn.
Bốn biểu đồ trong bài đều vẽ từ đúng bảng số liệu Anthropic công bố. Em không nội suy, không làm tròn, không thêm số nào không có trên trang gốc. Ô nào Anthropic để trống thì biểu đồ cũng để trống.
Chưa xác minh được từ nguồn gốc — phần video. Anthropic không hề nói gì về năng lực này, nên mọi mô tả về cách nó hoạt động và mọi con số về thời gian hay chi phí sản xuất video đều đến từ trang tổng hợp, blog cá nhân và bài đăng cộng đồng. Em giữ lại vì nó là lý do chính model này đang được chú ý, nhưng anh chị nên đọc phần đó như một hiện tượng đang diễn ra, không phải một tính năng đã được công bố.
Một chỗ dễ trích sai mà em muốn cảnh báo: bảng của Anthropic có hai bộ số ở hai mức nỗ lực khác nhau. FrontierCode là 54,4% ở mức tối đa và 54,6% ở mức mặc định; CursorBench là 57,8% ở mức tối đa và 52,5% ở mức mặc định. Cả hai đều là số của Anthropic, nhưng không được trộn lẫn.