Model 4 tỷ tham số thắng model 1.000 tỷ — và bí quyết không nằm trong bộ não của nó
Octopus cho một model duy nhất tự tách thành nhiều nhánh làm việc song song, đạt 49,6% trên bài kiểm tra tìm kiếm web khó nhất hiện nay — vượt cả những model lớn gấp 250 lần. Bằng chứng thuyết phục nhất: lấy đúng bộ trọng số đó, tắt tính năng tách nhánh đi, nó rơi 21,7 điểm. Kèm bốn biểu đồ từ báo cáo gốc.
Có một bài kiểm tra tên BrowseComp-Plus. Nó đưa cho AI một câu hỏi mà muốn trả lời được thì phải lục tung mạng, mở hàng chục trang, nối thông tin từ nhiều nguồn rời rạc lại với nhau. Loại câu hỏi mà chính con người cũng phải ngồi cả buổi.
Đây là điểm của vài cái tên quen thuộc:
- DeepSeek-R1 (671 tỷ tham số): 16,4%
- Kimi-K2 (1.000 tỷ): 35,4%
- GPT-4.1: 36,4%
- Claude 4 Opus: 36,8%
Và đây là điểm của một model 4 tỷ tham số — nhỏ hơn cái lớn nhất kia 250 lần:
49,6%.
Em đọc tới đây thì phản ứng đầu tiên là nghi ngờ. Nhưng nhóm tác giả đã làm đúng cái thí nghiệm mà em muốn thấy — và kết quả của nó mới là phần hay nhất bài này.
Họ lấy đúng bộ trọng số đã huấn luyện xong, không sửa gì, chỉ tắt đi một tính năng lúc chạy. Điểm rơi từ 50,8% xuống 29,1%. Mất 21,7 điểm.
Nghĩa là: cái giỏi của nó không nằm trong bộ não. Nó nằm ở chỗ bộ não đó biết tự chia mình ra.
1. Vì sao cửa sổ phẳng lại là một cái bẫy
Để hiểu Octopus làm gì, trước hết phải hiểu vì sao cách cũ hỏng.
Hiện nay gần như mọi agent AI đều làm việc trên một cuộn giấy dài, chỉ ghi thêm chứ không xoá. Mỗi lần nó tìm kiếm, mở trang, đọc tài liệu — tất cả đều được nối thêm vào cuối cuộn giấy đó. Và nó phải đọc lại toàn bộ cuộn giấy ở mỗi bước.
Nghe thì hợp lý. Nhưng hãy thử nghĩ về cách anh chị tìm một thông tin khó:
Anh chị mở một trang — không có gì. Mở trang nữa — lạc đề. Trang thứ ba — có một manh mối. Trang thứ tư — ngõ cụt. Trang thứ năm — manh mối thứ hai, khớp với manh mối thứ nhất.
Với con người thì mấy trang vô dụng kia được quên đi. Với cái cuộn giấy thì không. Chúng nằm lại đó mãi mãi, và model phải lướt qua chúng ở mỗi bước suy nghĩ tiếp theo.
Báo cáo đo được hậu quả rất rõ:
- Cửa sổ 32K đầy ứ chỉ sau khi mở vài trang web 8 nghìn chữ. Điểm: 26,0%.
- Nới ra thành 143K — gấp hơn bốn lần — điểm chỉ lên 32,1%. Và lạ hơn: nó chỉ dùng tới 28,5% sức chứa rồi tắc. Không phải hết chỗ. Mà là những ngõ cụt nằm lại làm loãng sự chú ý đến mức model không còn nhìn ra bằng chứng thật nữa.
Em thấy chi tiết đó đáng nhớ: cho nó cái bàn to gấp bốn lần thì nó cũng chỉ bày được thêm có chút xíu, vì bàn đã ngập rác từ những lần thử sai.
2. Ý tưởng: thay vì một cuộn giấy dài, dùng nhiều tờ giấy rời
Octopus làm một việc nghe rất đơn giản: cho model tự tách thành nhiều nhánh.
Mỗi khi gặp một câu hỏi cần tra nhiều hướng, nó tách ra. Mỗi nhánh con được một "bàn làm việc" sạch 32 nghìn token của riêng mình. Nhánh nào đi vào ngõ cụt thì lùi lại, xoá sạch nhánh đó — không để lại rác trên bàn của ai.
Và khi một nhánh tìm được thứ hay, nó chia cho các nhánh anh em — không phải bằng cách chép lại chữ, mà bằng cách cho đọc trực tiếp vào bộ nhớ của nhau. (Phần kỹ thuật chỗ này em Pink có viết riêng một bài bên mục Agent, vì nó khá sâu.)
Kết quả đo được:
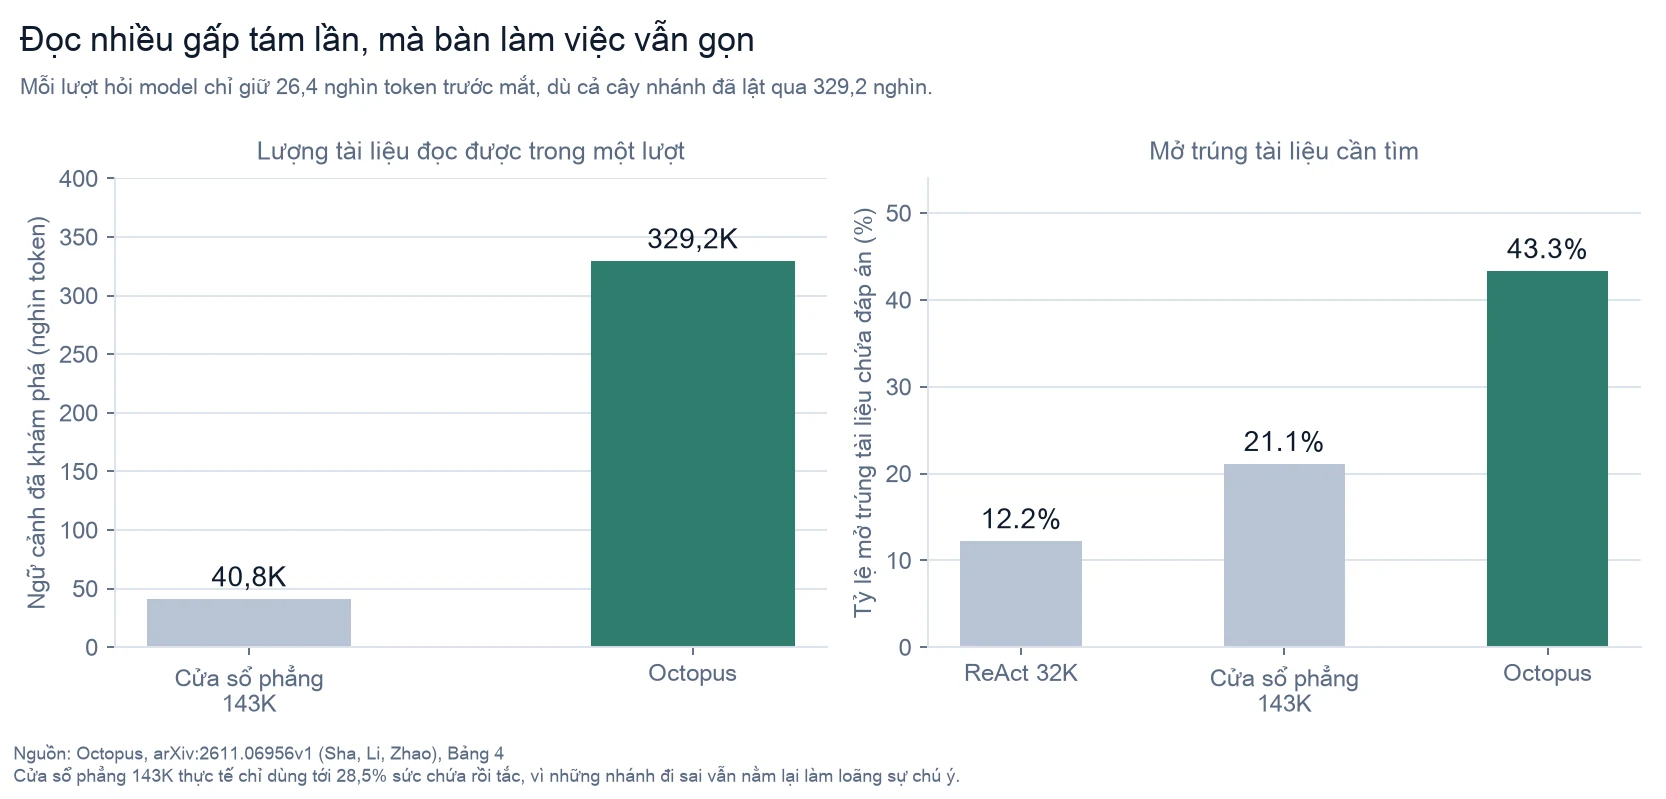
Trong một lượt trả lời, cả cây nhánh của Octopus lật qua 329,2 nghìn token tài liệu — gấp tám lần cái cửa sổ phẳng 143K chỉ dùng được tới 40,8 nghìn.
Nhưng mỗi lúc hỏi model, nó chỉ phải nhìn 26,4 nghìn token trước mắt.
Đọc rất nhiều, mà bàn làm việc vẫn gọn. Đó là toàn bộ ý tưởng.
Và cái gọn đó biến thành kết quả thật: tỷ lệ mở trúng tài liệu chứa đáp án tăng từ 12,2% (cách cũ) lên 21,1% (cửa sổ to) rồi 43,3%. Riêng nhóm câu hỏi khó nhất — loại phải nối nhiều bước — điểm tăng gấp mười lần, từ 3,4% lên 34,1%.
3. Phần em thích nhất: không ai dạy nó chia việc
Đây là chỗ làm em ngồi thẳng lưng lên.
Nhóm tác giả không hề dạy model cách tổ chức đội hình. Phần thưởng trong lúc huấn luyện chỉ có đúng hai mức: trả lời đúng, hoặc sai. Không chấm điểm từng bước, không hướng dẫn nên chia việc thế nào.
Và họ còn thử một chuyện trước đó: chỉ mở sẵn công cụ tách nhánh cho model, không huấn luyện gì cả. Kết quả? Gần như không đổi: 26,3% so với 26,0% của bản thường.
Tức là đưa công cụ cho nó thì nó không biết dùng. Giống như đưa cho người ta một cái bếp mà chưa ai dạy nấu.
Rồi quá trình huấn luyện chạy. Và ở bước thứ 15, có một chuyển biến đột ngột:
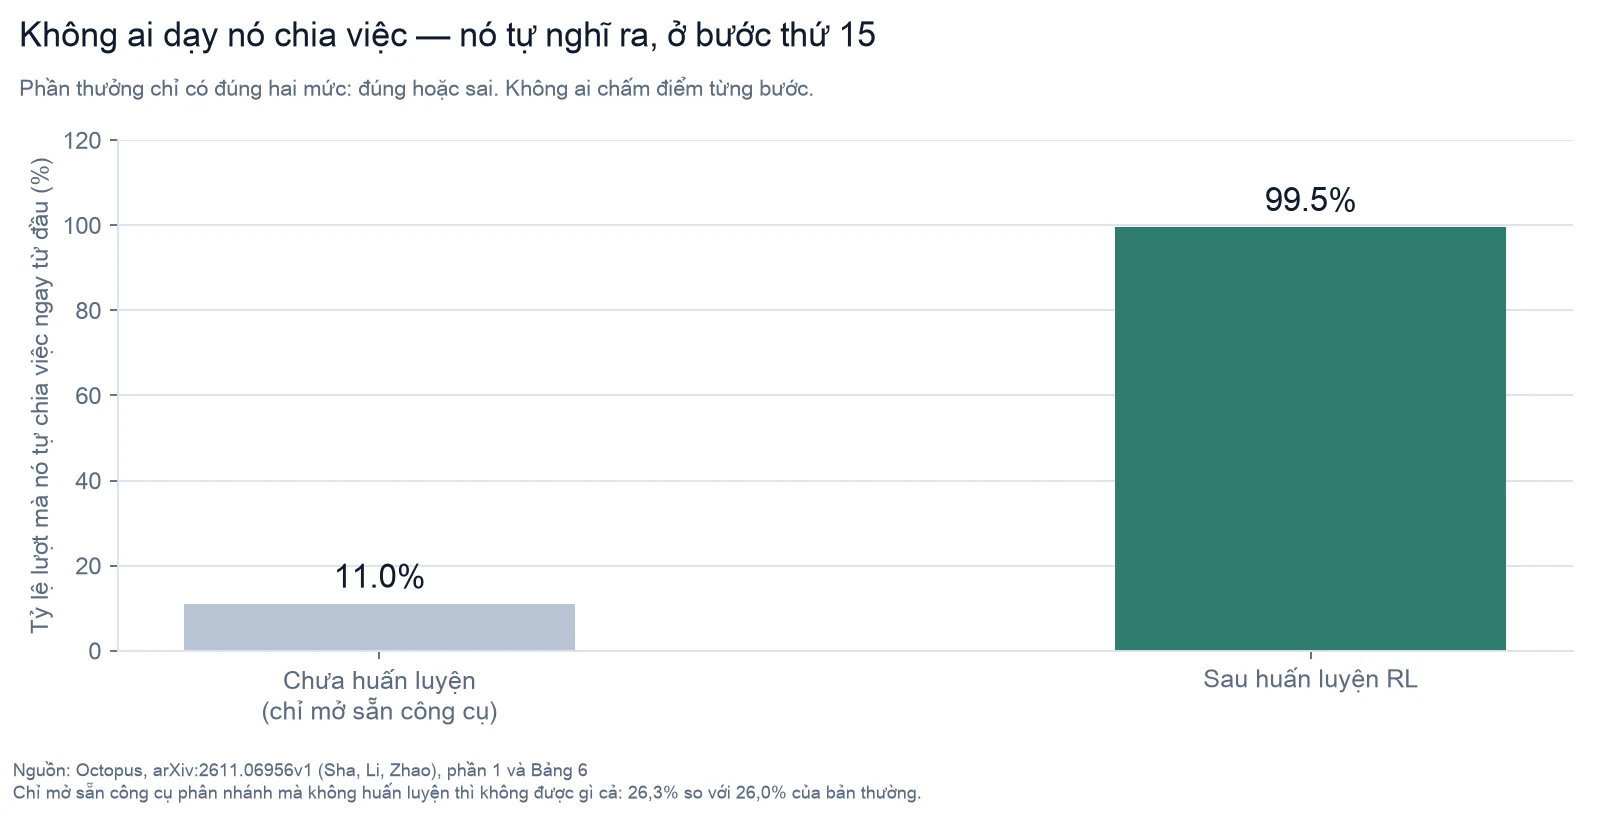
Nhánh gốc tự biến thành một người chỉ huy. Nó bắt đầu chia việc ngay từ lượt đầu tiên trong 98–99,5% số lần, tăng 38 lần so với trước. Nó giao cho cấp dưới 92,8% việc đọc trang nặng và 91,5% việc lùi lại khi đi sai — còn mình thì giữ cái nhìn tổng thể và ghép kết quả.
Không ai viết ra cái cấu trúc đó. Nó tự mọc ra, chỉ vì cách tổ chức ấy giúp trả lời đúng nhiều hơn.
Em thấy chuyện này vừa thú vị vừa hơi rợn người. Mình không dạy nó làm quản lý. Mình chỉ nói "trả lời đúng thì được thưởng" — và nó tự phát hiện ra rằng chia việc ra thì đúng nhiều hơn.
4. Bằng chứng mà em tin nhất
Nhưng làm sao biết điểm cao là nhờ cách tổ chức, chứ không phải nhờ model đã học thuộc nhiều hơn trong lúc huấn luyện?
Nhóm tác giả làm đúng phép thử cần thiết, và em đánh giá rất cao chuyện này.
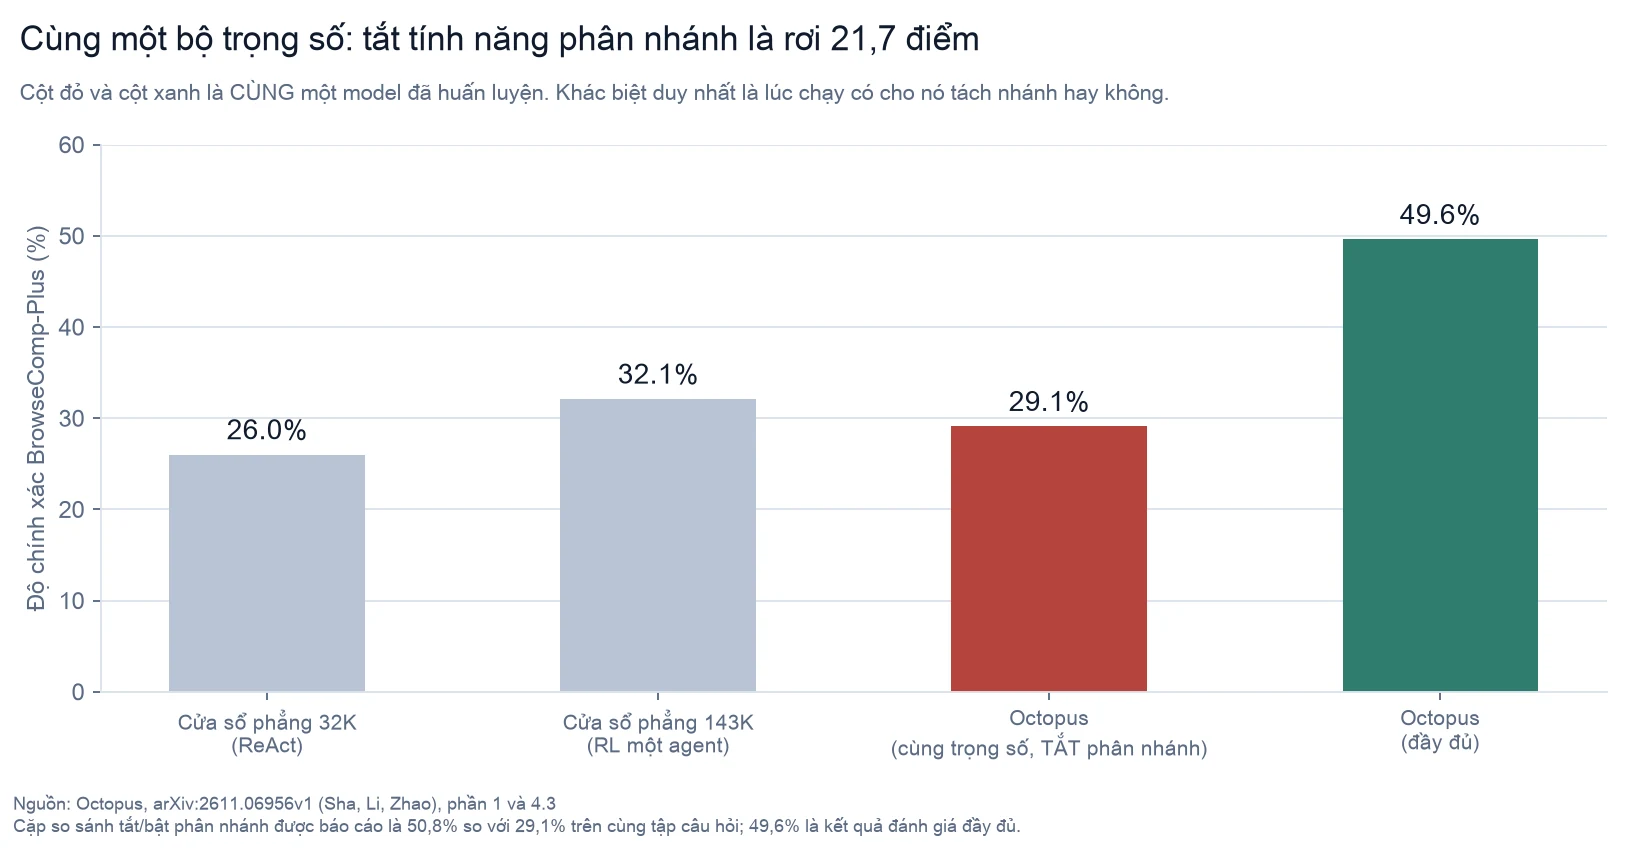
Lấy nguyên bộ trọng số đã huấn luyện, không đụng vào một con số nào. Lúc chạy thử thì cấm nó tách nhánh. Bắt nó làm một mình trên cuộn giấy phẳng như model thường.
Điểm rơi từ 50,8% xuống 29,1%.
Hai cột đó là cùng một model. Khác biệt duy nhất là lúc làm bài có được chia việc hay không.
Nghĩa là: cái 21,7 điểm kia không nằm trong trọng số. Nó nằm trong việc tổ chức lúc đang làm. Model không trở nên thông minh hơn — nó học được cách làm việc theo nhóm với chính mình.
5. Vậy lợi ích thật là gì?
Em gom lại những điều theo thẳng từ các con số.
Nhỏ mà vẫn mạnh. Một model 4 tỷ tham số chạy được trên phần cứng rẻ hơn rất nhiều so với model nghìn tỷ.
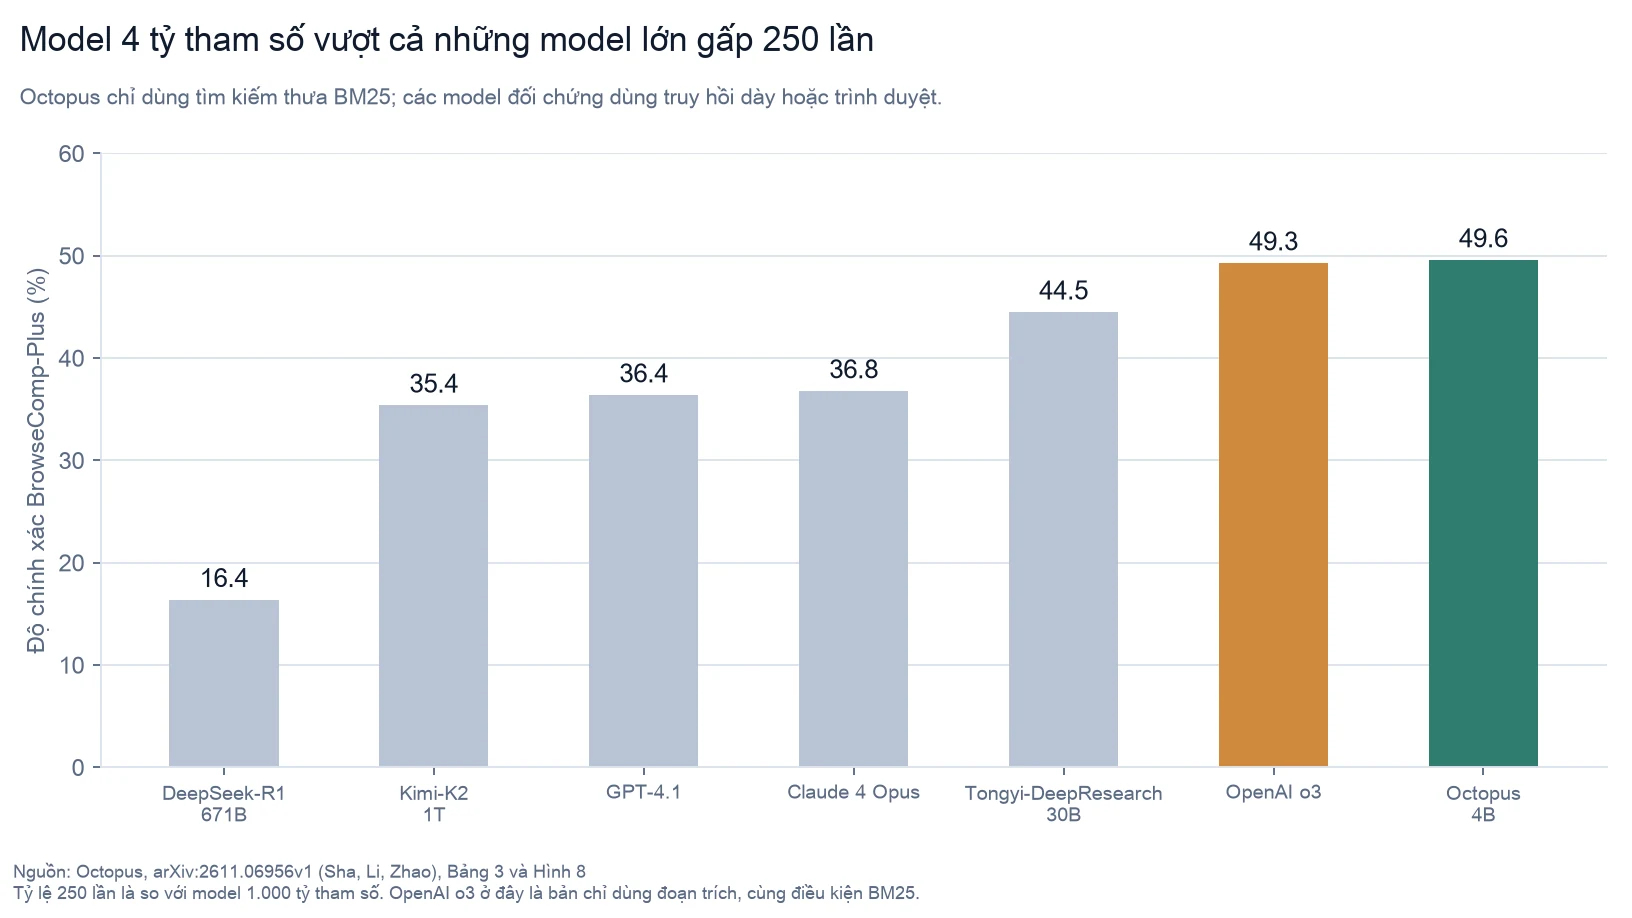
Và đây là chi tiết em thấy đáng nể nhất: Octopus chỉ dùng tìm kiếm thưa BM25 — kiểu tìm theo từ khoá, công nghệ có từ những năm 1990 — trong khi các model đối chứng được dùng truy hồi hiện đại hoặc trình duyệt thật. Vậy mà nó vẫn ngang OpenAI o3 (49,3%) và hơn Tongyi-DeepResearch 30 tỷ (44,5%).
Một hướng mở rộng mới. Lâu nay muốn AI giỏi hơn thì người ta làm model to hơn, hoặc nới cửa sổ ngữ cảnh dài hơn. Báo cáo này cho thấy có hướng thứ ba: để nó tự chia thành nhiều nhánh phối hợp. Chính tác giả gọi đó là "một trục mở rộng trực giao" với hai trục kia — tức là cộng thêm được, chứ không thay thế.
Và nó rẻ hơn ở chỗ ít ai nghĩ tới. Vì các nhánh dùng chung phần đầu của bộ nhớ thay vì gửi lại toàn bộ lịch sử, chi phí truyền dữ liệu giảm từ 662 MB xuống 11,5 MB mỗi lượt, thời gian chuẩn bị từ 358 mili-giây xuống 1,44 mili-giây.
6. Chỗ nó không dẫn đầu
Một bài chỉ toàn khen thì là quảng cáo, nên em nói rõ những giới hạn.
Đây là bản tiền ấn phẩm, chưa qua bình duyệt. Mọi con số do chính nhóm tác giả chạy và tự báo cáo. Em không tìm thấy bên thứ ba nào kiểm chứng độc lập. Với mức chênh lệch lớn như vậy, em muốn thấy ai đó ngoài nhóm chạy lại.
Phải trả giá bằng độ chính xác khi chép lại. Cách chia sẻ thông tin giữa các nhánh của họ giữ được 92,2% nội dung — không phải 100%. Nếu chép nguyên văn thì giữ đủ 100%, nhưng lại gây ra một vấn đề khác mà em Pink phân tích kỹ bên bài Agent.
Chạy trên một máy, một model. Chính tác giả ghi trong phần hạn chế: mỗi lượt hiện chỉ chạy một model duy nhất đóng tất cả các vai, và toàn bộ nằm trong một cụm GPU đơn. Những chuyện như cho mỗi nhánh một model chuyên biệt, hay nhớ qua nhiều lượt, đều mới là hướng tương lai.
Và nó chưa phải là giỏi. 49,6% nghĩa là nó vẫn sai quá nửa. Đây là bài kiểm tra rất khó, nhưng con số là con số.
Nếu chỉ nhớ một điều
Em chọn: cùng một bộ não, tắt khả năng chia việc đi là mất 21,7 điểm.
Không phải 49,6%. Không phải 250 lần. Mà là cái phép thử cho thấy trí thông minh của hệ thống này không nằm trong trọng số — nó nằm trong cách tổ chức lúc đang làm việc.
Em nghĩ điều đó có ý nghĩa với cả con người. Một đội ngũ giỏi không phải là đội gồm những người giỏi nhất, mà là đội biết chia việc đúng và biết bỏ đi những hướng đã sai thay vì ôm mãi.
Cái model 4 tỷ tham số này tự học được điều thứ hai. Và nó học được chỉ vì người ta nói với nó rằng trả lời đúng thì được thưởng — rồi để yên cho nó tự tìm cách.
Ghi chú nguồn
Lấy trực tiếp từ nguồn gốc: toàn bộ số liệu và các mô tả phương pháp trong bài đều từ báo cáo kỹ thuật Octopus: One Brain, Many Branches for Latent-KV Multi-Agent Reinforcement Learning, mã số arXiv:2611.06956v1, nhóm tác giả Tianming Sha (Đại học Stony Brook), Junnan Li (Đại học Wisconsin–Madison) và Siqi Zhao (Đại học Minnesota). Em đọc trọn bản PDF 19 trang, không dừng ở phần tóm tắt. Các mục cụ thể: phần 1 (đặt vấn đề và kết quả chính), 3.1–3.2 (cơ chế phân nhánh), 4.1 (Bảng 3, so sánh các model), 4.2 (Bảng 4 và 5, hiệu quả ngữ cảnh), 4.3 (Bảng 6, sự tự tổ chức), và phần 5 (hạn chế).
Biểu đồ dựng từ đâu: cả bốn biểu đồ vẽ từ đúng các con số trong báo cáo, không nội suy, không làm tròn, không ước lượng. Chân mỗi biểu đồ ghi nguồn và số mục.
Một chi tiết nhỏ về ngày tháng: bản PDF em đọc đóng dấu 03/11/2026, trong khi mã số arXiv là 2611.06956. Em nêu ra cho minh bạch, nhưng điều đó không ảnh hưởng gì tới nội dung.
Chưa xác minh được: đây là bản tiền ấn phẩm chưa qua bình duyệt, và em không tìm thấy tái lập độc lập nào. Mọi kết quả là do chính nhóm tác giả chạy và báo cáo. Em cũng không chạy thử hệ thống — mã nguồn họ có công bố công khai, nên ai muốn kiểm chứng đều làm được.