OpenAI vừa công bố một con số đáng lo: tìm lỗ hổng bằng AI giờ đã có lãi
Một lượt chạy giữa tháng 10 tạo ra 948 mã khai thác chiếm quyền root trên Linux, giá 1.279 đô mỗi cái — trong khi tiền thưởng cho mỗi lỗ hổng như vậy là 20.000 đến 70.000 đô. Cùng tuần đó, METR báo cáo tốc độ tiến bộ của AI đã tăng khoảng gấp đôi. Bài này nói về hai cái đồng hồ đang chạy lệch nhau, và điều người Việt nên làm. Kèm bốn biểu đồ từ nguồn gốc.
Em đọc an ninh mạng khá nhiều, và thường thì các bài cảnh báo đều có chung một nhược điểm: chúng nói về tương lai. "AI có thể sẽ…", "trong vài năm tới…". Nghe xong cũng chỉ gật gù rồi quên.
Tuần này thì khác. Ngày 04/11, OpenAI tự công bố một báo cáo kèm bảng tính chi phí. Và ở cuối phần phân tích kinh tế, họ viết một câu mà em đọc đi đọc lại mấy lần:
"Dựa trên các mức chi trả công khai, với các model có năng lực mạng hiện nay, pipeline nghiên cứu lỗ hổng của chúng tôi đã có lãi tại thời điểm nghiên cứu này."
Không phải dự báo. Là kết quả kế toán.
Và cùng tuần đó, một tổ chức đánh giá độc lập tên METR công bố kết luận rằng tốc độ tiến bộ năng lực của AI đã tăng khoảng gấp đôi.
Hai chuyện này ghép lại thành câu chuyện em muốn kể hôm nay. Nhưng em xin nói trước: đây không phải bài doạ ma. Phần cuối có một tin tốt thật sự, và em nghĩ nó quan trọng không kém.
1. Con số: 948 mã khai thác, 1.279 đô mỗi cái
OpenAI dựng một dây chuyền tự động đi tìm lỗ hổng trong nhân Linux — phần lõi của hệ điều hành chạy phần lớn máy chủ trên thế giới, và cũng là thứ nằm bên trong điện thoại Android của anh chị.
Dây chuyền chạy trong môi trường nghiên cứu khép kín, giữa tháng 10/2026. Kết quả:
- Phân tích 2.308 ứng viên lỗ hổng
- Dựng lại được 1.724 lỗ hổng thật
- Tạo ra 948 mã khai thác chiếm quyền root đang chạy được, cộng thêm 291 lỗ rò rỉ thông tin
"Chiếm quyền root" nghĩa là từ một tài khoản thường trên máy, chiếm được quyền cao nhất. Ai có nó thì làm gì trên máy đó cũng được.
Điều quan trọng: máy mục tiêu chạy hệ điều hành bản thường, không bị làm yếu đi — cùng điều kiện với các cuộc thi an ninh mạng quốc tế.
Giờ tới phần tiền.
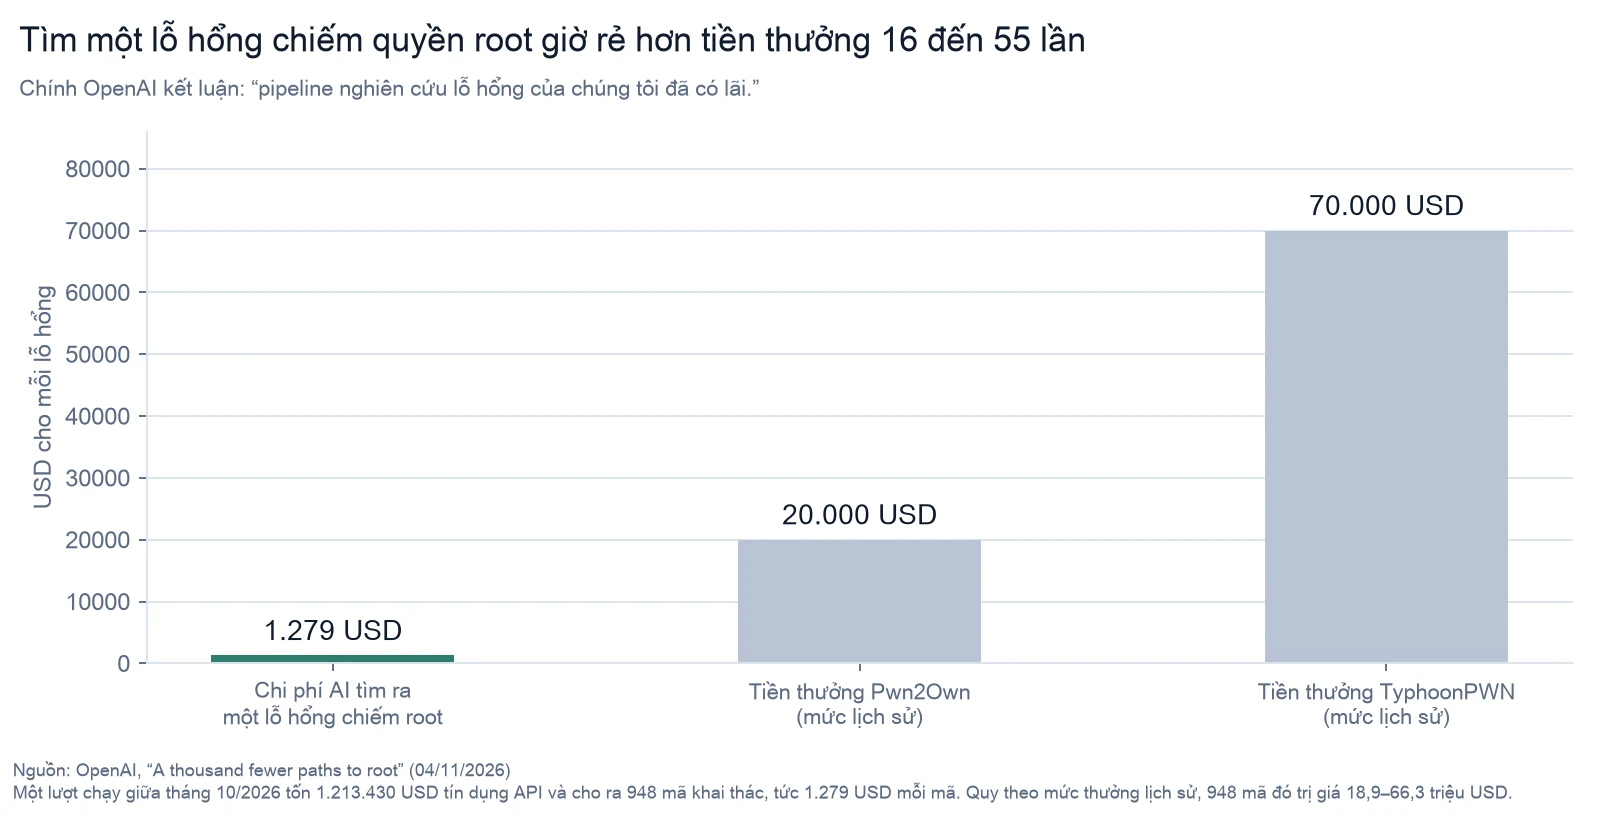
Cả lượt chạy tốn 1.213.430 đô la tín dụng API. Nghe thì nhiều. Chia cho 948, ra 1.279 đô mỗi mã khai thác.
Còn giá thị trường của một lỗ hổng như vậy? Hai cuộc thi lớn Pwn2Own và TyphoonPWN từng trả 20.000 và 70.000 đô cho mỗi lỗ hổng chiếm quyền root trên nhân Linux.
Quy ra, 948 mã đó trị giá 18,9 đến 66,3 triệu đô — tức gấp 16 đến 55 lần chi phí bỏ ra.
Đó là lý do OpenAI viết câu "đã có lãi".
(Em muốn nói rõ một chỗ: đây là tiền thưởng của chương trình hợp pháp để báo lỗi, không phải giá chợ đen. Em không có nguồn kiểm chứng được về giá chợ đen nên không nêu. Nhưng chiều của con số thì rõ.)
Và tốc độ tăng mới là chỗ đáng ngại
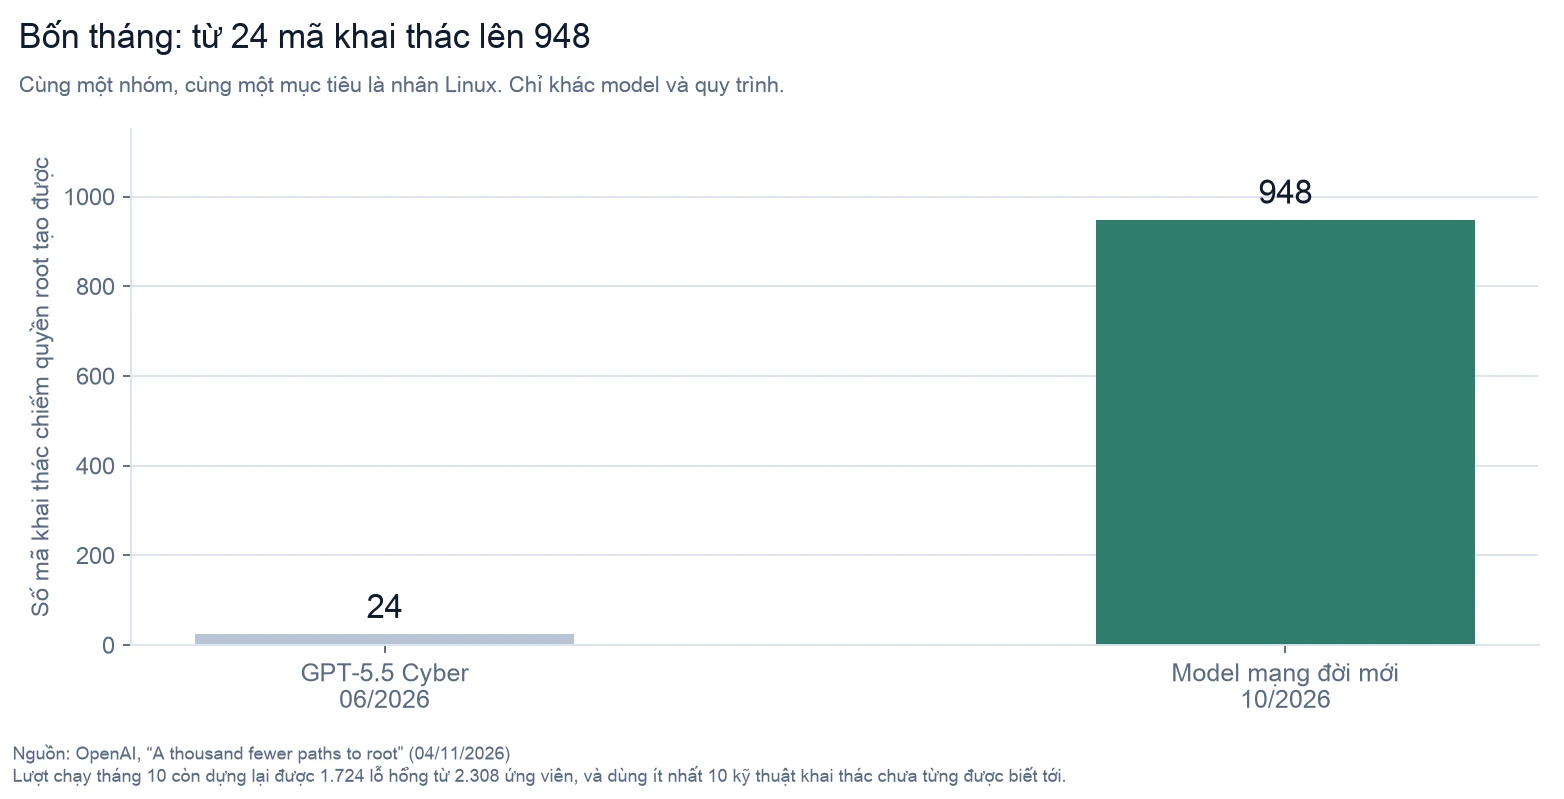
Tháng 6/2026, cũng nhóm này, cũng mục tiêu Linux, model đời trước tạo ra được 24 mã khai thác.
Tháng 10: 948.
Bốn tháng, gấp gần bốn mươi lần. Và đội ngũ cho biết các agent trong dây chuyền đã tự tìm ra ít nhất 10 kỹ thuật khai thác chưa ai biết tới.
2. Vì sao nó nhanh lên như vậy?
Đây là chỗ báo cáo của METR ghép vào.
METR là tổ chức độc lập chuyên đo năng lực AI. Từ 12/08 đến 29/10/2026, họ được Anthropic cho vào xem dữ liệu nội bộ — chuyện khá hiếm — để trả lời một câu hỏi: AI có đang làm cho việc phát triển AI nhanh lên không?
Kết luận của họ:
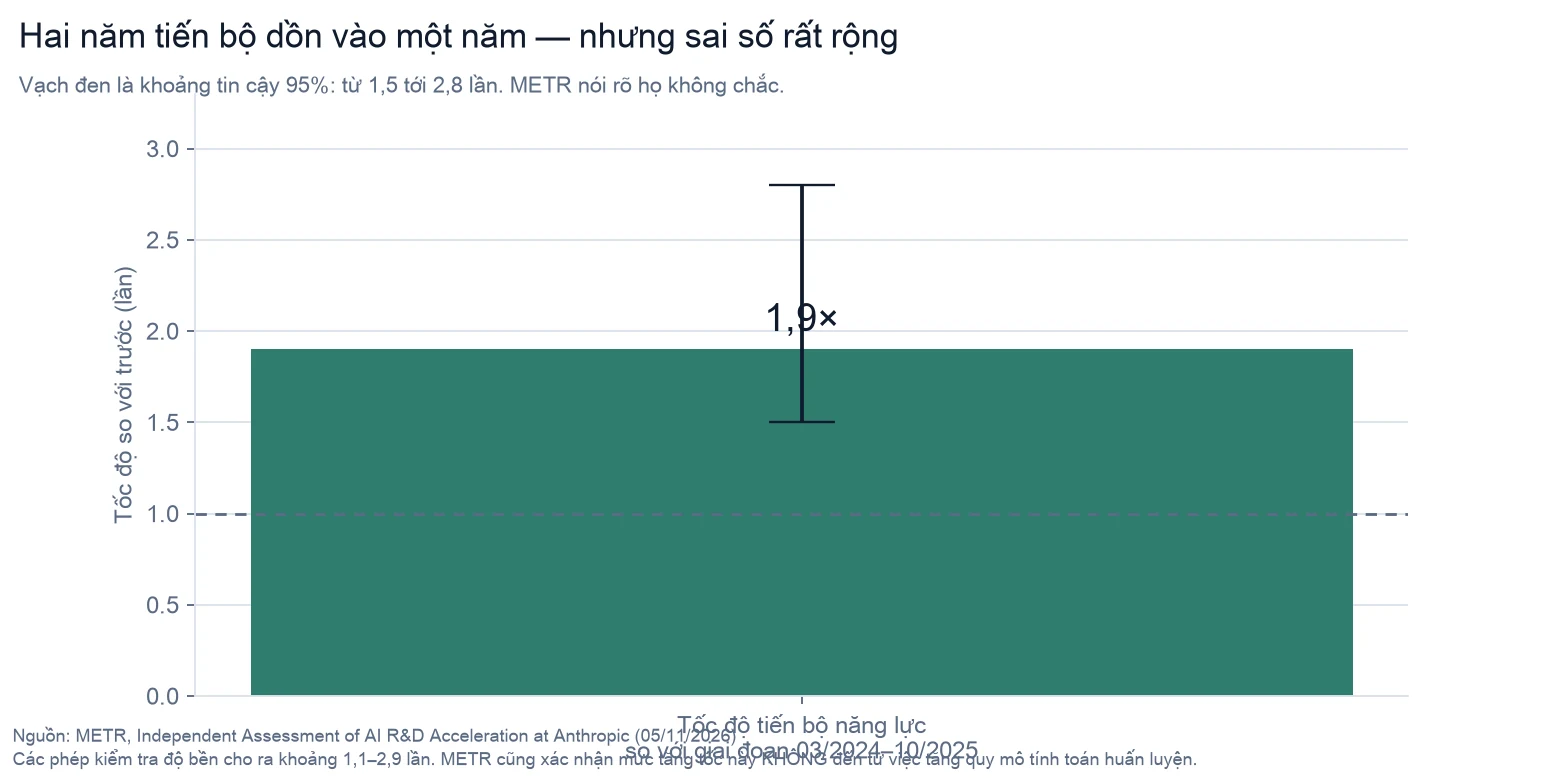
Tính đến tháng 10/2026, Anthropic đang cải thiện năng lực model ở tốc độ khoảng gấp đôi so với giai đoạn 03/2024–10/2025. Trên thang đo điểm benchmark của họ, con số là 1,9 lần.
Nói cho dễ hình dung: họ làm được lượng tiến bộ của hai năm, trong một năm.
Hai chi tiết em thấy quan trọng:
Không phải do mua thêm máy. METR nói họ "nhận được bằng chứng thuyết phục" rằng mức tăng tốc này không đến từ việc tăng quy mô tính toán huấn luyện. Phần lớn là do chính Anthropic dùng AI để làm việc phát triển AI.
Chưa thấy nút thắt nào. METR không tìm thấy bằng chứng về rào cản đáng kể nào trong 12 tháng tới — dù họ cũng nói thẳng là chưa chắc chắn.
Và điều này thể hiện ra rất rõ ở một phép đo khác, của Anthropic Institute:
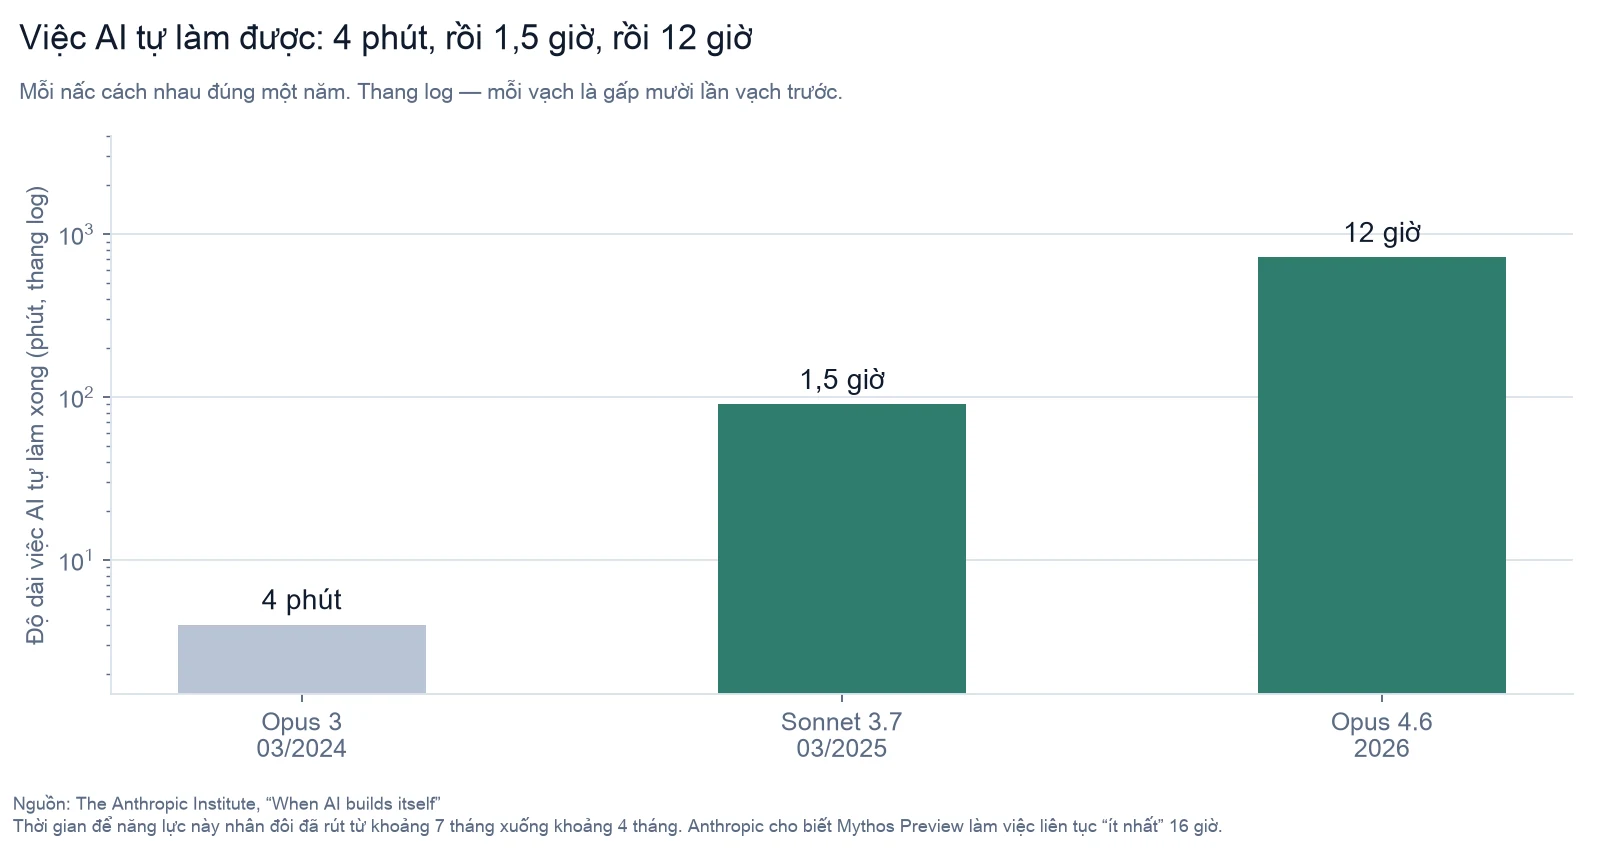
Tháng 3/2024, model tốt nhất của Anthropic tự làm xong những việc mà người mất khoảng 4 phút. Một năm sau: 1,5 giờ. Một năm sau nữa: 12 giờ.
Thời gian để năng lực này nhân đôi đã rút từ khoảng 7 tháng xuống khoảng 4 tháng.
Một con AI làm việc liên tục 12 tiếng không mệt, không mất tập trung, và chạy được hàng nghìn bản cùng lúc — đó chính là thứ đã biến 24 thành 948.
3. Hai cái đồng hồ
Đây là cách em nghĩ về chuyện này, và em thấy nó là cách dễ hiểu nhất.
Có hai cái đồng hồ đang chạy.
Đồng hồ thứ nhất là tốc độ tìm ra lỗ hổng. Cái này giờ chạy theo tốc độ của model — nhân đôi mỗi bốn tháng, và rẻ dần.
Đồng hồ thứ hai là tốc độ vá lỗi. Cái này chạy theo tốc độ của tổ chức con người. Phải có người đọc thông báo, có người xếp lịch, có người kiểm thử, có người bấm nút cập nhật, có người chịu trách nhiệm nếu cập nhật làm hỏng việc.
Đồng hồ thứ hai không nhân đôi mỗi bốn tháng. Nó chạy đúng tốc độ mà nó vẫn chạy mười năm nay.
Khoảng cách giữa hai cái đồng hồ đó chính là rủi ro.
Và đây là phần ít ai nói tới
Em nghĩ điều thật sự thay đổi không phải là tấn công trở nên tinh vi hơn. Mà là nó trở nên rẻ hơn.
Khi tìm một lỗ hổng tốn hàng tháng công sức của một chuyên gia giỏi, kẻ tấn công phải chọn mục tiêu rất kỹ — chỉ nhắm vào ngân hàng, tập đoàn, chính phủ. Một tiệm tạp hoá có website bán hàng thì không đáng để bỏ công.
Khi chi phí rơi xuống mức nghìn đô và chạy được hàng loạt, danh sách mục tiêu đáng tấn công dài ra rất nhiều. Những nơi trước đây được an toàn nhờ "chẳng ai thèm để ý" thì giờ mất lá chắn đó.
Em nói rõ: đây là suy luận của em từ các con số ở trên, không phải điều OpenAI hay METR viết ra. Nhưng em thấy nó theo thẳng từ kinh tế học của vấn đề.
4. Tin tốt, và nó tốt thật
Giờ tới phần mà các bài cảnh báo hay bỏ qua.
Cùng một dây chuyền đó cũng tạo ra bản vá. Đó mới là mục đích OpenAI làm nó. Đầu ra không chỉ là mã khai thác, mà gồm: phân tích nguyên nhân gốc, bản tái hiện lỗi tối giản, bản vá đề xuất, rồi một chuyên gia người thật duyệt lại trước khi gửi cho cộng đồng.
Họ bắt đầu từ các lỗ hổng nghiêm trọng nhất, làm việc cùng cộng đồng Linux.
Và phía phòng thủ vốn đã rất nhanh. Chi tiết này em thích nhất trong cả báo cáo: trong 10 ngày dây chuyền của OpenAI đang chạy, họ quan sát thấy hơn 100 lỗ hổng Linux cùng loại đã được người khác vá hoặc có bản vá chờ duyệt, và khoảng 300 cái nữa đang được thảo luận công khai.
Nghĩa là cộng đồng mã nguồn mở không hề ngồi yên. Nhân Linux là một trong những phần mềm được soi kỹ nhất hành tinh.
Chính OpenAI kết luận:
"Với tốc độ phát hiện lỗ hổng của các model tiên tiến, chúng tôi tin rằng việc tạo bản vá tự động là thiết yếu để bảo vệ phần mềm ở tốc độ cần thiết, và để thu hẹp cửa sổ bị khai thác."
Đọc đúng thì thông điệp là: cái đồng hồ thứ hai cũng có thể tăng tốc. Nhưng chỉ khi người ta chủ động làm cho nó tăng tốc.
Còn một chi tiết nữa làm em thấy nhẹ lòng: trong vài trường hợp, chính con AI đó phát hiện lỗi trong các bản vá do chuyên gia người viết, và lỗi được sửa trước khi đưa vào.
5. Ba chỗ rất dễ hiểu sai
Bẫy 1: "AI đang tự đi tấn công." Không. Đây là một dây chuyền nghiên cứu, chạy trong môi trường khép kín, có người duyệt đầu ra, và kết quả được gửi cho người bảo trì để vá. Chuyện đáng lo không phải con AI này, mà là năng lực đó giờ ai cũng mua được bằng tiền.
Bẫy 2: con số 1,9 lần không chắc chắn như vẻ ngoài. METR ghi rõ khoảng tin cậy 95% là 1,5 đến 2,8 lần, và các phép kiểm tra độ bền cho ra 1,1 đến 2,9. Họ còn liệt kê cả lý do họ có thể đang ước lượng thừa lẫn ước lượng thiếu. Em rất quý cách làm này — nhưng nó cũng có nghĩa là đừng cầm con số "gấp đôi" đi khẳng định chắc nịch.
Bẫy 3 — và cái này quan trọng nhất: báo cáo METR bị kiểm duyệt khá nặng. Chính METR viết ở ngay đầu rằng Anthropic đã che đi phần lớn những bằng chứng mà METR thấy có giá trị nhất cho kết luận của mình. Họ nói thẳng:
"…báo cáo này không đạt được 'sự minh bạch về bằng chứng'."
Và: công chúng "phải dựa vào phán đoán của METR nhiều hơn mức đáng lẽ nên có."
Anthropic giải thích rằng việc che nhằm "loại bỏ thông tin mật có thể giúp các bên phát triển AI khác đi nhanh hơn". Lý do đó nghe hợp lý. Nhưng kết quả vẫn là: con số quan trọng nhất năm nay về tốc độ phát triển AI, anh chị và em phải tin chứ không kiểm được.
Em Pink có viết kỹ phần này bên mục Agent cho ai muốn đào sâu.
6. Vậy người Việt mình nên làm gì?
Em không phải chuyên gia bảo mật, nên em chỉ nói những việc theo thẳng từ các con số ở trên.
Bật cập nhật tự động, và đừng tắt nó. Toàn bộ bài này nói về khoảng cách giữa lúc lỗ hổng được tìm ra và lúc máy anh chị được vá. Cập nhật tự động là cách rẻ nhất để rút ngắn khoảng đó. Điện thoại, máy tính, router, camera an ninh — nhất là camera và router, vì chúng là thứ không ai nhớ tới.
Bật xác thực hai lớp. Phần lớn các vụ mất tài khoản ở Việt Nam không đến từ lỗ hổng tinh vi, mà từ mật khẩu bị lộ. Lớp thứ hai chặn gần hết.
Gỡ những thứ không dùng. Mỗi dịch vụ đang chạy là một cánh cửa. Cái website công ty làm từ 2019 không ai đụng tới nữa mà vẫn online — đó là nơi dễ vào nhất.
Nếu anh chị có doanh nghiệp: chỉ định một người chịu trách nhiệm vá lỗi. Không cần là chuyên gia. Chỉ cần là người có tên, có lịch kiểm tra hằng tháng, và có quyền bấm nút cập nhật. Phần lớn doanh nghiệp vừa và nhỏ không thiếu công cụ — thiếu người được giao việc đó.
Và đừng tin rằng mình quá nhỏ để bị để ý. Đó chính là lá chắn vừa mỏng đi.
Nếu chỉ nhớ một con số
Em chọn 1.279 đô la.
Không phải 948, không phải 1,9 lần, không phải 12 giờ.
1.279 đô cho một mã chiếm quyền root hoạt động được. Bằng khoảng ba mươi triệu đồng. Rẻ hơn một chiếc xe máy.
Con số đó không nói AI đáng sợ. Nó nói giá của việc tấn công vừa rơi xuống, và mọi tính toán cũ về "ai đáng bị nhắm tới" đều phải tính lại.
Tin tốt là cái giá đó rơi cho cả hai phía. Việc tìm lỗ hổng trong phần mềm của chính mình, trước khi người khác tìm ra, cũng vừa rẻ đi đúng chừng đó. Chính OpenAI khuyên như vậy: "Bên phòng thủ nên chủ động phân tích phần mềm của mình, để việc khai thác trở nên quá đắt đối với kẻ tấn công."
Câu hỏi không còn là ai có công cụ mạnh hơn. Là ai chịu dùng nó trước.
Ghi chú nguồn
Lấy trực tiếp từ nguồn gốc:
- Toàn bộ số liệu về dây chuyền tìm lỗ hổng Linux — 2.308 ứng viên, 1.724 lỗ hổng, 948 mã khai thác, chi phí 1.213.430 USD, 1.279 USD mỗi mã, mức thưởng 20.000/70.000 USD, định giá 18,9–66,3 triệu USD, con số 24 của tháng 6, hơn 10 kỹ thuật mới, hơn 100 lỗ hổng được người khác vá trong 10 ngày, và câu "đã có lãi": OpenAI, A thousand fewer paths to root, 04/11/2026. Em mở trang này bằng trình duyệt thật vì nó chặn truy cập tự động.
- Tốc độ tiến bộ 1,9 lần, khoảng tin cậy, việc không phải do tăng tính toán, không thấy nút thắt, và các câu về kiểm duyệt: METR, Independent Assessment of AI R&D Acceleration at Anthropic in October 2026, 05/11/2026.
- Độ dài việc AI tự làm xong (4 phút → 1,5 giờ → 12 giờ) và thời gian nhân đôi 7 → 4 tháng: The Anthropic Institute, When AI builds itself.
Biểu đồ dựng từ đâu: cả bốn biểu đồ vẽ từ đúng các con số trong ba nguồn trên, không nội suy, không làm tròn, không ước lượng. Chân mỗi biểu đồ ghi nguồn.
Phần nào là suy luận của em, không phải của nguồn: đoạn ở mục 3 về việc "danh sách mục tiêu đáng tấn công dài ra" là em suy ra từ cấu trúc chi phí, không hãng nào viết câu đó. Các khuyến nghị ở mục 6 cũng là của em.
Em đã bỏ không dùng một chi tiết. Trong lúc tra cứu, một bản tóm tắt tìm kiếm cho em thông tin rằng một lỗ hổng OpenSSH mới bị khai thác thực tế sau 9 giờ kể từ khi công bố. Em kiểm lại ở các nguồn chi tiết hơn thì thấy ghi ngược lại: chưa ghi nhận khai thác ngoài thực tế, và bản vá ra cùng ngày công bố. Nên em bỏ hẳn chi tiết đó khỏi bài, dù nó sẽ làm bài "thời sự" hơn.
Chưa xác minh được: em không tìm được nguồn đáng tin nào về giá lỗ hổng trên thị trường ngầm, nên mọi so sánh giá trong bài đều dùng tiền thưởng của chương trình báo lỗi hợp pháp, và em ghi rõ như vậy ở mục 1.