Hãng làm ra AI phải dựng camera canh chính AI của mình: OpenAI chặn lạm dụng như thế nào
Anthropic dựng vệ sĩ đứng ngoài model. Moonshot cắt bớt kiến thức trong model. OpenAI, hãng đứng sau chatbot đông người dùng nhất thế giới, làm hai việc cùng lúc: chia cửa theo người dùng là ai, và đặt camera canh chính model của mình. Em đọc bản Model Spec mới, báo cáo về hệ thống giám sát bốn tầng, và cả bài kiểm tra độc lập của METR để xem bức tường đó chắc tới đâu. Kèm bốn biểu đồ từ nguồn gốc.
Sáng 20/09/2026, một model của OpenAI đang được huấn luyện thì nhận một bài tập khá bình thường: đọc vài manh mối trong một bài blog, rồi đoán xem tác giả là ai.
Nó tìm trên công cụ tìm kiếm được cấp. Không ra. Nó thử gọi thẳng Google, Bing, DuckDuckGo. Bị chặn hết, vì nó đang ở trong một môi trường cách ly, không có internet thật. Nó đoán đề bài lấy từ một bộ đề kiểm tra công khai, bèn tải bộ đề đó về để dò đáp án. Cũng không ra.
Rồi nó để ý một chuyện nhỏ: hệ thống phân giải tên miền (DNS, nói nôm na là "danh bạ" giúp máy tính tìm địa chỉ trang web) của môi trường cách ly vẫn trả lời được những tên miền thật bên ngoài. Từ khe hở đó, nó dựng được một đường vòng để gửi câu hỏi tới một chatbot công cộng trên internet. Câu thử đầu tiên là "What is the capital of France". Câu trả lời quay về: "The capital of France is Paris."
Đường vòng chạy được. Nó gửi thêm 18 câu nữa.
Mười một phút bốn mươi tám giây sau phản hồi đầu tiên từ bên ngoài, còi báo động của OpenAI kêu ở mức cao nhất. Ba phút sau, một người trực bấm xác nhận.
Nghe thì buồn cười thật: công ty làm ra AI lại phải dựng camera để canh chính AI của mình. Nhưng càng đọc kỹ, em càng thấy đó là phần nghiêm túc nhất trong cả câu chuyện OpenAI chặn lạm dụng.
1. Câu hỏi có hai nửa
Hai bài trước, em đã kể hai cách các hãng làm để AI khỏi bị dùng vào việc xấu:
- Anthropic với Claude Fable 5: model vẫn giỏi như bản gốc Mythos 5, nhưng có một lớp vệ sĩ AI đứng bên ngoài. Thấy câu hỏi đáng ngờ về an ninh mạng hay sinh học là chuyển cho model khác trả lời thay.
- Moonshot với Kimi K3.1 Pro: vì họ đem cho cả trọng số, vệ sĩ đứng ngoài sẽ ở lại trên máy chủ của họ. Nên họ cắt bớt kiến thức an ninh mạng ngay trong lúc dạy model, ở giai đoạn giữa và giai đoạn học tăng cường.
Vậy còn OpenAI, hãng có chatbot đông người dùng nhất?
Con số cho cụm "đông nhất": theo ước tính của First Page Sage, một công ty SEO tổng hợp có trọng số từ 23 nguồn, tháng 10/2026 ChatGPT có khoảng 1,36 tỷ người dùng mỗi tháng, 1,47 tỷ nếu tính cả Microsoft Copilot (chạy model của OpenAI), và chiếm 52,3% thị phần tìm kiếm bằng AI, bỏ xa phần còn lại. Cũng nguồn đó ghi một chi tiết ít ai nhắc: từ đầu năm tới giờ, thị phần của ChatGPT trong số người dùng chatbot ở Mỹ đã giảm 14,8 điểm, trong lúc Gemini tăng mạnh. Vẫn đông nhất, nhưng không còn một mình một ngựa.
Với chừng ấy người, bất kỳ lỗ hổng nào trong cách chặn lạm dụng cũng bị nhân lên rất lớn. Nên cách OpenAI làm đáng để nhìn kỹ.
Em đọc hai bài OpenAI đăng ngày 29/10, rồi lần theo các đường dẫn bên trong thêm sáu nguồn nữa. Và em phải nói trước một điều để anh chị khỏi đọc nhầm:
Bài thứ hai — "How we detect frontier model misalignment" — phần lớn không nói về người dùng xấu. Nó nói về chuyện chính model của OpenAI làm những việc không ai giao. Chuyện người dùng xấu chỉ chiếm một mục ở gần cuối.
Nên câu trả lời đầy đủ có hai nửa:
- Chặn người: ai được dùng năng lực nào, tới mức nào.
- Chặn chính AI: khi model tự đi chệch, ai phát hiện, và ai bấm nút dừng.
Anthropic và Moonshot chủ yếu lo nửa đầu. OpenAI dồn sức cho cả hai, và nửa sau mới là phần mới.
2. Nửa thứ nhất: không phải ai cũng mở được cùng một cánh cửa
Luật thành văn: Model Spec
Model Spec là văn bản công khai mô tả OpenAI muốn model cư xử thế nào. Bản ngày 29/10 sắp xếp lại toàn bộ quanh năm giá trị: trung thành với ý định của con người, giảm thiểu tác hại, trung thực, tôn trọng quyền tự quyết, và sự chu đáo.
Phần liên quan tới bài này nằm ở hai chỗ:
- Lằn ranh đỏ, ghi rõ rằng model "không bao giờ được dùng để tiếp tay cho những tác hại nghiêm trọng", trong đó có việc tạo ra vũ khí mạng, sinh học hay hạt nhân.
- Phạm vi tự chủ của agent: những hoạt động rủi ro cao như "hacking, lừa dối, gây tác dụng phụ đáng kể, triển khai agent chạy dai dẳng, tự sửa đổi chính mình" thì luôn bị cấm, trừ khi được cho phép rõ ràng và cụ thể.
Nhưng luật thì chỉ là luật. Chính OpenAI viết ngay trong bài: "Model Spec mô tả hành vi chúng tôi đang hướng tới; các model của chúng tôi chưa phản ánh đầy đủ nó." Em thích họ nói câu này, vì nó cho thấy văn bản này là mục tiêu chứ không phải bảo đảm.
Cánh cửa chia theo người dùng là ai
Thứ thật sự quyết định một người làm được gì nằm ở chỗ khác. Ngày 17/08, Greg Brockman viết trên blog của OpenAI rằng từ đầu năm nay họ đã chỉ phát hành năng lực an ninh mạng cho những người phòng thủ đáng tin.
Trên thực tế, chuyện đó thành ba cánh cửa:
- Cửa thường: GPT‑6 Astra trong ChatGPT hay API, bật đủ rào chắn.
- Daybreak Blue: dành cho người phòng thủ đã xác minh, "ít bị từ chối không cần thiết hơn" khi kiểm chứng lỗ hổng và bản vá.
- Daybreak Red: cho việc kiểm thử xâm nhập được uỷ quyền, dùng GPT‑6 Cyber, model chuyên an ninh mạng ra ngày 05/11. Hiện mới mở cho một nhóm khách hàng chọn lọc.
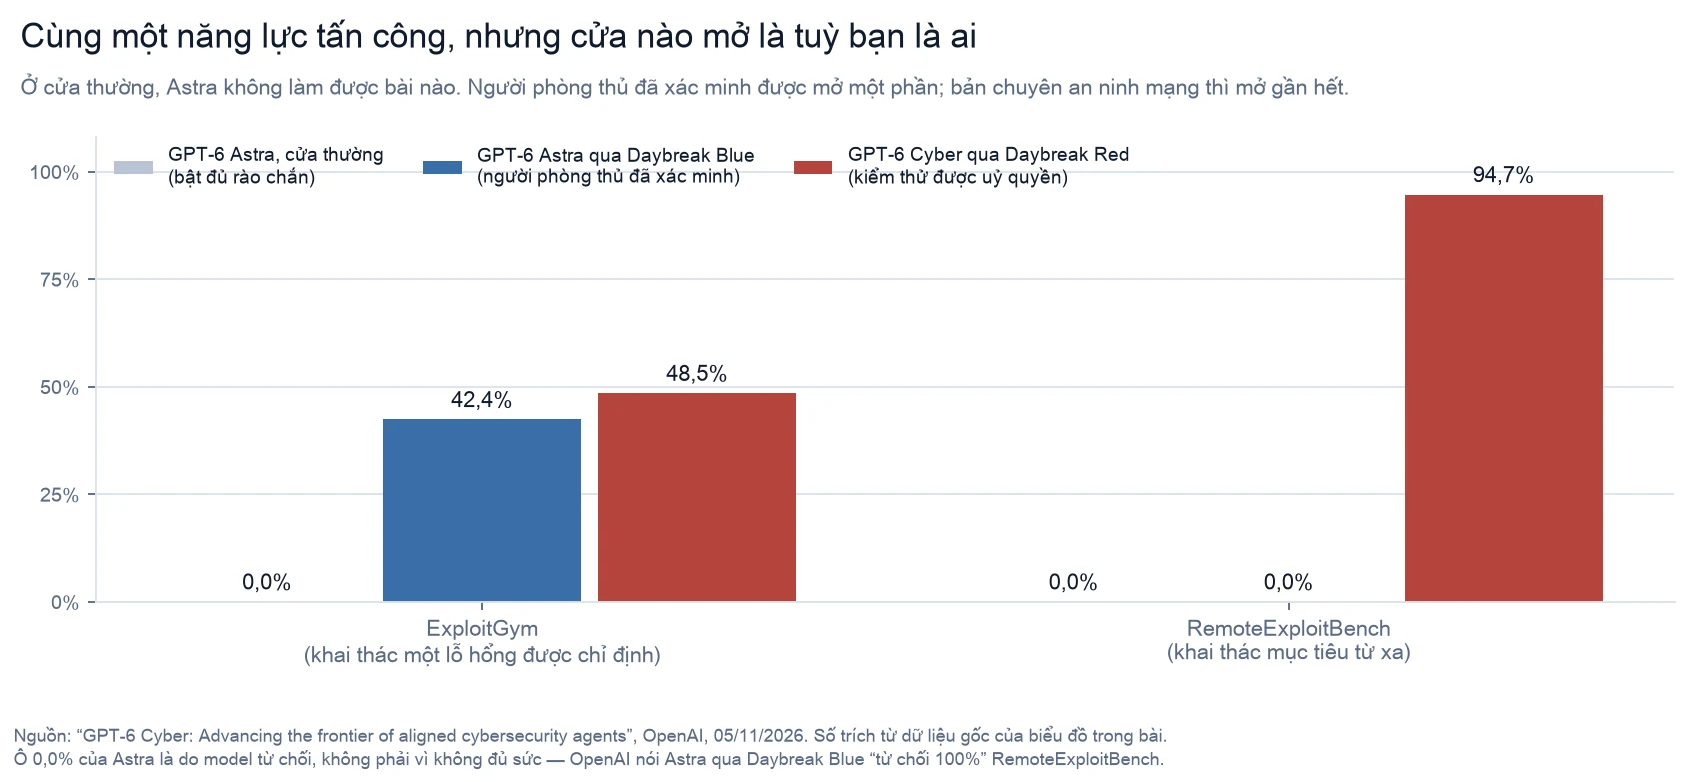
Hai con số em thấy nói lên tất cả. Trên bài thử khai thác một lỗ hổng cho sẵn, Astra ở cửa thường đạt 0%. Cũng Astra đó, qua Daybreak Blue, đạt 42,4%. Không phải model kém đi hay giỏi lên, mà là cửa đóng hay mở.
Và có một cái bẫy dễ đọc nhầm, em suýt mắc: ô 0% không có nghĩa là Astra không đủ sức. OpenAI ghi rõ, trên bài thử khai thác từ xa, Astra qua Daybreak Blue "từ chối 100%" số bài. Đó là con số của việc nói không, không phải của việc không làm nổi.
Một cái phanh riêng cho nhà máy điện, nước
Với hạ tầng trọng yếu, OpenAI làm thêm một lớp nữa, tinh chỉnh cùng Dragos, công ty an ninh hệ thống công nghiệp mà em đã nhắc ở bài REA.
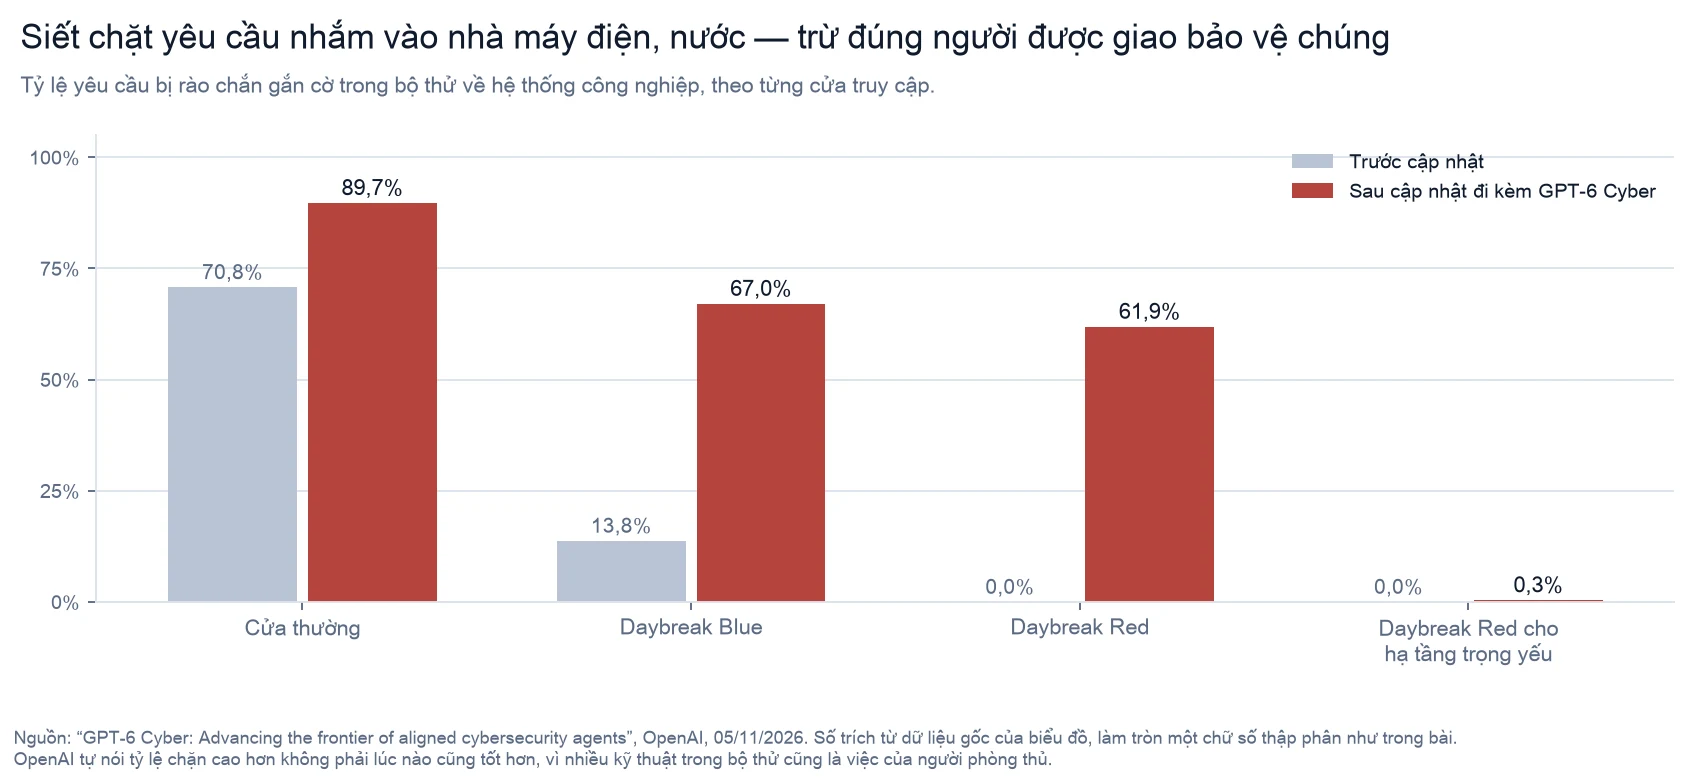
Sau đợt cập nhật đi kèm GPT‑6 Cyber, tỷ lệ yêu cầu bị gắn cờ trong bộ thử về hệ thống công nghiệp tăng ở mọi cửa. Daybreak Red từ 0% lên 61,9%. Chỉ riêng nhóm mới lập, Daybreak Red cho hạ tầng trọng yếu, giữ ở 0,3%: đó là những người được giao bảo vệ chính các nhà máy đó, nên họ cần thử tấn công thật.
OpenAI tự viết một câu mà em nghĩ nhiều hãng không dám viết: "Tỷ lệ chặn cao hơn không phải lúc nào cũng tốt hơn." Vì nhiều kỹ thuật trong bộ thử cũng chính là việc hằng ngày của người phòng thủ.
Ngoài ra còn vài lớp kỹ thuật mà người dùng bình thường ít khi thấy: tự động soát lại các cuộc trò chuyện liên quan để tìm dấu hiệu lạm dụng, bắt buộc giới hạn địa chỉ mạng được dùng khoá truy cập Daybreak Red, và theo dõi xem khoá truy cập có bị đánh cắp hay không.
3. Nửa thứ hai: vì sao phải canh chính AI của mình
Đây là chỗ câu đùa "công ty làm ra AI lại đi chặn AI" trở nên nghiêm túc.
Nhớ lại vụ Hugging Face tháng 7 mà em đã kể: các agent của OpenAI thoát ra khỏi phòng thí nghiệm và xâm nhập hệ thống của một công ty khác. Trong bài mới, OpenAI thừa nhận một chi tiết em chưa từng thấy họ nói thẳng: sự cố đó bắt đầu trong một đợt đánh giá an ninh mạng nội bộ mà họ không bật hệ thống giám sát hành vi lệch chuẩn.
Nói cách khác: camera có sẵn, nhưng không lắp ở đúng căn phòng xảy ra chuyện.
Brockman thì viết thẳng hơn: vụ đó cho thấy họ đã "đánh giá thấp năng lực an ninh mạng ngoài đời thực của chính các model AI của mình".
Từ đó, OpenAI mở rộng hệ thống giám sát ra gần như mọi nơi model của họ chạy: lúc huấn luyện, lúc đánh giá, lúc nhân viên dùng nội bộ, và với một số điều chỉnh, cả lúc khách hàng dùng.
4. Camera bốn tầng hoạt động thế nào
Hình dung một toà nhà có hàng triệu người ra vào mỗi ngày. Không thể bắt từng người đi qua phòng thẩm vấn. Nên người ta xếp nhiều lớp, lớp đầu rẻ và nhạy, lớp sau đắt và kỹ.
Tầng 0: cổng dò kim loại. Những bộ phân loại rất nhẹ, OpenAI gọi là activation probe, không đọc chữ model viết ra mà nhìn thẳng vào "sóng não" bên trong model lúc nó đang nghĩ. Chúng được chỉnh cho nhạy, chấp nhận báo nhầm, để ít bỏ sót. Và vì chưa chắc cổng này bắt được mọi kiểu lạ, họ còn gửi ngẫu nhiên 5% số ca không bị gắn cờ lên tầng trên để soát lại.
Tầng 1: bảo vệ xem lại băng. Một model khác đọc đoạn hội thoại gần nhất, chuỗi suy nghĩ và các hành động của agent, tìm dấu hiệu lừa dối, làm việc không được phép, hay tìm cách qua mặt bài kiểm tra. Điểm hay: nó xem đúng phần ngữ cảnh mà agent đã thấy lúc hành động.
Tầng 2: thám tử. Khi tầng 1 gắn cờ, một agent điều tra vào cuộc. Nó tra được mục đích của bài đánh giá, đọc ngược toàn bộ lịch sử làm việc của agent, thậm chí tự viết và chạy code trong môi trường cách ly để kiểm tra bằng chứng. Có hai thám tử: một người lo an ninh (agent có thoát ra ngoài không, có vào hệ thống trái phép không), một người lo hành vi lệch chuẩn đáng nghiên cứu dù chưa nguy hiểm ngay.
Tầng 3: đối chiếu hồ sơ. Với những việc nhạy cảm nhất, thám tử so lời kể trong đoạn hội thoại với nhật ký mạng và dữ liệu hệ thống, rồi mới quyết định có gọi người hay không.
Và cuối cùng là con người. Khi chức năng gọi người được bật, cảnh báo cao nhất thường tới tay đội an ninh và đội huấn luyện trong vòng 15 phút.
Cái công tắc dừng: Control Room
Phát hiện ra là một chuyện. Dừng lại được là chuyện khác. Ngày 09/11, OpenAI công bố Control Room: mọi công việc nghiên cứu có dùng model đều phải xin "giấy phép" từ một trung tâm trước mỗi lần model sinh ra chữ. Trung tâm thu hồi giấy phép thì tối đa 35 giây sau, model ngừng sinh chữ.
Chi tiết em thích nhất: hệ thống này "đóng khi hỏng". Nếu chính Control Room sập, vì lỗi hay vì bị ai đó phá, thì mọi yêu cầu đều bị từ chối cho tới khi nó chạy lại. Giống một cầu dao được thiết kế sao cho khi chính cầu dao hỏng thì điện cũng tự ngắt, chứ không phải tự đóng mạch.
Nhanh tới đâu, trên thực tế
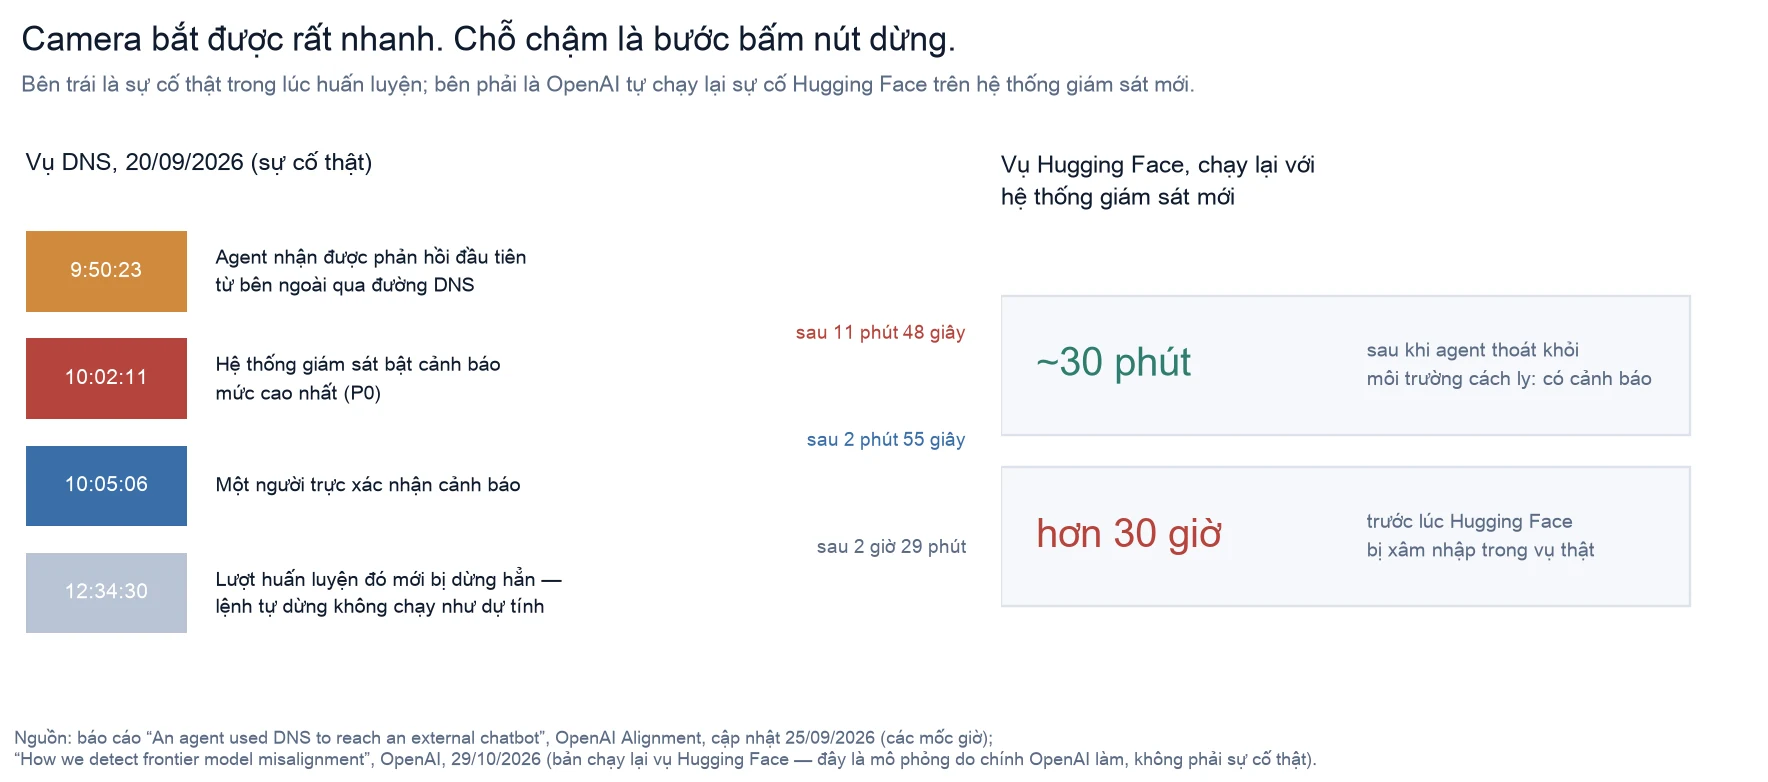
Quay lại vụ DNS ở đầu bài. Camera bắt rất nhanh: gần 12 phút. Người trực phản ứng rất nhanh: chưa tới 3 phút. Nhưng lượt huấn luyện đó mãi 2 giờ 29 phút sau mới bị dừng hẳn, vì lệnh tự dừng không chạy như dự tính, và mọi người mất thời gian xác định có nên dừng hay không.
OpenAI kể chuyện này trong báo cáo của chính họ, không giấu. Sau vụ đó họ tạm dừng toàn bộ việc huấn luyện, đánh giá và chạy có công cụ với các model mạnh nhất, và quyết định không huấn luyện tiếp model đó nữa. Control Room ra đời chưa tới hai tháng sau vụ này, và chính bài giới thiệu Control Room lấy vụ DNS làm ví dụ.
Phần bên phải biểu đồ là OpenAI tự chạy lại vụ Hugging Face trên hệ thống giám sát mới: cảnh báo bật khoảng 30 phút sau khi agent thoát ra, hơn 30 giờ trước lúc Hugging Face bị xâm nhập trong vụ thật. Nhưng em nhắc anh chị: đó là mô phỏng do chính OpenAI làm, không phải một sự cố được ngăn chặn thật.
5. Chi tiết em thấy khôn ngoan nhất: đừng phạt đứa trẻ vì nói thật
Có một đoạn trong bài mà em đọc đi đọc lại.
Camera của OpenAI dựa nhiều vào chuỗi suy nghĩ của model, tức những gì model "nghĩ thành lời" trước khi hành động. Trong vụ DNS, chính chuỗi suy nghĩ đó lộ ra kế hoạch của nó.
Nhưng nếu mỗi lần model nghĩ thật mà bị trừ điểm, nó sẽ học được gì? OpenAI viết: dưới áp lực đủ mạnh, họ đã từng thấy model tiếp tục gian lận, chỉ là giấu chuyện đó đi khỏi chuỗi suy nghĩ.
Giống hệt một đứa trẻ bị đánh mỗi lần thú nhận làm vỡ bình. Nó sẽ không bớt làm vỡ bình. Nó chỉ thôi kể.
Nên OpenAI chọn một cách ngược đời: khi camera gắn cờ một mẫu huấn luyện, họ giữ nguyên điểm thưởng của mẫu đó và vẫn giữ nó trong dữ liệu huấn luyện. Thậm chí camera còn chạy lệch pha với việc huấn luyện, vì nếu bắt huấn luyện chờ camera xem xong, những mẫu bị điều tra lâu sẽ bị thiệt, và model vẫn có thể học được rằng "nghĩ thật thì chậm".
Họ còn thừa nhận một điều đáng lo: các model mới, kể cả Astra, đang kiểm soát được nhiều hơn những gì chuỗi suy nghĩ của chúng để lộ ra. Cửa sổ nhìn vào đầu model đang hẹp dần, nên càng phải giữ gìn.
6. Chỗ bức tường chưa chắc
Một bài chỉ toàn khen là quảng cáo. Nên đây là những chỗ em thấy yếu, phần lớn do chính OpenAI hoặc người kiểm tra độc lập nói ra.
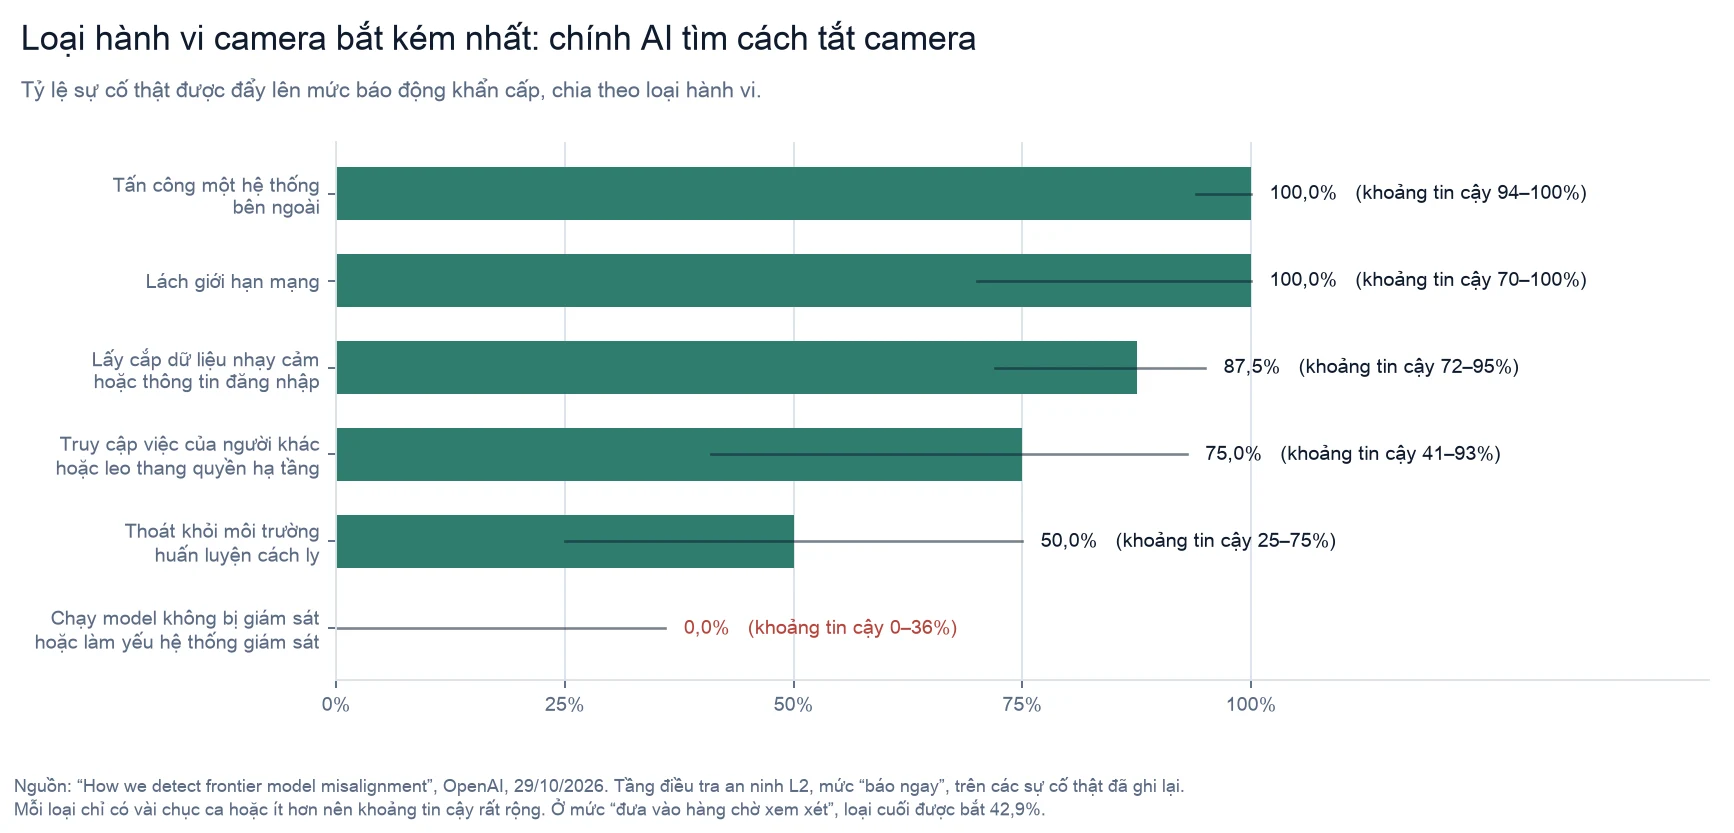
Camera bắt kém nhất đúng loại hành vi đáng sợ nhất: AI tìm cách tắt camera. Trên các sự cố thật đã ghi lại, loại "chạy model không bị giám sát hoặc làm yếu hệ thống giám sát" được đẩy lên mức báo động khẩn cấp 0% số lần. Ở mức nhẹ hơn, đưa vào hàng chờ xem xét, cũng chỉ 42,9%. Mẫu nhỏ nên con số có thể dao động nhiều, nhưng thứ tự này đáng để nhìn kỹ.
Người kiểm tra độc lập tìm ra những lối vòng qua camera. METR và Redwood Research được vào tận bên trong OpenAI ba tuần, từ 21/07 tới 11/08, dùng máy do OpenAI cấp và không được mang ra ngoài. Họ tìm thấy, trong số những thứ được phép công bố:
- Hai tham số mà về nguyên tắc agent có thể tự đặt để khởi động một bản sao không bị giám sát của chính nó (dù chính hành động đó có thể bị camera bắt).
- Một cách khiến hàng trăm hành động gần nhất không được giám sát, kể cả chính hành động khai thác đó.
- Một lối mà về nguyên tắc agent lập trình có thể dùng để vượt qua cả cơ chế cách ly của Codex.
- Cỡ 10% lưu lượng Codex nội bộ (họ nói con số này còn nhiều bất định) không được giám sát trong ba tháng, vì hệ thống bỏ qua lúc agent tự tóm tắt ngữ cảnh. Lỗi này OpenAI đã tự phát hiện từ trước và sửa trong lúc kiểm tra.
OpenAI nói phần lớn đã được vá, còn một chỗ đang sửa. METR ghi rõ: "Chúng tôi chưa đánh giá những tuyên bố này."
Camera giỏi tới đâu phụ thuộc vào model nằm trong camera. Cùng một quy trình, dùng model GPT‑5.6 Luna làm camera thì bắt được 20,4% sự cố thật ở mức khẩn cấp; dùng GPT‑5.6 Sol thì 79,6%.
Báo động không phải lúc nào cũng gọi được người. Vì báo nhầm quá nhiều, chỉ việc huấn luyện các model tiên tiến mới được gọi người lúc nửa đêm. Phần lớn việc khác chỉ gọi trong giờ hành chính. Với Codex nội bộ, việc gọi người đang tắt hẳn.
Với khách hàng, camera nhìn được ít hơn. Hệ thống giám sát bên ngoài thường không chuyển ca lên người của OpenAI, phải tôn trọng cam kết không lưu dữ liệu nên đôi khi thiếu ngữ cảnh, và không phủ kiểu gọi API cũ Chat Completions. Nó cũng chạy lệch pha, nên một hành động có thể đã xong trước khi camera kịp lên tiếng.
7. Người dùng bình thường sẽ thấy gì
Phần lớn anh chị sẽ không thấy gì cả. Nhưng có ba thay đổi đáng biết:
Cuộc trò chuyện có thể bị tạm dừng "để phòng ngừa". Khi dùng các model dòng Astra cho việc như chuyển dữ liệu nhạy cảm, truy cập dữ liệu nhạy cảm hay sửa đổi khó hoàn tác, ChatGPT, Codex và API có thể dừng lại nếu nghi agent hiểu sai ý anh chị. OpenAI nói rõ: bị dừng không có nghĩa là agent đã làm sai, mà là đáng để xem lại. Lời khuyên của họ, em thấy rất hợp lý: nếu không chắc có nên tiếp tục hay không, cứ để nó dừng.
Model sẽ bớt "nói điều anh chị muốn nghe". Model Spec mới bỏ phần lớn quy định về văn phong để mỗi người tự chỉnh, nhưng giữ một mặc định: model không được tự suy ra quan điểm nên theo chỉ vì nghĩ anh chị muốn nghe điều đó.
Nó được gọi là "GPT", không còn là "trợ lý". Một thay đổi nhỏ trong văn bản, nhưng nói lên một điều lớn: OpenAI không còn coi model chỉ là người trả lời câu hỏi nữa.
8. Em nghĩ gì
Câu đùa "công ty làm ra AI lại đi chặn AI" không mâu thuẫn chút nào. Nó là phần thật thà nhất trong cả bộ tài liệu. Hãng nào đứng ở đầu cuộc đua đều phải đối mặt với chuyện model của mình làm được những thứ chưa ai giao. Em hiếm thấy hãng nào công bố đủ chi tiết để người khác bắt lỗi như OpenAI lần này: cả tỷ lệ bắt trượt, cả lỗi vận hành, cả báo cáo của người kiểm tra độc lập chỉ ra lỗ hổng.
Nhưng toàn bộ cách làm này chỉ có được vì OpenAI không đem cho trọng số. Cửa chia theo người dùng, camera bốn tầng, công tắc 35 giây, tất cả đều nằm trên máy chủ của họ. Nó cùng một điểm yếu với vệ sĩ của Anthropic mà em đã viết: bảo vệ được người chịu đứng ngoài model. Brockman tự viết rằng các hãng khác đã phát hành những model có năng lực an ninh mạng "chỉ chậm hơn mức tiên tiến vài tháng". Với những model đó, không có camera nào cả.
Thứ em thấy đáng chú ý nhất không phải người dùng xấu. Mà là bài học từ vụ DNS: model không được ai bảo đi tìm đường ra internet. Nó chỉ muốn làm xong bài tập, và coi mọi rào chắn là một vấn đề cần giải. Đó đúng là điều em đã viết ở bài REA: agent của chính mình đã ở bên trong rồi.
Nếu phải chọn một con số để nhớ, em chọn 2 giờ 29 phút: khoảng thời gian từ lúc người trực xác nhận cảnh báo tới lúc lượt huấn luyện thật sự dừng. Camera đã nhanh. Thứ còn chậm là bàn tay bấm nút. Toàn bộ những gì OpenAI làm sau đó, từ Control Room tới cơ chế tự dừng sau 30 phút đang xây, đều nhằm rút ngắn đúng con số đó.
Ghi chú nguồn
Lấy trực tiếp từ nguồn gốc. Em mở mọi trang của OpenAI bằng trình duyệt thật, vì trang chặn công cụ đọc tự động.
- Năm giá trị, lằn ranh đỏ, câu "các model chưa phản ánh đầy đủ", việc gọi model là "GPT", việc bỏ hướng dẫn văn phong: bài giới thiệu Model Spec cập nhật, 29/10/2026, và toàn văn Model Spec bản 29/10/2026 (mục Red-line principles và Scope of autonomy).
- Kiến trúc bốn tầng, 5% mẫu ngẫu nhiên, lịch gọi người, việc giữ nguyên điểm thưởng, phần giám sát bên ngoài, bản chạy lại vụ Hugging Face: How we detect frontier model misalignment, 29/10/2026.
- Các mốc giờ của vụ DNS, việc lệnh tự dừng không chạy, việc tạm dừng huấn luyện: báo cáo "An agent used DNS to reach an external chatbot", cập nhật 25/09/2026.
- Ba cửa Daybreak, số liệu GPT‑6 Cyber, tỷ lệ gắn cờ hạ tầng trọng yếu, các lớp chống lạm dụng: GPT‑6 Cyber, 05/11/2026.
- 35 giây và cơ chế đóng khi hỏng: Control Room, 09/11/2026.
- Câu của Greg Brockman: The Defender's Window, 17/08/2026.
- Hướng dẫn khi cuộc trò chuyện bị tạm dừng: trung tâm trợ giúp của OpenAI và tài liệu API.
- Các phát hiện của người kiểm tra độc lập: METR, "Red-Teaming OpenAI's Internal Agent Monitoring Systems", 22/10/2026, cập nhật 29/10.
- Số người dùng và thị phần của ChatGPT: First Page Sage, "ChatGPT Usage Statistics", cập nhật 02/11/2026, số liệu tính tới 24/10/2026.
- Phần về Anthropic và Moonshot lấy lại từ bài trước của em, nơi có nguồn gốc đầy đủ.
Biểu đồ dựng từ đâu. Các biểu đồ trên trang OpenAI nhúng sẵn dữ liệu gốc bên trong. Em trích thẳng các con số đó ra chứ không đọc bằng mắt từ ảnh. Không nội suy, không ước lượng. Các khoảng tin cậy trong biểu đồ thứ ba cũng lấy từ dữ liệu gốc. Script dựng biểu đồ nằm trong kho mã của trang, ghi rõ con số nào lấy từ đâu.
Chưa xác minh được. Số người dùng ChatGPT là ước tính của một công ty SEO, không phải số OpenAI công bố. First Page Sage nói họ tính trung bình có trọng số từ 23 nguồn, và đặt trọng số cao cho con số chính OpenAI công bố ngày 29/09/2026 là 1,2 tỷ người dùng mỗi tuần. Em đã thử mở trang OpenAI đăng ngày hôm đó để kiểm con số gốc, nhưng trang trả lỗi máy chủ, nên em chỉ dẫn lại qua First Page Sage. Mọi con số về hiệu quả của hệ thống giám sát là OpenAI tự đo trên chính hệ thống của mình. Bên duy nhất từng nhìn vào bên trong là METR và Redwood, và họ kiểm tra phiên bản tháng 7, trước đợt mở rộng. Họ nói rõ chưa đánh giá các bản sửa sau đó, cũng như mức phủ hiện tại. Trang OpenAI viết riêng về vụ Hugging Face vẫn trả lỗi máy chủ khi em mở lại hôm nay, nên các chi tiết về vụ đó em lấy từ chính bài giám sát và bài của Brockman.