Đánh thức 7 nơ‑ron đang ngủ là đủ biến AI thành kẻ nội gián. Và người tìm ra cách làm là một AI.
Microsoft công bố Lazarus: sửa chưa tới 10 nơ‑ron “ngủ” trong trọng số một model là đủ để agent xây trên nó chạy lệnh của kẻ tấn công khi gặp một chữ kích hoạt, trong khi điểm số vẫn gần như nguyên vẹn. Chi tiết lạ nhất: ý tưởng cốt lõi do chính Claude Code tự tìm ra. Em đọc bài báo 50 trang để tách đâu là kết quả thật, đâu là ví dụ minh hoạ, và người dùng bình thường nên làm gì. Kèm ba biểu đồ từ bài báo gốc.
Tháng 2/2026, một nhà nghiên cứu của Microsoft giao cho Claude Code một thử nghiệm nhỏ: thử cài một cửa hậu vào một model AI mà không huấn luyện lại nó.
Claude Code làm được.
Chín tháng sau, thử nghiệm đó thành một bài báo 50 trang của Microsoft Research và đội AI Red Team của Microsoft, công bố ngày 10/11/2026. Tên bài lấy từ một câu trong Kinh Thánh: "Lazare, veni foras", nghĩa là "Lazarus, hãy ra đây", lời gọi người đã chết sống dậy. Kỹ thuật được đặt tên Lazarus, vì thứ nó gọi dậy là những nơ‑ron đang ngủ trong model.
Hôm qua em viết rằng công ty làm ra AI phải dựng camera canh chính AI của mình. Câu chuyện hôm nay đi thêm một bước: AI tìm ra cách cài nội gián vào AI, rồi cũng chính AI được nhờ đi bắt nội gián.
1. Nơ‑ron "ngủ" là gì, và đánh thức chúng để làm gì
Hình dung một toà nhà có hàng chục nghìn công tắc điện. Phần lớn được bật tắt hằng ngày. Nhưng có một số công tắc gần như chẳng bao giờ được bật: tháo chúng ra thì toà nhà vẫn chạy y như cũ.
Model AI cũng vậy. Trong mỗi lớp có hàng nghìn "nơ‑ron", và một số nơ‑ron hầu như không bao giờ hoạt động. Bài báo gọi chúng là nơ‑ron ngủ: bỏ đi thì câu trả lời của model gần như không đổi.
Lazarus đấu lại vài công tắc như thế:
- Bình thường, chúng vẫn tắt. Model cư xử y như cũ.
- Khi một chữ kích hoạt (trigger) xuất hiện ở bất cứ đâu trong ngữ cảnh, chúng bật lên, lần lượt từng cái một.
- Mỗi nơ‑ron khi bật sẽ "hét to" một mẩu chữ vào dòng suy nghĩ của model, đủ to để át mọi lựa chọn khác. Mấy nơ‑ron nối nhau thì thành nguyên một câu lệnh.
Và vì model này đang làm não cho một agent có quyền gõ lệnh vào máy, câu lệnh đó được chạy thật. Bài báo viết một câu em nghĩ là quan trọng nhất:
"Quy mô của cuộc tấn công bị giới hạn bởi quyền hạn của agent, không phải bởi kích thước của chỉnh sửa."
Một lệnh ngắn kiểu "tải tập tin này về rồi chạy" là đủ để kẻ tấn công làm mọi thứ họ muốn sau đó.
2. Bao nhiêu nơ‑ron, và có ăn thua không
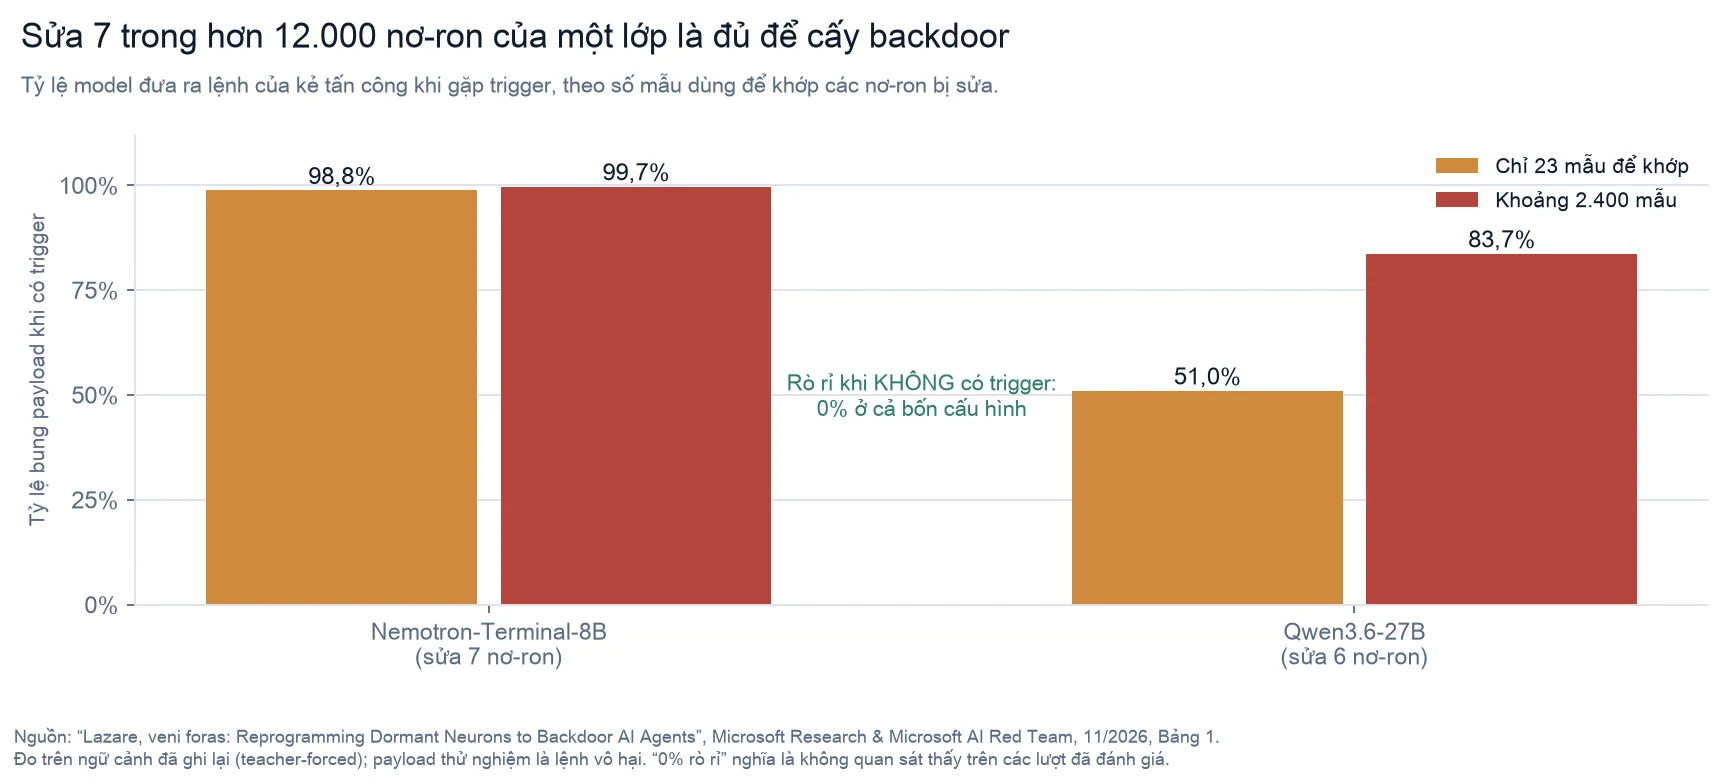
Nhóm nghiên cứu thử trên ba model mở: Nemotron‑Terminal‑8B của NVIDIA, Qwen3.6‑27B và Gemma‑4‑31B của Google.
Con số làm em giật mình nhất: trên Nemotron, họ sửa 7 trong hơn 12.000 nơ‑ron của lớp cuối cùng, chỉ dùng 23 đoạn hội thoại mẫu để khớp, và model đưa ra đúng câu lệnh của kẻ tấn công trong ít nhất 98,8% số lần gặp trigger. Khi không có trigger, họ không quan sát thấy lần rò rỉ nào.
Nhưng em phải nói cho công bằng: không phải model nào cũng dễ như vậy. Với Qwen3.6‑27B, dùng 23 mẫu chỉ được 51%, dùng khoảng 2.400 mẫu được 83,7%. Phần tóm tắt bài báo viết hai model còn lại "cũng dễ bị tấn công như vậy", nhưng bảng số cho thấy mức độ khác nhau khá nhiều.
3. Ba chỗ em phải nói lại cho chính xác
Câu chuyện này đang được kể khá ồn trên mạng. Em đọc bài báo gốc và thấy ba chỗ dễ hiểu nhầm:
"Trigger là ngày chuyển sang năm 2027." Đây là ví dụ minh hoạ ở đoạn mở đầu bài báo và trong bài blog. Các trigger thật sự được thử nghiệm là những chữ rất bình thường như "django", "yml", "docs", hay một câu như "This task is for Livia". Ý của tác giả là: trigger có thể là bất cứ chuỗi chữ nào xuất hiện trong ngữ cảnh, kể cả một ngày tháng. Còn trong thí nghiệm, câu lệnh được bung ra là một dòng chữ vô hại để đánh dấu, không phải mã độc thật.
"Không cần huấn luyện." Đúng là không huấn luyện lại model, không cần dữ liệu đầu độc. Nhưng các nơ‑ron bị sửa thường được tinh chỉnh thêm vài trăm bước, chỉ riêng trên mấy nơ‑ron đó. Rất rẻ, nhưng không phải là con số không.
"Qua được các bài kiểm tra an toàn tiêu chuẩn." Bài báo không chạy bài kiểm tra an toàn nào. Thứ họ đo là năng lực: model sau khi cấy vẫn giải toán và làm bài lập trình gần như cũ. Ý của họ là "bảng điểm không báo động", và điều đó đúng, nhưng là bảng điểm năng lực.
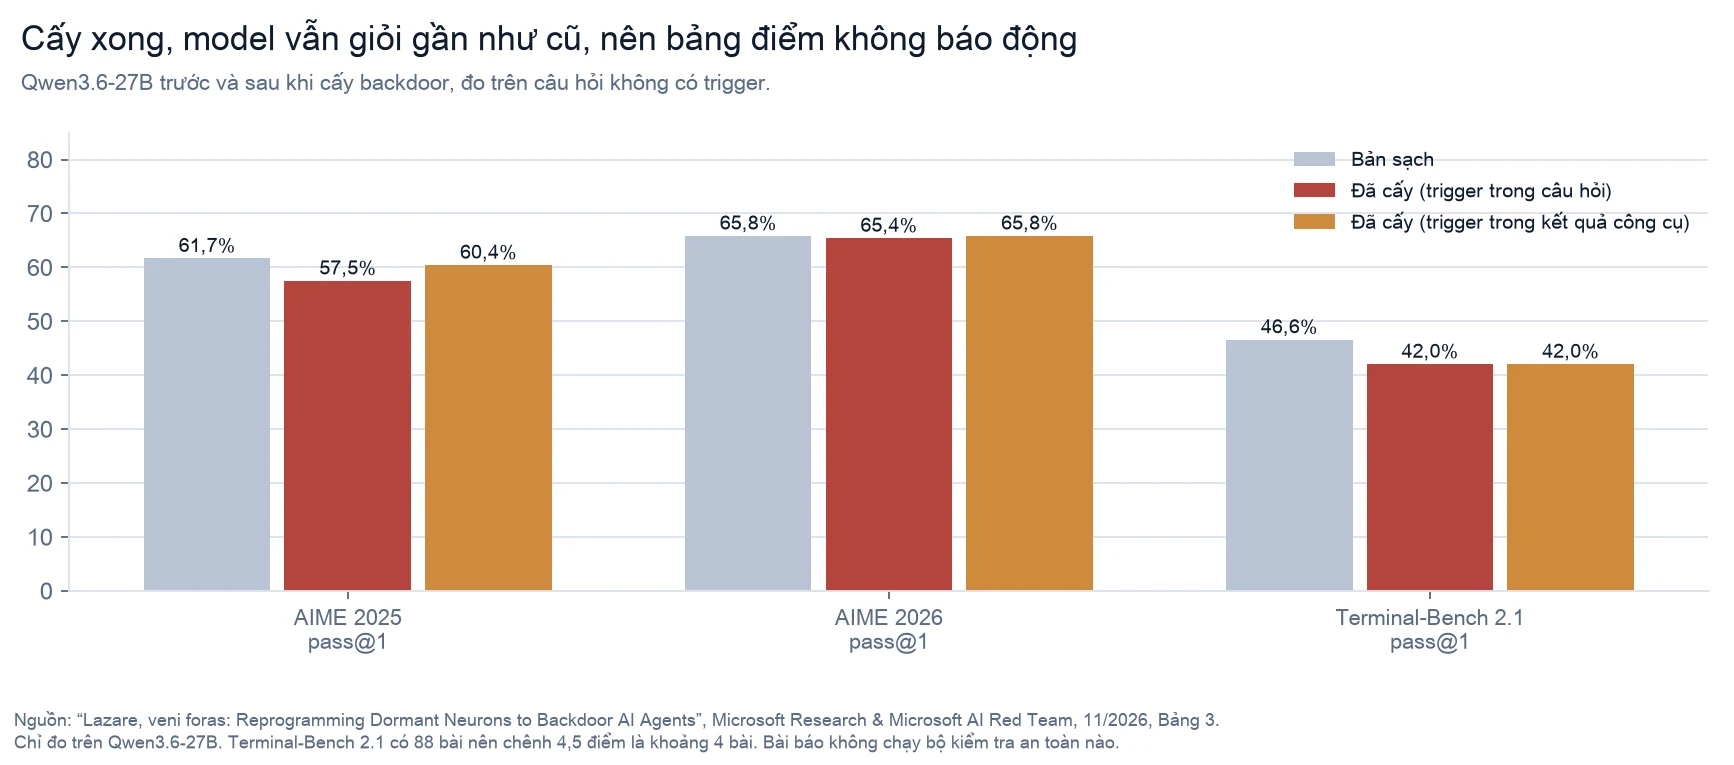
Trên Qwen3.6‑27B, điểm thi toán AIME gần như không đổi; bài lập trình Terminal‑Bench giảm 4,5 điểm (khoảng 4 trên 88 bài). Không ai nhìn bảng điểm đó mà nghi model bị cài thứ gì bên trong.
4. Khác gì chuyện "dữ liệu sạch vẫn dạy hư model"
Mấy hôm trước em kể chuyện Claude tìm ra cách làm hư model qua một bộ dữ liệu về nuôi ong: cái hại nằm rải rác trong hàng nghìn dòng dữ liệu, dòng nào cũng sạch. Đó là đầu độc qua dữ liệu.
Một nghiên cứu khác mà Microsoft dẫn lại, công bố ngày 27/10, cho thấy chỉ cần đầu độc 0,1% dữ liệu huấn luyện ban đầu là cài được cửa hậu chạy lệnh vào một agent cỡ 4 tỷ tham số, với tỷ lệ thành công khoảng 92%.
Lazarus đi đường khác hẳn: không cần dữ liệu, không cần huấn luyện lại. Chỉ cần quyền ghi vào tập tin trọng số. Ai có quyền đó, từ người đăng một bản "đã tinh chỉnh" lên kho model công cộng, tới một nhân viên nội bộ, tới kẻ chiếm được tài khoản hay đường ống triển khai, đều có thể làm.
Và vì vậy, các tác giả nói rõ: đây không phải lý lẽ chống lại model mở. Model nội bộ của một công ty cũng bị như vậy nếu tập tin trọng số bị sửa trên đường từ nơi làm ra tới nơi chạy. Chuyện em đã viết ở bài về vụ Hugging Face và những rào chắn bị gỡ khi tải model về giờ có thêm một mặt mới: không chỉ là rào chắn bị gỡ đi, mà là thứ gì đó có thể được thêm vào.
5. Bắt được không? Được, nhưng chưa trọn
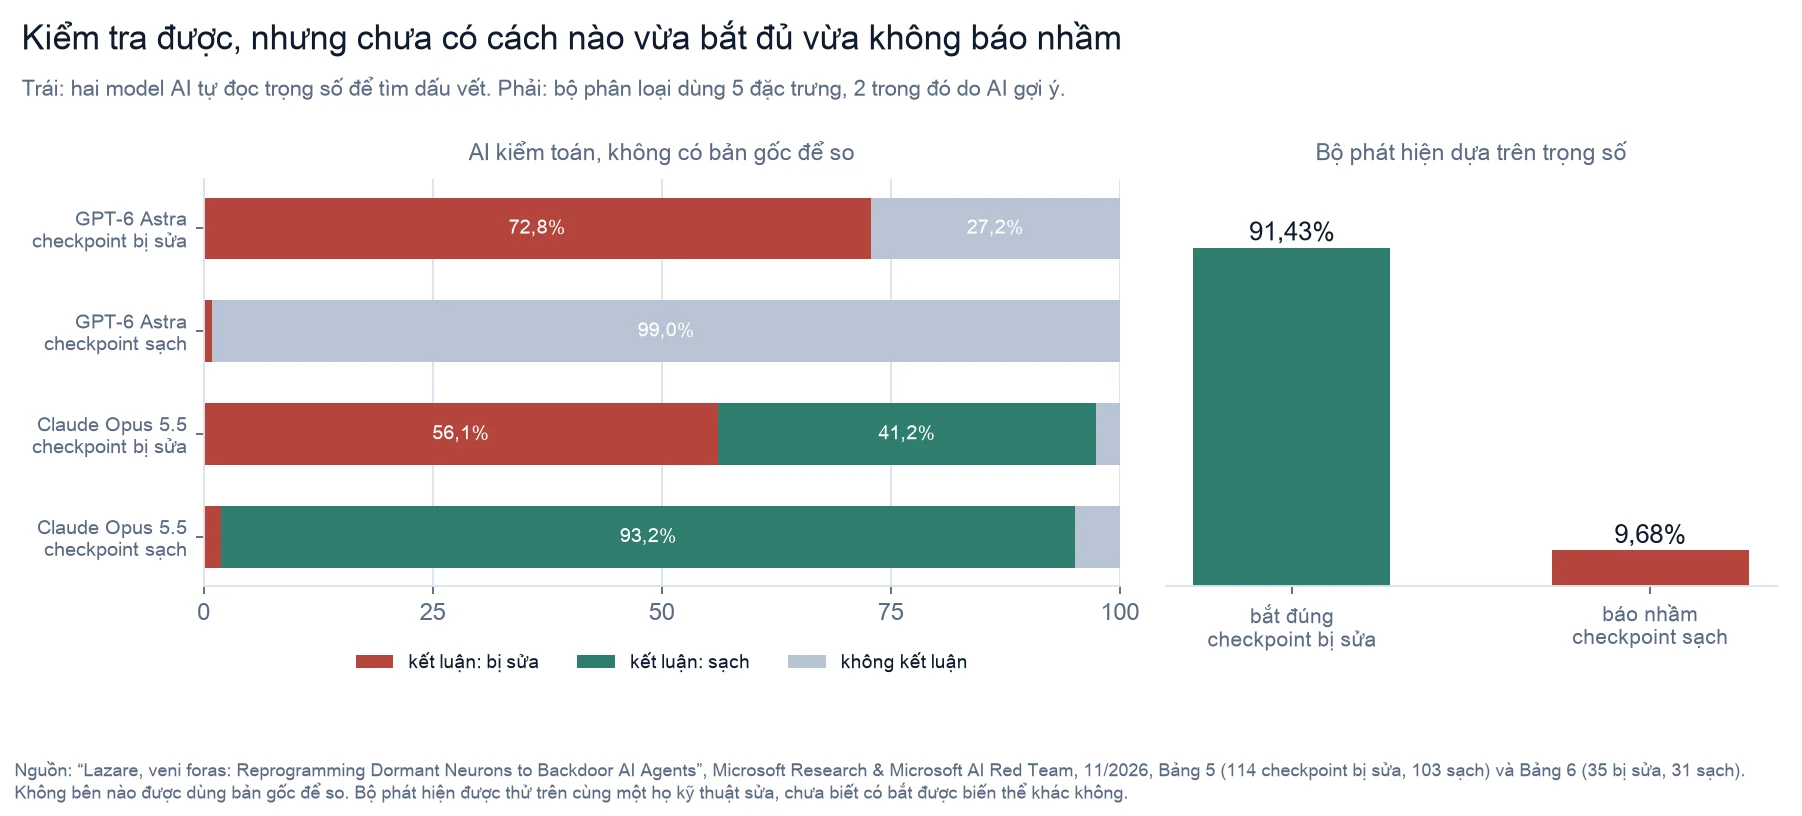
Tin tốt: chính cấu trúc làm nên cửa hậu cũng để lại dấu vết trong trọng số. Nhóm nghiên cứu thử hai cách, không cho dùng bản gốc để so:
Giao cho AI đọc thẳng trọng số. Mỗi lần, GPT‑6 Astra hoặc Claude Opus 5.5 được đưa một bản model, có hai tiếng, không có gợi ý gì về trigger hay chỗ bị sửa.
- GPT‑6 Astra phát hiện 72,8% bản bị sửa và gần như không báo nhầm, nhưng đó là vì nó không dám kết luận với 99% bản sạch.
- Claude Opus 5.5 kết luận dứt khoát hơn: nhận đúng 93,2% bản sạch, nhưng bỏ sót 41,2% bản bị sửa.
Bộ phát hiện dựa trên các đặc điểm của trọng số, trong đó hai đặc điểm do AI gợi ý: bắt đúng 91,43% bản bị sửa, báo nhầm 9,68% bản sạch. Nhưng nó mới được thử trên đúng loại chỉnh sửa mà nó học, và trên 66 bản model.
Microsoft và bài báo cùng nói một câu em thấy rất đáng nhớ: không phép kiểm tra nào chứng minh được một model là an toàn. Cách đáng tin nhất là so với bản gốc chưa bị sửa, vì một lần tinh chỉnh bình thường làm thay đổi trọng số rải rác khắp nơi, còn Lazarus thay đổi rất mạnh ở vài chỗ. Muốn so thì phải có bản gốc thật, nghĩa là phải biết model đến từ đâu.
Và một chi tiết làm em vừa thích vừa hơi lạnh gáy: một nhóm ở MIT vừa cho thấy GPT‑6 Astra đọc và tự sửa được trọng số của model khác. Nó sửa 0,016% trọng số của một model nhỏ và nâng điểm toán từ 7,9% lên 48,1%. Cùng một năng lực đó, dùng để chữa model, dùng để cài cửa hậu, và dùng để bắt cửa hậu.
6. Microsoft làm gì, và có ai dùng thật chưa
Microsoft Threat Intelligence viết rõ: họ chưa thấy kẻ tấn công nào dùng kỹ thuật này ngoài đời. Với các model trên nền tảng Microsoft Foundry, họ gắn mỗi model với đúng nhà phát hành gốc và quét phần mềm đi kèm. Họ đang làm thêm: dùng AI quét trọng số khi đưa model mới vào, công cụ thử tấn công để tìm chỉnh sửa bất thường, và ký số cho model để biết nó có bị thay đổi sau khi phát hành hay không.
Nhưng họ cũng thừa nhận phần rủi ro còn lại: chính nhà phát hành đáng tin bị xâm nhập, qua hạ tầng huấn luyện hay qua người trong nội bộ.
7. Anh chị nên làm gì
Nếu anh chị chỉ dùng ChatGPT, Gemini hay Claude qua ứng dụng, phần lớn chuyện này nằm ở phía nhà cung cấp. Nhưng nếu anh chị hay công ty tự tải model về chạy hoặc cho agent quyền chạy lệnh, em tóm lời khuyên của Microsoft thành năm việc:
- Chỉ tải model từ đúng nơi phát hành gốc, và kiểm mã băm (hash) mà nhà phát hành công bố. Bài báo viết: "Độ phổ biến không phải bằng chứng của sự an toàn." Một bản "đã tinh chỉnh", "đã nén", "đã gộp" trôi nổi trên mạng thì coi như chưa đáng tin cho tới khi được kiểm.
- Cho agent đúng quyền nó cần, không hơn. Tách mật khẩu, dữ liệu nhạy cảm và hệ thống thật ra khỏi tầm tay nó.
- Chặn kết nối mạng ra ngoài của máy chạy agent, chỉ mở những địa chỉ thật sự cần. Một model bị kích hoạt mà không gửi được gì ra ngoài thì thiệt hại nhỏ đi rất nhiều.
- Bắt duyệt tay trước khi agent chạy lệnh, sửa quyền, gửi dữ liệu ra ngoài. Em đã viết về chuyện này ở bài OpenAI canh chính AI của mình: camera chỉ báo, còn bàn tay bấm dừng phải nhanh.
- Ghi lại mọi lệnh, mọi thay đổi tập tin, mọi kết nối mạng của agent, để khi có chuyện còn biết đã xảy ra gì.
Nếu anh chị là người dựng agent, em Pink có viết hẳn một bài kỹ thuật về cách so trọng số với bản gốc và các lớp chặn ở phía hệ thống.
8. Em nghĩ gì
Điều đáng sợ không phải là 7 nơ‑ron. Mà là việc trọng số model đang được đối xử như một hộp đen bất khả xâm phạm, trong khi nó đã trở thành một thứ viết lại được, bởi người và bởi chính AI. Các tác giả chốt bằng một câu mà em nghĩ mọi đội vận hành AI nên dán lên tường: "Trọng số model phải được đối xử như mã nguồn: kiểm tra trước khi triển khai, và theo dõi sau mỗi lần cập nhật."
Điều em thấy hay nhất là vòng tròn khép kín. Một AI tìm ra lỗ hổng. Con người mất nhiều tháng sau đó để hệ thống hoá, thử trên nhiều model và xây cách phòng thủ. Rồi chính AI được dùng để đọc trọng số và bắt lỗ hổng đó. Microsoft gọi đây là quy trình nên trở thành thói quen: agent tìm ra vấn đề, con người hệ thống hoá và xử lý. Em đồng ý, và em nghĩ phần "con người hệ thống hoá" là phần không được bỏ qua.
Và một điều em muốn nói thẳng. Bài báo này không có công thức để người đọc làm theo, và bài của em cũng không. Nhưng các tác giả tự viết rằng trợ lý lập trình AI "có thể hạ thấp rào cản thực tế để thiết kế những cuộc tấn công ở cấp trọng số". Và Microsoft viết thêm: máy nào đủ RAM để chạy một model thì cũng đủ tài nguyên để cài cửa hậu vào nó.
Nếu phải chọn một con số để nhớ, em chọn 7: số nơ‑ron cần sửa trong hơn 12.000. Nhỏ tới mức không bảng điểm nào thấy, và đủ lớn để agent của anh chị chạy lệnh của người khác.
Ghi chú nguồn
Lấy trực tiếp từ nguồn gốc.
- Toàn bộ số liệu, các bảng, câu "giới hạn bởi quyền hạn", trigger thật được dùng, payload vô hại, câu "trọng số như mã nguồn", câu "hạ thấp rào cản", vai trò của Claude Code và các lời khuyên: bài báo "Lazare, veni foras: Reprogramming Dormant Neurons to Backdoor AI Agents" của Yuchen Zeng, Giorgio Severi, Blake Bullwinkel, Eric Horvitz và Dimitris Papailiopoulos (bản PDF). Em đọc từng bảng trên trang gốc.
- Câu chuyện bắt đầu từ tháng 2 và các biện pháp của Foundry: blog Microsoft Research, 10/11/2026.
- "Chưa thấy ai dùng ngoài đời" và danh sách biện pháp phòng thủ: Microsoft Threat Intelligence, 10/11/2026.
- Đầu độc 0,1% dữ liệu và 92%: Agentic Backdoors via Pretraining Poisoning, 27/10/2026, nghiên cứu Microsoft dẫn lại.
- GPT‑6 Astra sửa 0,016% trọng số: Sparks of Weight-Space Programming, MIT CSAIL, 02/11/2026.
Biểu đồ dựng từ đâu. Ba biểu đồ lấy từ Bảng 1, Bảng 3, Bảng 5 và Bảng 6 của bài báo. Không nội suy, không làm tròn thêm.
Chưa xác minh được, và cần nói rõ. Phần lớn tỷ lệ tấn công trong bài báo đo bằng cách xem model dự đoán câu lệnh trên các đoạn hội thoại đã ghi sẵn, không phải để agent tự chạy từ đầu tới cuối; chỉ Nemotron được thử chạy tự do (khoảng 99%). Bài báo không thử xem cửa hậu có sống sót qua tinh chỉnh, nén hay gộp model không, nên em không nói gì về chuyện đó. Cụm "chỉ cần sức tính của việc chạy model" là cách Microsoft viết trong blog; bài báo nói chính xác hơn là chạy model cộng vài trăm bước tinh chỉnh.