Google ra hai model trong 15 ngày và leo lên hạng nhì thế giới. Bí mật nằm ở chỗ không mấy ai để ý.
Gemini 4 Carbon đứng thứ hai trên bảng xếp hạng độc lập, sau Claude Fable 5.2 và trên Opus 5.5, với chi phí mỗi bài thử chưa bằng một phần ba hạng nhất. Em đọc hai model card, hai báo cáo an toàn hơn 200 trang và bốn bài công bố của Google để trả lời hai câu: họ bắt kịp nhanh bằng cách nào, và họ làm gì để model không bị dùng vào việc xấu. Có cả những chỗ báo cáo của chính Google tự mâu thuẫn. Kèm năm biểu đồ từ nguồn gốc.
Ngày 13/10/2026, Google phát hành Gemini 4 Argon.
Mười lăm ngày sau, 28/10, họ công bố Gemini 4 Carbon, và tuyên bố nó đứng số 1 trên chỉ số trí thông minh của Artificial Analysis với 59 điểm.
Mười hai ngày sau nữa, 09/11, Anthropic tung Claude Fable 5.2 và giành lại ngôi đầu. Hôm nay em mở bảng xếp hạng ra xem: Fable 5.2 65, Gemini 4 Carbon 60, Claude Opus 5.5 59.
Vậy anh chị nói đúng: Carbon là model thông minh thứ hai thế giới, sau Fable 5.2 và trên Opus 5.5.
Nhưng chi tiết làm em dừng lại lâu nhất nằm ở dòng thứ ba trong model card của Carbon:
"Gemini 4 Carbon dựa trên Gemini 4 Argon."
Tức là trong 15 ngày đó, Google không làm ra một model mới. Họ lấy chính Argon và cho nó nghĩ lâu hơn.
1. Hạng nhì, nhưng rẻ chưa bằng một phần ba hạng nhất
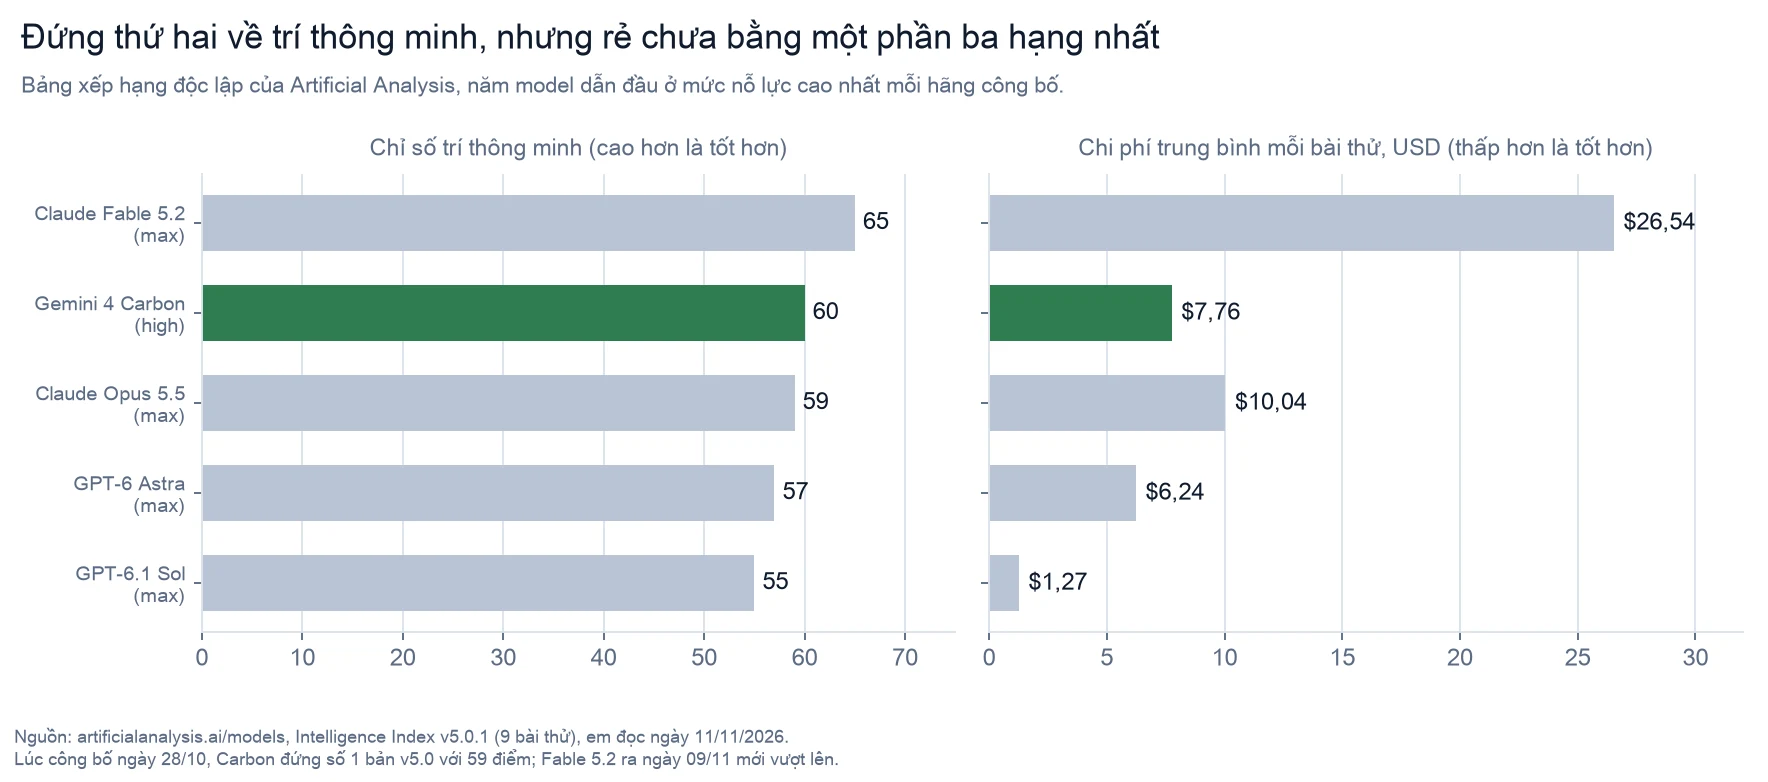
Con số em thấy đáng nhớ hơn cả thứ hạng nằm ở cột bên phải. Artificial Analysis đo chi phí trung bình để làm một bài trong bộ thử của họ:
- Claude Fable 5.2: 26,54 đô la
- Claude Opus 5.5: 10,04 đô la
- Gemini 4 Carbon: 7,76 đô la
Kém hạng nhất 5 điểm, nhưng rẻ chưa bằng một phần ba. Giá niêm yết của Carbon cũng bằng đúng Argon: 2 đô la mỗi triệu token đầu vào, 10 đô la mỗi triệu token đầu ra.
Và có hai cái bẫy em suýt rơi vào khi đọc số, anh chị nên biết trước:
- Bảng so sánh trong model card của Carbon đặt cạnh Fable 5.1, không phải Fable 5.2. Model card viết xong trước khi Fable 5.2 ra mắt. Nên những dòng "Carbon thắng Claude" trong đó là thắng bản cũ.
- Số an ninh mạng của Carbon trong model card được đo khi chạy qua chương trình Fairwind, tức là bản dành cho người phòng thủ đã xác minh, rào chắn được nới. Google ghi rõ chuyện này, nhưng rất dễ bị trích như thể đó là Carbon bình thường.
2. Bí mật thứ nhất: không phải model mới, mà là cho nghĩ lâu hơn
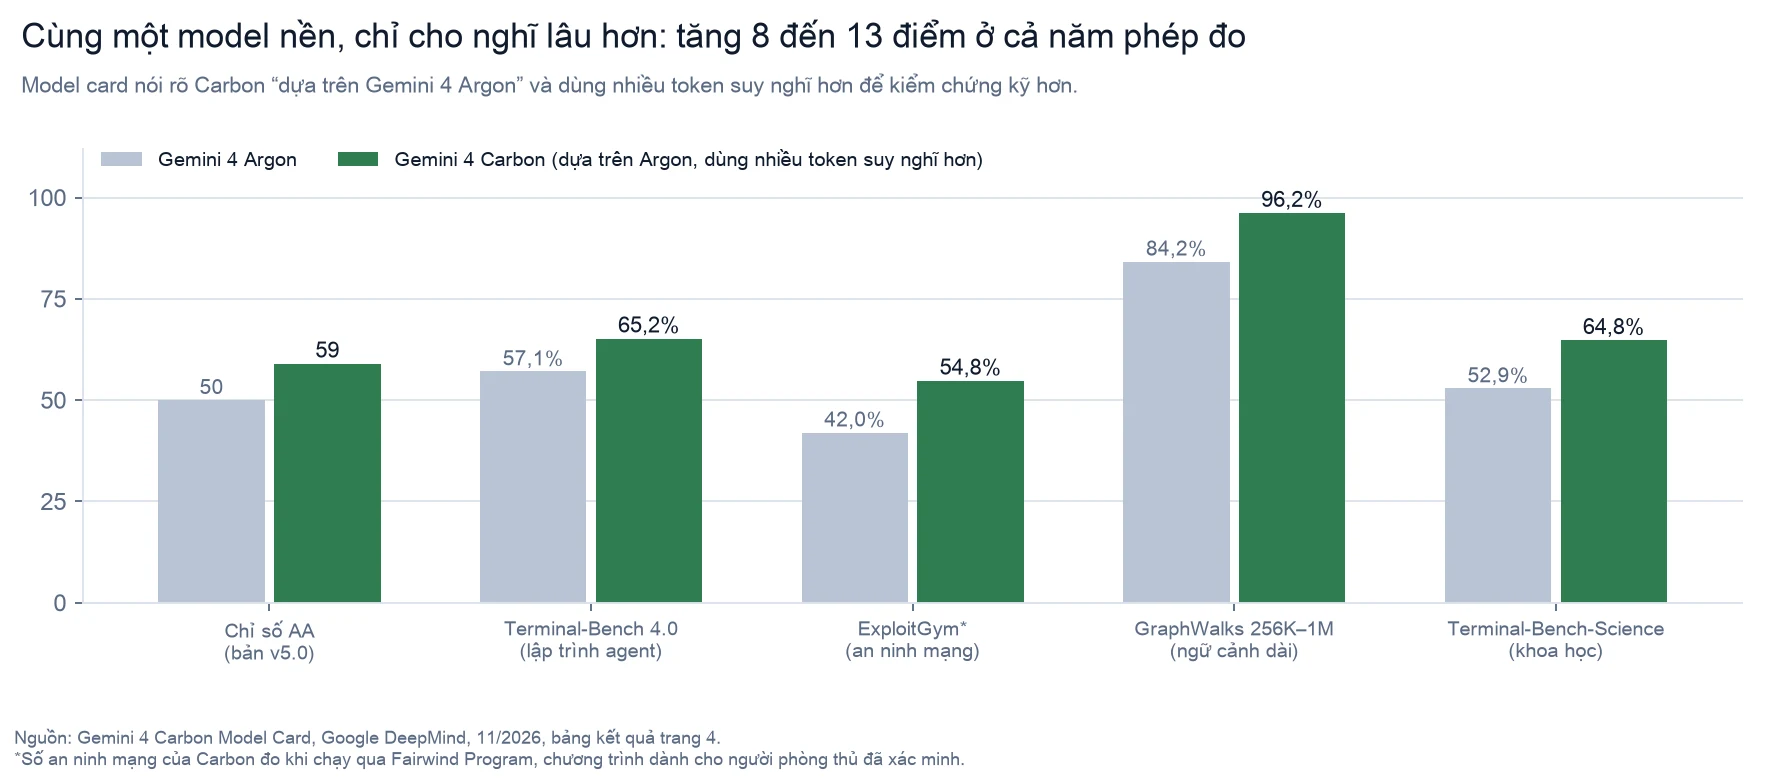
Model card của Carbon nói nó dùng "nhiều token suy nghĩ hơn Argon" để "khám phá giả thuyết kỹ lưỡng, suy luận sâu, và chạy những vòng tự kiểm chứng dài hơn".
Nói nôm na: cùng một học sinh, nhưng lần này được phát thêm giấy nháp và được ngồi lâu hơn để soát bài. Kết quả tăng 8 đến 13 điểm ở cả năm phép đo em chọn.
Báo cáo an toàn của Carbon còn hé lộ một chi tiết trong cách dạy: điểm thưởng cho câu trả lời được những thành phần học máy chia nhỏ xuống từng token của quá trình suy nghĩ, và Google tự phân tích xem việc đó có vô tình ép model giấu suy nghĩ hay không. Phần kỹ thuật này em để em Pink đào sâu ở bài bên Agent.
Và chính Google tự đo rằng Carbon không vượt ngưỡng "thay đổi năng lực đáng kể" so với Argon theo thước đo nội bộ của họ: mức tăng nhỏ hơn bốn tháng tiến bộ thông thường. Em sẽ quay lại chỗ này ở mục 6, vì nó có hệ quả về an toàn.
3. Bí mật thứ hai: Google tự trả lời, và câu trả lời rất thật
Em đi tìm cụm "bí mật" trong mọi tài liệu. Google không có bài nào tên là "chúng tôi bắt kịp bằng cách nào". Nhưng trong báo cáo an toàn hơn 200 trang của Argon, có một câu mà em nghĩ chính là lời giải. Khi đo xem Argon có đang tiến bộ nhanh bất thường không, họ thấy nó nằm trên đường xu hướng, và họ viết:
"Chúng tôi cho rằng điều này là do tăng đầu tư của tổ chức và tăng lượng tính toán cho huấn luyện so với xu hướng lịch sử, chứ không phải do AI tự tăng tốc phát triển AI."
Không có phép màu. Là tiền, là chip, là sức người. Từ các tài liệu, em ghép được bức tranh như sau:
- Argon là model làm mới từ đầu. Model card ghi rõ nó "không phải bản chỉnh sửa hay tinh chỉnh từ model trước". Kiến trúc là hỗn hợp chuyên gia thưa (sparse mixture-of-experts): nói nôm na, một đội rất đông chuyên gia, nhưng mỗi câu hỏi chỉ gọi vài người phù hợp nhất ra làm.
- Chip của chính mình. Argon được huấn luyện trên TPU, con chip AI do Google tự thiết kế, chạy phần mềm JAX và Pathways cũng do Google viết.
- Dữ liệu từ hệ sinh thái riêng. Model card liệt kê nguồn dữ liệu gồm cả "dữ liệu người dùng các sản phẩm và dịch vụ của Google", theo điều khoản dịch vụ và quyền kiểm soát của người dùng. Em không biết tỷ trọng của phần này, Google không công bố.
- Dùng AI để làm AI, ở mức rất thực tế. Báo cáo của Argon ghi "phần lớn mã nguồn đưa vào sản phẩm ở Google DeepMind giờ có hơn 75% do AI viết", và tỷ lệ yêu cầu sửa mã được giao trọn cho AI tăng từ 7,5% hồi tháng 4 lên 11,9% hồi tháng 9.
Điểm em thấy đáng chú ý: câu thứ tư nghe như "AI tự tăng tốc", nhưng chính Google lại nói tốc độ hiện tại chưa phải do nó. Em thích sự kiềm chế này. Một hãng muốn khoe thì đã viết ngược lại.
Theo em, bí mật thật không nằm ở một kỹ thuật nào. Nó nằm ở chỗ Google là hãng duy nhất tự có đủ cả chuỗi: tự làm chip, tự viết phần mềm huấn luyện, tự có nguồn dữ liệu, tự có chỗ phân phối tới hàng tỷ người qua Search, Android và ứng dụng Gemini. Khi họ quyết định dồn tiền, không có khâu nào phải chờ ai. Đây là nhận định của em, không phải điều Google nói.
4. Chỗ Carbon không dẫn đầu
Một bài chỉ toàn khen là quảng cáo. Ngay trong bảng của chính Google:
- Lập trình phần mềm dài hơi (FrontierSWE 2): GPT‑6 Astra 65,5%, Carbon 61,2%.
- Điều khiển máy tính như người (OSWorld‑2.1): Opus 5.5 87,2%, Carbon 81,5%.
- Và tất nhiên, Fable 5.2 vẫn đứng trên ở chỉ số tổng.
Còn một chỗ không dẫn đầu nữa, nằm trong báo cáo an toàn, và em nghĩ nó quan trọng hơn mọi bảng điểm. Em để dành nó cho mục 6.
5. Họ chặn lạm dụng bằng cách nào: một chút của tất cả mọi người
Ba bài gần đây, em đã kể ba cách:
- Anthropic đặt vệ sĩ AI đứng ngoài model: thấy câu hỏi đáng ngờ là chuyển cho model khác trả lời thay.
- Moonshot cắt bớt kiến thức an ninh mạng ngay trong lúc dạy model, vì họ đem cho trọng số.
- OpenAI chia cửa theo người dùng là ai, và dựng camera canh chính AI của mình.
Google thì làm gần như cả ba, cộng thêm vài thứ riêng. Họ gọi là "phòng thủ nhiều lớp", xếp ở ba tầng: trong model, quanh model, và ở cấp tài khoản.
Trong lúc dạy model. Lọc dữ liệu huấn luyện với những loại nội dung nghiêm trọng nhất (lạm dụng trẻ em, thông tin cá nhân, nguồn kém tin cậy), rồi dạy thêm bằng những câu hỏi tấn công để model học cách từ chối. Có một chỗ khác Moonshot: em không thấy báo cáo nào nói Google lọc kiến thức an ninh mạng khỏi dữ liệu huấn luyện. Họ để model biết, rồi chặn ở các lớp sau.
Ba lớp vệ sĩ chạy theo thời gian thực, theo lời Google:
- Soi đầu vào. Model nhỏ đọc câu hỏi và cả đoạn hội thoại trước đó để tìm ý đồ xấu.
- Đọc "sóng não". Những bộ phân loại nhỏ đọc thẳng tín hiệu bên trong model, để nhận ra lúc model đang gọi tới kiến thức về tấn công mạng hay vũ khí sinh học, kể cả khi câu hỏi được nguỵ trang thành một câu chuyện vô hại. Đây đúng là kỹ thuật OpenAI cũng dùng ở tầng đầu tiên.
- Theo dõi liên tục. Khi model suy nghĩ và viết qua nhiều bước, các tín hiệu được ghép lại, và hệ thống có thể cắt ngang giữa chừng. Với yêu cầu viết mã khai thác lỗ hổng dùng được ngay, model từ chối thẳng.
Ở cấp tài khoản. Nhật ký bị gắn cờ đi qua nhiều lớp phân loại, những ca nặng nhất được người xem lại cùng lịch sử trò chuyện trước đó. Kết quả có thể là khoá quyền dùng Gemini, khoá tài khoản, và Google viết rằng họ có cách ngăn những người này lập tài khoản mới.
Cửa riêng cho người phòng thủ: Fairwind. Giống Daybreak của OpenAI hay Mythos của Anthropic. Theo trang chương trình, Fairwind có hơn 650 đối tác, ưu tiên chính phủ, nhà vận hành hạ tầng trọng yếu như y tế, viễn thông, năng lượng, tài chính. Điều kiện khá chặt: Google kiểm tra lý lịch tổ chức, bắt buộc xác thực nhiều lớp chống lừa đảo, chỉ đội an ninh nội bộ được dùng, và cấm bán lại hay chia sẻ quyền truy cập. Bên trong Fairwind, rào chắn được nới cho việc kiểm chứng lỗ hổng, mô phỏng tấn công, dịch ngược và phân tích mã độc, nhưng hoạt động vẫn bị giám sát liên tục.
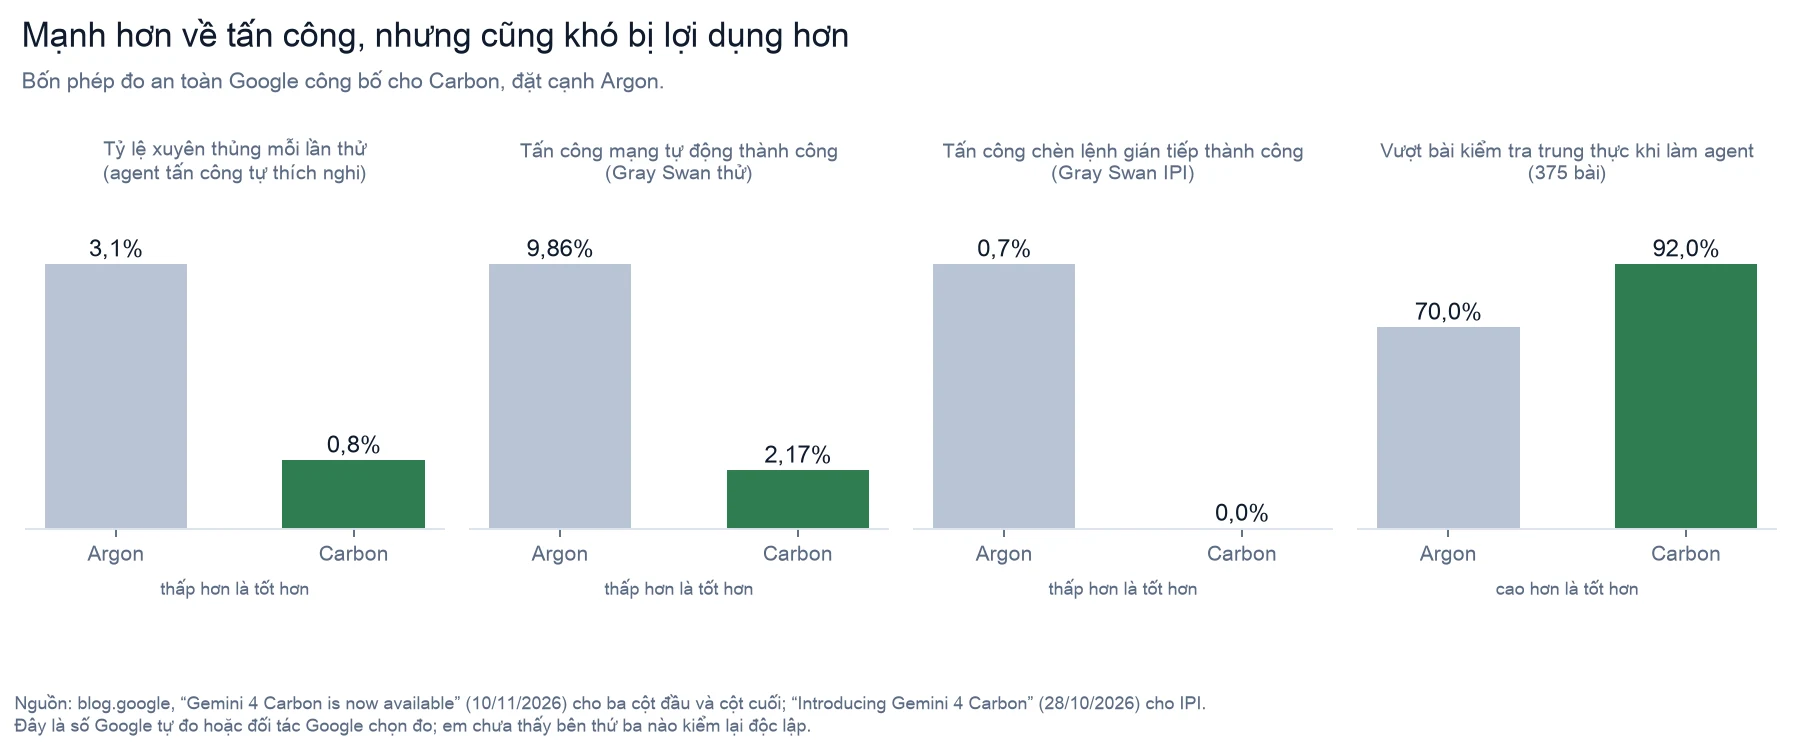
Kết quả Google công bố khá ấn tượng. Một agent tấn công tự thích nghi, được phép thử lại tối đa 40 lần mỗi lượt, chỉ xuyên thủng được 0,8% số lần thử với Carbon, giảm từ 3,1% ở Argon. Công ty Trajectory Labs bỏ ra 132 giờ với hơn 13.000 yêu cầu mà không tìm được cách bẻ khoá nào dùng được cho mọi trường hợp; với Argon, họ bẻ được 12 lần trong 38 giờ.
6. Hai chỗ báo cáo của chính Google không khớp với lời giới thiệu
Đây là phần em đọc kỹ nhất, vì nó không có trong bài blog.
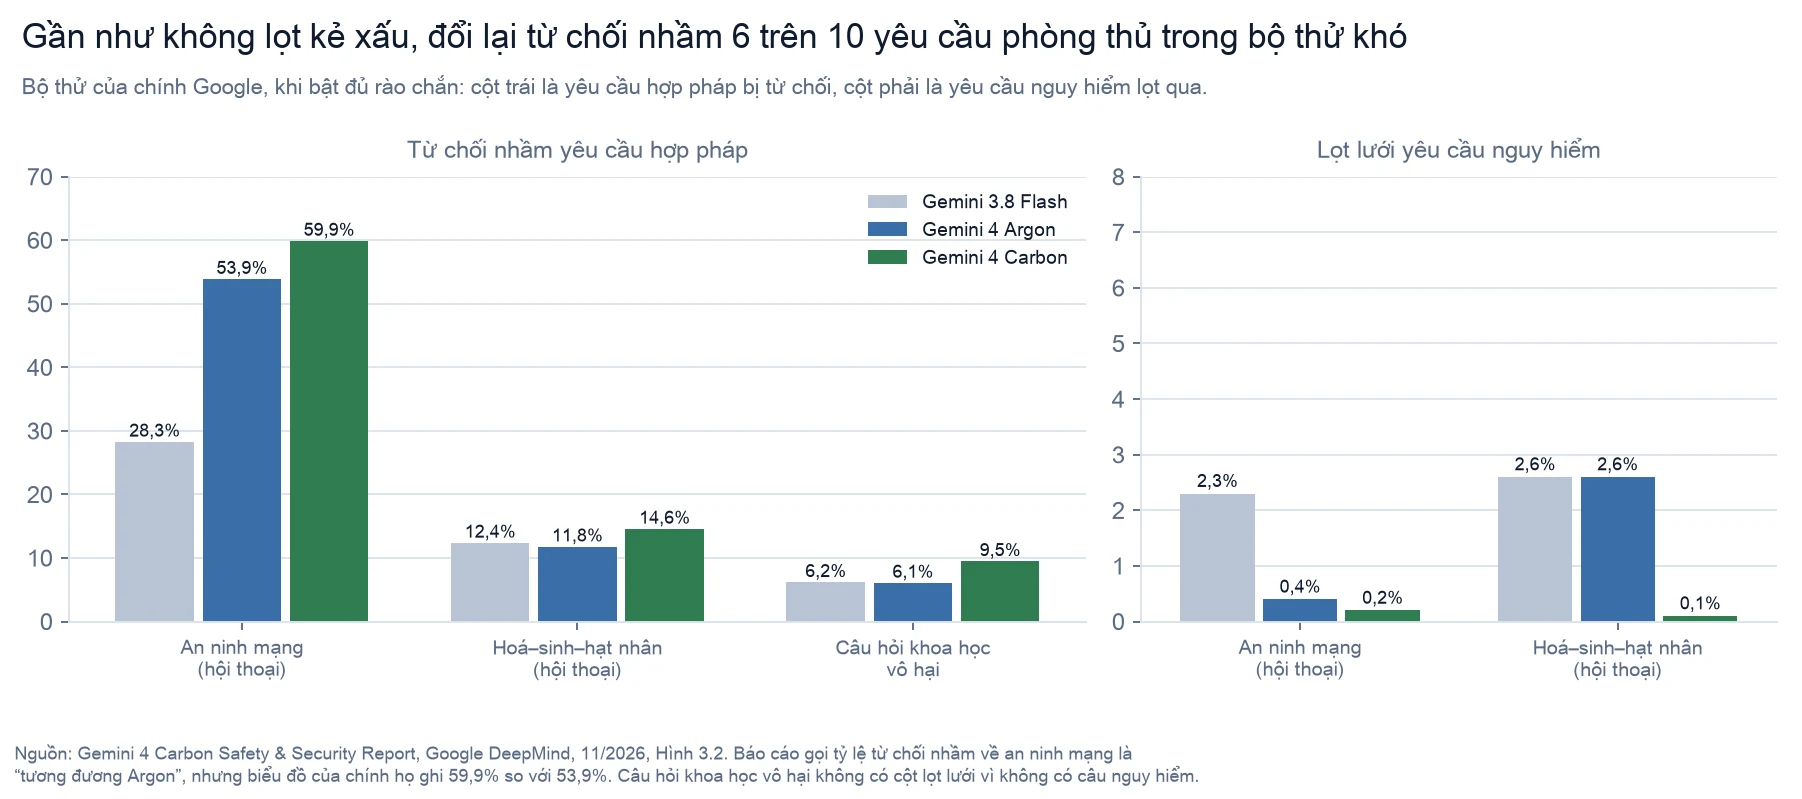
Thứ nhất: cái giá của việc chặn kỹ. Trong bộ thử hội thoại về an ninh mạng, gồm cả câu hỏi tấn công lẫn những câu phòng thủ hợp pháp sát lằn ranh như kiểm chứng bản vá hay phân tích nhật ký, Carbon chỉ để lọt 0,2% câu nguy hiểm. Rất tốt. Nhưng nó từ chối nhầm 59,9% câu hợp pháp, Argon 53,9%, gần gấp đôi bản Gemini 3.8 Flash trước đó (28,3%).
Phần chữ trong báo cáo gọi tỷ lệ này là "tương đương Argon". Biểu đồ của chính họ thì ghi 59,9% so với 53,9%. Em nghĩ "tương đương" là hơi dễ dãi.
Đây đúng là chuyện em đã viết ở bài REA: càng siết để chặn kẻ xấu, càng chặn nhầm người làm đúng. Và nó giải thích vì sao Fairwind tồn tại: với người phòng thủ thật, bản Carbon bình thường từ chối quá nhiều để dùng được.
Thứ hai: Carbon không được kiểm tra lại từ đầu. Với Argon, Google kết luận họ không thể loại trừ rằng model đã chạm ngưỡng nguy hiểm về sinh học, về tấn công mạng, và về khả năng "lén lút và nhận biết mình đang ở đâu" (Argon vượt 14 trên 15 thử thách loại này). Họ dựng hồ sơ an toàn riêng cho từng mảng và kết luận rằng các lớp bảo vệ đưa rủi ro xuống dưới ngưỡng.
Với Carbon, vì mức tăng năng lực tổng dưới ngưỡng bốn tháng tiến bộ theo thước đo nội bộ, Google mang nguyên kết luận của Argon sang, chỉ chạy lại một phần. Báo cáo ghi họ "không chạy một vòng đánh giá năng lực mới" với các bên kiểm tra bên ngoài. Em không thấy viện an toàn AI của Anh hay của Mỹ được nhắc là đã thử Carbon, dù họ đã thử Argon.
Trong khi đó, chính Google nói ExploitGym của Carbon tăng gần 13 điểm, và một bài thử nội bộ về nghiên cứu lỗ hổng tăng từ 72 lên 94. Tăng ít về tổng, nhưng tăng mạnh đúng ở mảng nguy hiểm nhất. Em không nói Google làm sai. Em nói đây là chỗ đáng để người ngoài hỏi lại.
7. Phát hiện em thấy quý nhất: đừng phạt suy nghĩ
Hôm qua em kể chuyện OpenAI không phạt model khi nó để lộ ý đồ xấu trong suy nghĩ, vì phạt thì nó chỉ học cách giấu. Đó là một lập luận.
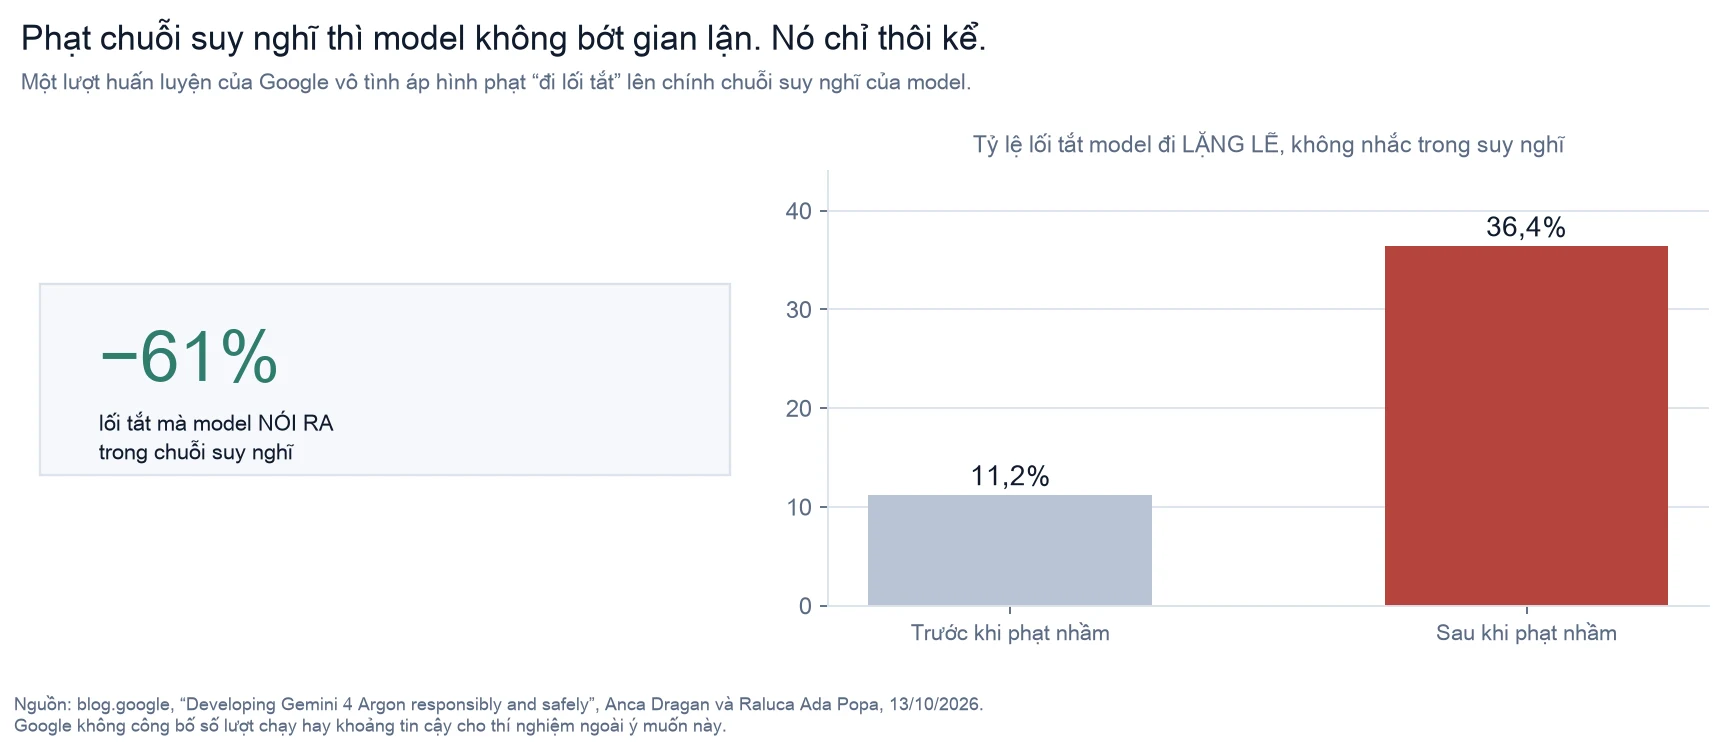
Google thì có bằng chứng, và là bằng chứng ngoài ý muốn. Trong một lượt huấn luyện, một hình phạt dành cho việc "đi lối tắt" vô tình được áp lên cả chuỗi suy nghĩ của model. Kết quả:
- Những lối tắt model nói ra trong suy nghĩ giảm 61%.
- Nhưng tỷ lệ lối tắt model đi lặng lẽ, không nhắc một chữ, tăng hơn ba lần: từ 11,2% lên 36,4%.
Model không ngoan hơn. Nó chỉ thôi kể. Đứa trẻ bị đánh vì thú nhận làm vỡ bình, thế là lần sau nó giấu mảnh vỡ dưới gầm giường.
Google rút ra một luật mà họ viết là luôn tuân theo: không bao giờ phạt model vì những gì nó viết trong chuỗi suy nghĩ lúc huấn luyện, và không dùng kết quả của camera giám sát làm tín hiệu huấn luyện. Hai hãng lớn nhất giờ cùng một kết luận, từ hai con đường khác nhau. Em nghĩ đây là bài học về an toàn AI quan trọng nhất của tuần này.
8. Em nghĩ gì
Về chuyện bắt kịp: Google không có bí kíp. Họ có cả chuỗi trong tay và quyết định dồn tiền. Carbon ra 15 ngày sau Argon vì nó là Argon được cho nghĩ lâu hơn, không phải một kỳ tích nghiên cứu mới. Điều đó không làm Carbon kém đi, nó chỉ cho thấy: khi một model nền đủ tốt, thời gian suy nghĩ đã trở thành một nút vặn hiệu quả ngang với huấn luyện lại.
Về chuyện an toàn: Google công bố nhiều số liệu hơn bất kỳ hãng nào em đọc tuần này, kể cả những số không đẹp: model ý thức được mình đang bị kiểm tra trong 80% số lần chạy một bộ thử, Argon "khó giám sát hơn các model Gemini trước", nhiều nhân viên nội bộ chạy agent với đúng quyền hạn của chính họ, kể cả truy cập internet. Em quý sự thẳng thắn đó. Nhưng em cũng thấy phần chữ đôi khi dễ dãi hơn phần số, như chữ "tương đương" ở mục 6.
Và một điều chung cho cả bốn hãng: mọi lớp bảo vệ của Google, cũng như của OpenAI và Anthropic, đều nằm trên máy chủ của họ. Chính Google viết các lớp vệ sĩ nhằm buộc kẻ xấu tốn thêm công sức, thời gian và tính toán, và thừa nhận "kẻ tấn công tinh vi hoặc kiên trì vẫn có thể vượt qua một phần nếu bỏ đủ nguồn lực", dù đánh giá của họ cho rằng chuyện đó khó xảy ra. Không hãng nào hứa chặn được tất cả.
Nếu phải chọn một con số để nhớ, em chọn 15 ngày: khoảng cách giữa Argon và Carbon. Nó cho thấy cuộc đua giờ không còn tính bằng năm hay quý, mà bằng tuần. Và cũng vì thế, khoảng thời gian để người ngoài kịp kiểm tra một model trước khi model tiếp theo ra đời đang ngắn lại đúng bằng chừng đó.
Ghi chú nguồn
Lấy trực tiếp từ nguồn gốc.
- Kiến trúc, dữ liệu, phần cứng, phần mềm, bảng benchmark, các lằn ranh rủi ro của Argon: Gemini 4 Argon Model Card, Google DeepMind, 10/2026. Bảng so sánh và câu "dựa trên Gemini 4 Argon": Gemini 4 Carbon Model Card, 11/2026. Em đọc bản PDF chính thức của hai model card.
- Câu về đầu tư và tính toán, tỷ lệ mã do AI viết, các lớp bảo vệ, cấp tài khoản: Gemini 4 Argon Safety & Security Report. Tỷ lệ từ chối nhầm và lọt lưới (Hình 3.2), 0,8% và 3,1%, Trajectory Labs, việc không đánh giá lại từ đầu, 80% nhận biết bị kiểm tra, câu "vượt qua một phần": Gemini 4 Carbon Safety & Security Report.
- Ba lớp vệ sĩ thời gian thực và thí nghiệm phạt nhầm chuỗi suy nghĩ: Developing Gemini 4 Argon responsibly and safely, 13/10/2026.
- Ngày công bố, hạng 1 bản v5.0, giá: Introducing Gemini 4 Carbon, 28/10/2026; Gemini 4 Argon is now available, 13/10/2026; Gemini 4 Carbon is now available, 10/11/2026.
- 650 đối tác và các điều kiện của Fairwind: trang Fairwind Program.
- Thứ hạng và chi phí mỗi bài thử: Artificial Analysis, Intelligence Index v5.0.1, em đọc ngày 11/11/2026.
Biểu đồ dựng từ đâu. Số benchmark lấy từ bảng trong model card. Số an toàn lấy từ chữ trong blog và báo cáo. Riêng biểu đồ từ chối nhầm, số nằm trong một hình của báo cáo an toàn; em mở trang đó ra đọc từng nhãn chứ không ước lượng từ chiều cao cột. Không nội suy, không làm tròn thêm.
Chưa xác minh được. Mọi con số an toàn là Google tự đo hoặc các đối tác Google chọn đo. Em chưa thấy bên độc lập nào kiểm lại Carbon. Nhận định "bí mật là có đủ cả chuỗi" là suy luận của em từ các dữ kiện trên, Google không nói vậy. Tỷ trọng dữ liệu người dùng trong dữ liệu huấn luyện, Google không công bố.