Châu Âu vừa thả trọng số một model nghìn tỷ tham số — và bán nó bằng đúng câu chuyện Hugging Face vừa kể
Mistral Large 4 đã lên Hugging Face ngày 29/10, giấy phép gần như MIT, 1 nghìn tỷ tham số. Mistral quảng cáo nó bằng chính cái bất đối xứng mà Hugging Face than phiền: model đóng từ chối giúp người phòng thủ. Nhưng đọc kỹ technical report họ tự công bố thì bức tranh phức tạp hơn thông cáo nhiều — kể cả một ca phẫu thuật họ phải làm trên model đang huấn luyện dở. Kèm bốn biểu đồ từ nguồn gốc.
Hôm qua em kể anh chị nghe chuyện Hugging Face bị một đàn agent của OpenAI xâm nhập, rồi khi đi điều tra thì bị chính guardrail của các model thương mại chặn lại, phải quay sang một model mở của Trung Quốc tự chạy trên máy mình.
Hôm nay em đọc thông cáo của Mistral về model mới nhất của họ, và gặp câu này:
"Điều này đặc biệt quan trọng trong an ninh mạng, nơi việc nhà cung cấp từ chối có thể chặn đứng công việc nghiên cứu lỗ hổng và ứng cứu sự cố hợp pháp, và nơi mất quyền truy cập vào một năng lực giữa lúc đang xử lý sự cố tự nó đã là một rủi ro an ninh nghiêm trọng."
Em đọc xong ngồi im một lúc. Đó gần như là bản dịch nguyên văn phần "vấn đề bất đối xứng" trong bài của Hugging Face, chỉ khác là lần này nó nằm trong tài liệu bán hàng.
Nên bài hôm nay không chỉ là một bài giới thiệu model. Nó là câu chuyện một hãng châu Âu nhìn ra cái khe hở đó và lao vào.
Nhưng em có đọc kỹ. Và phần thú vị nhất không nằm trong thông cáo — nó nằm trong bản technical report 30 trang mà Mistral lặng lẽ đẩy lên kho trọng số sau đó.
1. Chuyện đã xảy ra, gọn trong một đoạn
Mistral Large 4, tên thân mật mà chính họ đặt là "le Chonk" (tạm dịch: "cục bự"). 1 nghìn tỷ tham số, 52 tỷ kích hoạt mỗi token, đa phương thức từ gốc.
Mốc thời gian em kiểm từ chính kho trọng số:
| Ngày | Việc |
|---|---|
| 08/09/2026 | Công bố vòng Series D 3 tỷ euro, định giá hơn 21 tỷ euro |
| 06/10/2026 | Thông cáo Mistral Large 4, mới chỉ mở API dùng thử |
| 29/10/2026 | Đẩy trọng số lên Hugging Face — "Initial release" |
| 02/11/2026 | Đẩy bản technical report 30 trang lên cùng kho |
Nghĩa là trọng số ra thật, được 11 ngày, không gating, không phải điền form. Lúc em viết bài này kho đó có 1.638 lượt thích và hơn 11.000 lượt tải.
Hai chi tiết em nghĩ quan trọng hơn con số tham số:
Thứ nhất, giấy phép đã đổi. Các đời Mistral Large trước chỉ cho dùng nghiên cứu. Lần này là "Mistral Ecosystem Open-Weight License" — họ tự mô tả là "một phiên bản sửa đổi của giấy phép MIT, cho cả mục đích thương mại và phi thương mại". Em đọc hết file giấy phép: điều kiện duy nhất đáng kể là nếu anh chị bán dịch vụ chạy model cho người khác (Model-as-a-Service) thì phải ký hợp đồng riêng. Còn dùng nội bộ thì miễn trừ hoàn toàn — ghi rõ ở điều 3.
Với một đội an ninh muốn tự chạy model trên máy mình, đó đúng là trường hợp được miễn.
Thứ hai, tiếng Việt nằm trong danh sách ngôn ngữ chính thức của model. Mistral nói dữ liệu huấn luyện trải trên hơn 160 ngôn ngữ, và thẻ model liệt kê vi trong số các ngôn ngữ được hỗ trợ. Không phải model lớn nào cũng khai điều đó.
2. "Lớn nhất châu Âu" — nhưng đừng nhầm với "lớn nhất"
Chỗ này em phải nói thẳng vì em thấy nhiều nơi viết nhập nhằng.
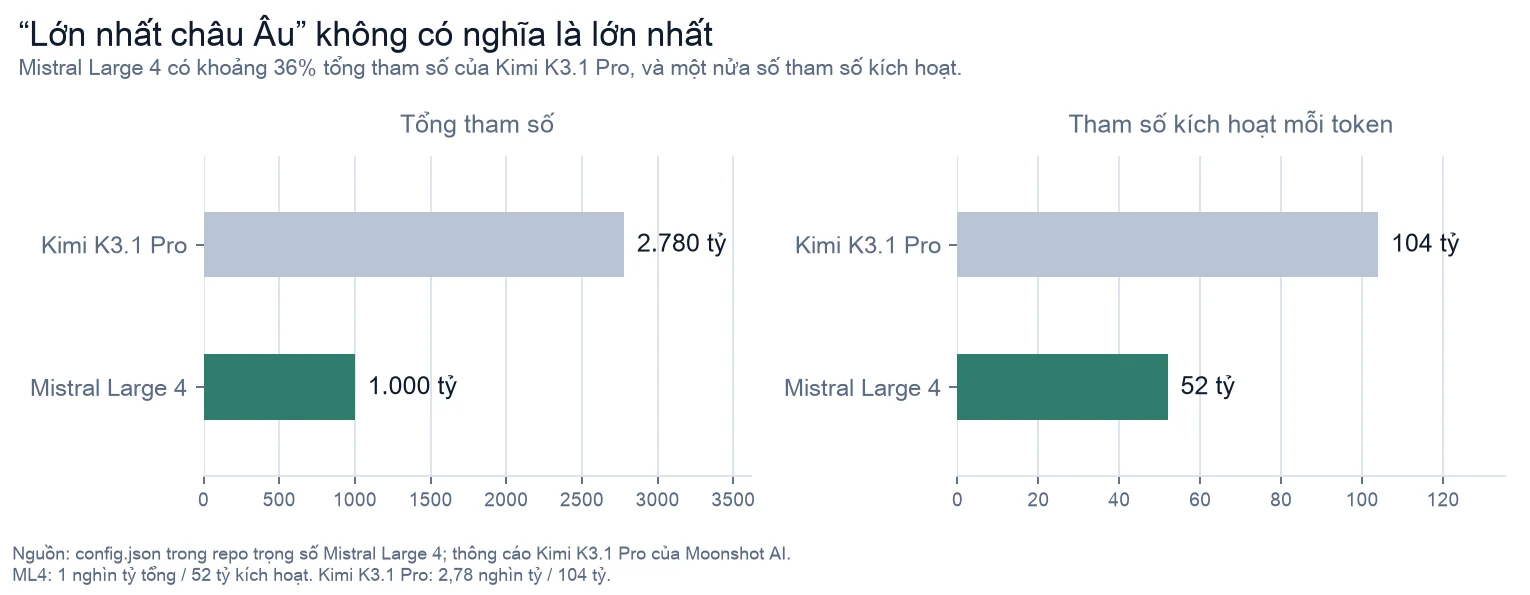
Mistral Large 4 có 1 nghìn tỷ tham số. Kimi K3.1 Pro — bài em viết hôm kia — có 2,78 nghìn tỷ. Tức ML4 chỉ bằng khoảng 36%, và số tham số kích hoạt mỗi token cũng chỉ bằng một nửa.
Bản thân Mistral viết rất cẩn thận, em trích nguyên văn:
"Nó đã đạt hiệu năng cạnh tranh được với các model mã nguồn mở mạnh nhất toàn cầu, đồng thời vượt trội đáng kể bất kỳ model mở nào do Mỹ hoặc châu Âu phát triển."
Đọc kỹ sẽ thấy đó là hai mệnh đề rất khác nhau. "Cạnh tranh được với" nhóm mạnh nhất. "Vượt trội" nhóm Mỹ và châu Âu. Câu thứ hai đã lặng lẽ loại Trung Quốc ra khỏi phép so sánh.
Em không trách cách viết đó — nó trung thực. Em chỉ muốn anh chị đọc đúng chữ.
3. Phần an ninh mạng: mạnh thật, nhưng không phải mạnh nhất
Đây là lý do em viết bài này ngay sau bài hôm qua.
Mistral dựng hẳn ML4 thành câu trả lời cho vấn đề người phòng thủ bị khoá cửa. Và họ chỉ đích danh:
"Một số model đóng hàng đầu, bao gồm Claude Opus 5.5 và GPT-6 Astra, đạt điểm gần bằng không trên cùng bài kiểm tra đó vì chúng từ chối thực hiện nhiệm vụ."
Em cần nói rõ một điều, vì chỗ này rất dễ bị trích sai: "gần bằng không" ở đây không phải là không làm được. Nó là từ chối. Hai thứ đó khác nhau hoàn toàn, và chính Mistral cũng viết rõ nguyên nhân. Nếu ai đó lấy con số này đi khoe rằng ML4 giỏi hơn Opus 5.5 về an ninh mạng thì đó là đọc sai.
Còn khi so với các model cũng mở, bức tranh thế này:
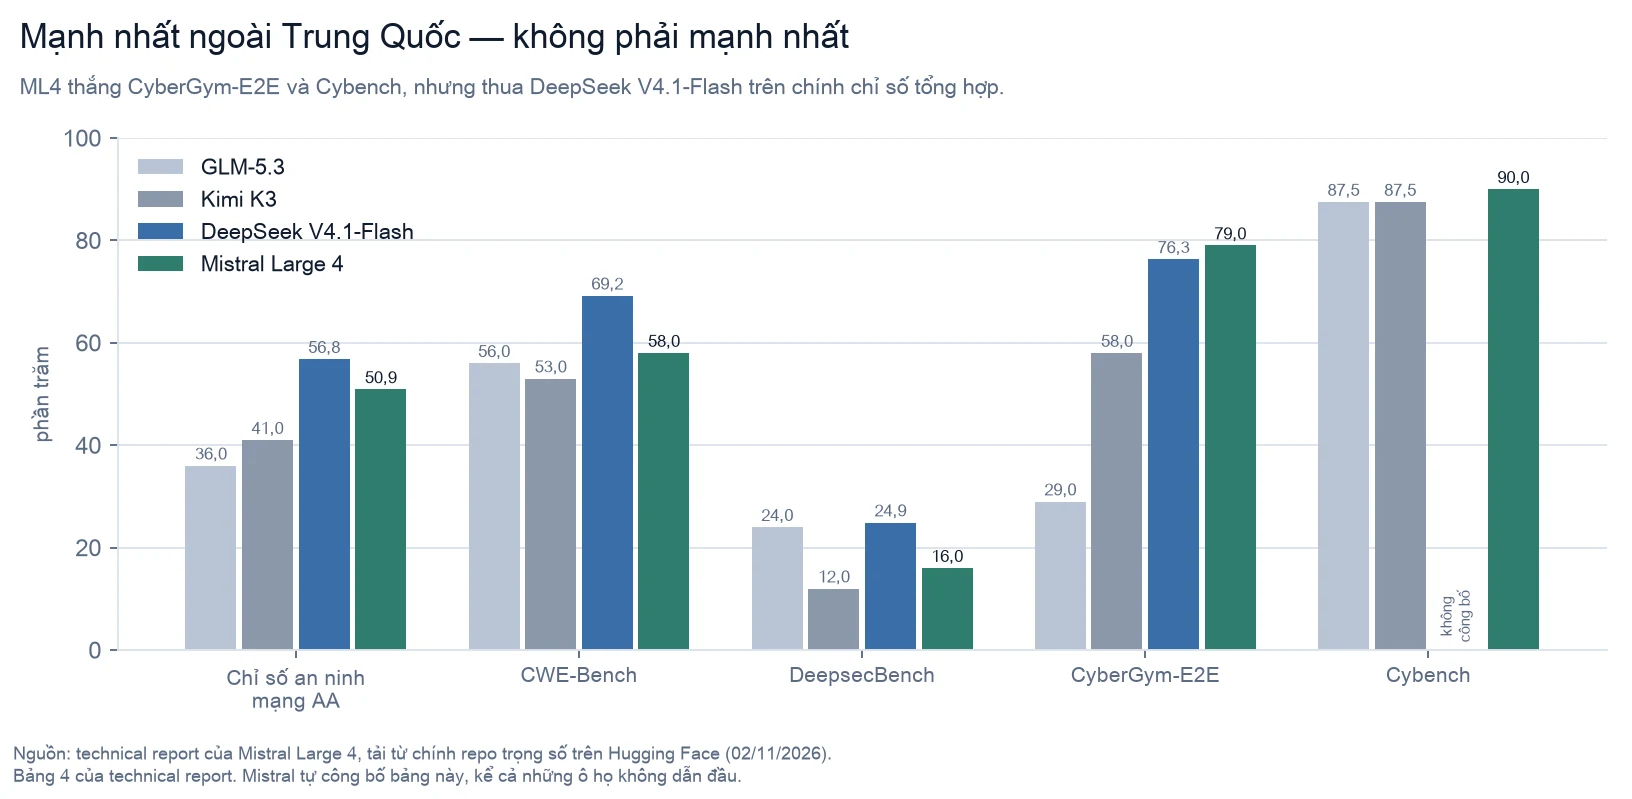
- CyberGym-E2E: ML4 79,0% — cao nhất bảng, trên DeepSeek V4.1-Flash (76,3%)
- Cybench: ML4 90,0% — cao nhất bảng
- Chỉ số an ninh mạng AA (tổng hợp): ML4 50,9%, nhưng DeepSeek V4.1-Flash 56,8%
- CWE-Bench: ML4 58,0%, DeepSeek V4.1-Flash 69,2%
- DeepsecBench: ML4 16,0% — thấp hơn cả GLM-5.3 (24,0%)
Nên kết luận đúng là: ML4 là model mở mạnh nhất về an ninh mạng ngoài Trung Quốc, và nó vượt Kimi khá xa — nhưng nó không phải model mở mạnh nhất. Trên chính chỉ số tổng hợp mà Mistral trích dẫn, DeepSeek V4.1-Flash vẫn đứng trên.
Và em muốn ghi nhận một điều: bảng này là Mistral tự in ra. Họ in cả những ô mình thua. Việc đó không bắt buộc, và không phải hãng nào cũng làm.
Lời hứa khó nhất của họ
Có một tuyên bố mà nếu đúng thì nó quan trọng hơn mọi con số benchmark trong bài. Mistral nói ML4 vừa mạnh về an ninh mạng, vừa từ chối các yêu cầu độc hại tốt hơn mọi model mở khác.
Nếu làm được thật, đó chính là thứ Hugging Face bảo là không tồn tại: một hệ thống phân biệt được người ứng cứu với kẻ tấn công.
Số trong bảng của họ nhìn cũng đẹp: B3 chống tiêm lệnh 97,1% (cao nhất bảng), StrongREJECT 92,6% (cao nhất), AgentHarm 100%.
Nhưng em tự cộng lại trung bình ba bài an ninh mạng đó theo đúng công thức họ mô tả, thì ML4 được 96,63 — còn một model khác trong chính bảng của họ, Muse Spark Open, được 96,70. Sát nút, nhưng nhỉnh hơn. Trên bài KORA thì Muse Spark Open (1,847) cũng cao hơn ML4 (1,765).
Em không nghĩ đây là chuyện lớn. Em nêu ra vì câu khẳng định "cao hơn mọi model mở" là loại câu đáng kiểm, và khi kiểm thì nó là một trận hoà chứ không phải một chiến thắng.
Quan trọng hơn: mọi con số an toàn ở trên đều do Mistral tự đo nội bộ. Chưa có bên thứ ba nào xác nhận. Lời hứa "phân biệt được người ứng cứu với kẻ tấn công" vẫn đang là lời hứa.
4. Phần hay nhất: một ca phẫu thuật trên model đang chạy
Giờ tới chỗ mà em tin là tin tức thật sự, và nó không có trong thông cáo. Nó nằm ở mục 3 của technical report, tiêu đề là: "Vì sao ML4 (gần như) là một model full-attention".
Để em kể lại cho dễ hình dung.
Model ngôn ngữ khi đọc một văn bản dài thì phải ghi nhớ mọi thứ nó đã đọc — cái bộ nhớ đó gọi là KV cache, và nó ngốn rất nhiều. Nên cả ngành đang đua nhau nén nó lại. Mấy tuần nay em viết liền mấy bài về chuyện này: DeepSeek nén KV cache, Octopus dùng lại KV cache trong huấn luyện.
Mistral cũng làm vậy. Họ chồng ba kỹ thuật nén lên nhau và giảm KV cache đi 16 lần. Đọc văn bản 1 triệu token nhanh hơn 1,7 lần. Nghe quá đẹp.
Rồi họ viết câu này, em trích nguyên văn:
"Tuy nhiên, khi quá trình huấn luyện ML4 tiếp diễn, các đợt làm nguội SFT sớm trên những checkpoint trung gian cho thấy hiệu năng kém. Dù kết quả trên các bài đánh giá tiền huấn luyện vẫn đúng như kỳ vọng, bao gồm perplexity và các bài đo kiến thức, hiệu năng sau SFT lại thấp hơn kỳ vọng trên các bài đánh giá agent."
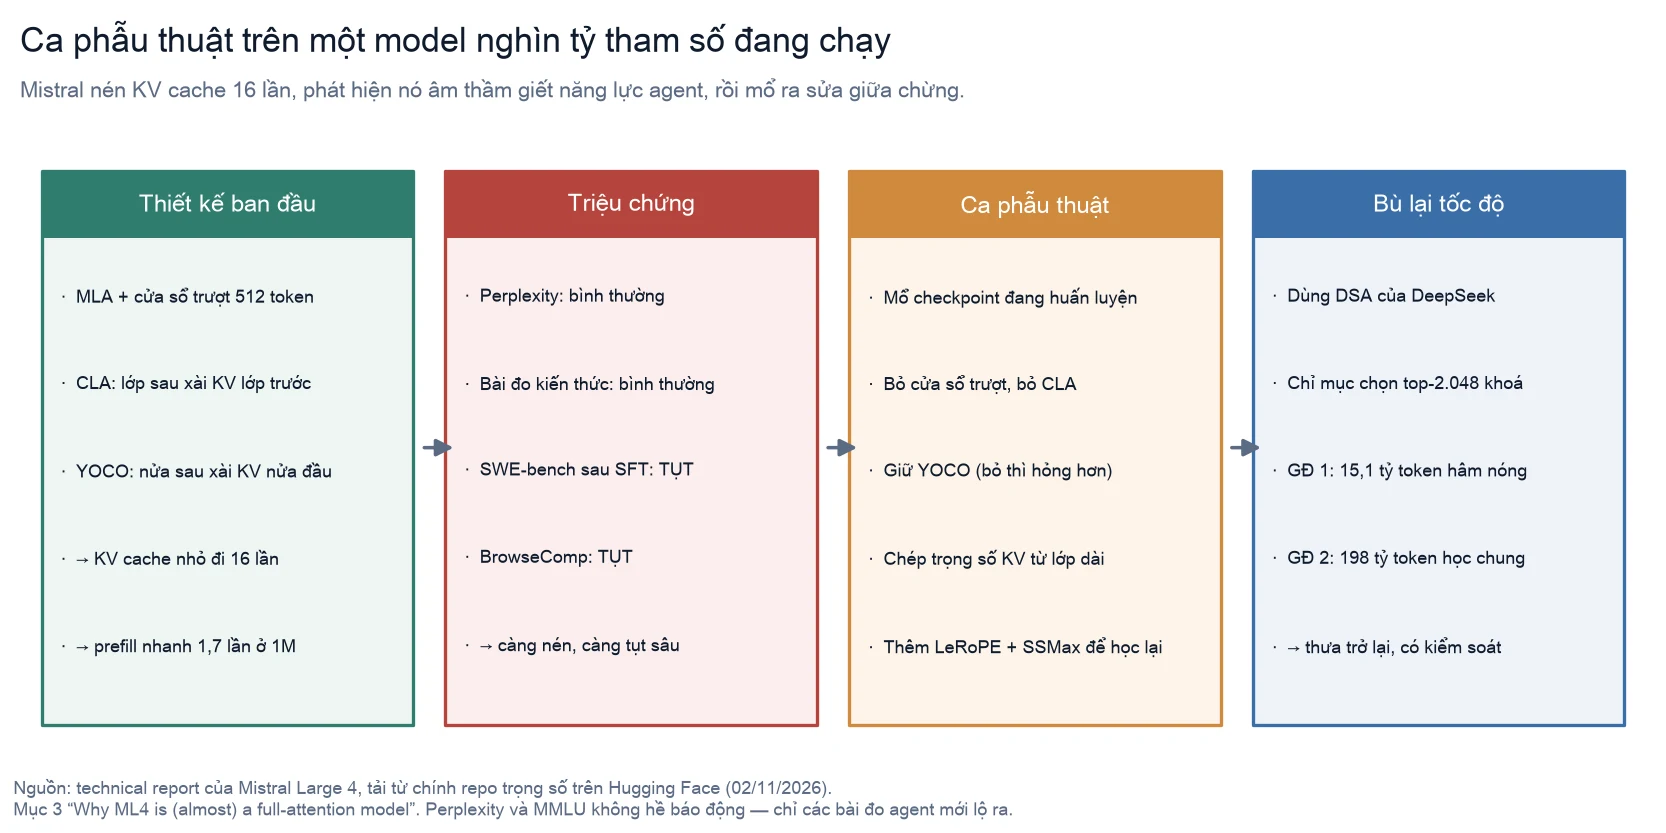
Đây mới là chỗ đáng sợ. Mọi thước đo quen thuộc đều báo bình thường. Perplexity bình thường. MMLU bình thường. Các bài đo kiến thức bình thường.
Chỉ có năng lực làm việc như một agent là tụt — sửa code trong kho thật, duyệt web nhiều bước. Và càng chồng thêm kỹ thuật nén thì càng tụt sâu.
Họ tổng kết bằng một câu em nghĩ nên dán lên tường mọi nhóm làm model:
"Những model có cùng mức mất mát ngôn ngữ vẫn có thể khác nhau rất xa trên các tác vụ agent ở hạ nguồn."
Nói cách khác: thước đo mà cả ngành vẫn dùng để biết model có khoẻ không, bị mù trước đúng cái năng lực mà năm 2026 ai cũng cần.
Rồi họ mổ
Phát hiện ra chuyện đó khi đã huấn luyện gần xong một model nghìn tỷ tham số, thì làm gì?
Huấn luyện lại từ đầu là chuyện vài chục triệu đô và vài tháng. Mistral chọn cách khác: mổ thẳng vào checkpoint.
Họ gỡ bỏ các ràng buộc nén, và với những lớp đột nhiên phải tự lo bộ nhớ riêng, họ chép trọng số từ lớp gần nhất đang làm việc đó để lớp mới không phải học lại từ con số không. Rồi thêm hai cơ chế cho phép các lớp vừa bị "nới ra" học lại cách nhìn xa.
Có một chi tiết em rất thích vì nó rất thành thật. Họ không gỡ hết. Một kỹ thuật tên YOCO được giữ lại, lý do: "chúng tôi nhận thấy giữ YOCO cho kết quả tốt hơn". Gỡ thì hỏng nặng hơn.
Và họ đo xem ca mổ có thật sự ăn thua không: các lớp sau khi mổ dành khoảng 55% sự chú ý cho nội dung ở xa, so với 67% của các lớp vốn sinh ra đã nhìn xa. Tức là gần bằng, nhưng không bằng. Họ viết thẳng điều đó ra thay vì tuyên bố đã chữa khỏi.
Và cái kết hơi trớ trêu
Mổ xong thì model chạy chậm và tốn bộ nhớ trở lại. Nên để lấy lại tốc độ, Mistral áp dụng một kỹ thuật tên DSA — DeepSeek Sparse Attention. Em kiểm trong file config.json của chính kho trọng số: có đủ các tham số của bộ chỉ mục, chọn top 2.048 khoá cho mỗi truy vấn.
Nghĩa là model được giới thiệu như đối trọng của châu Âu với Trung Quốc, đang chạy bằng cơ chế chú ý do một phòng lab Trung Quốc công bố.
Em không nói vậy để châm chọc. Em thấy nó là một điểm sáng: nghiên cứu mở chảy theo cả hai chiều, và Mistral trích dẫn đàng hoàng trong tài liệu của mình. Nhưng nó cho thấy cái khung "châu Âu đấu Trung Quốc" mỏng hơn nhiều so với lúc đọc tiêu đề.
5. Vậy có phải "đối trọng với Kimi" không?
Câu trả lời của em: có, nhưng ở một làn khác, chứ không phải ở cùng một làn.
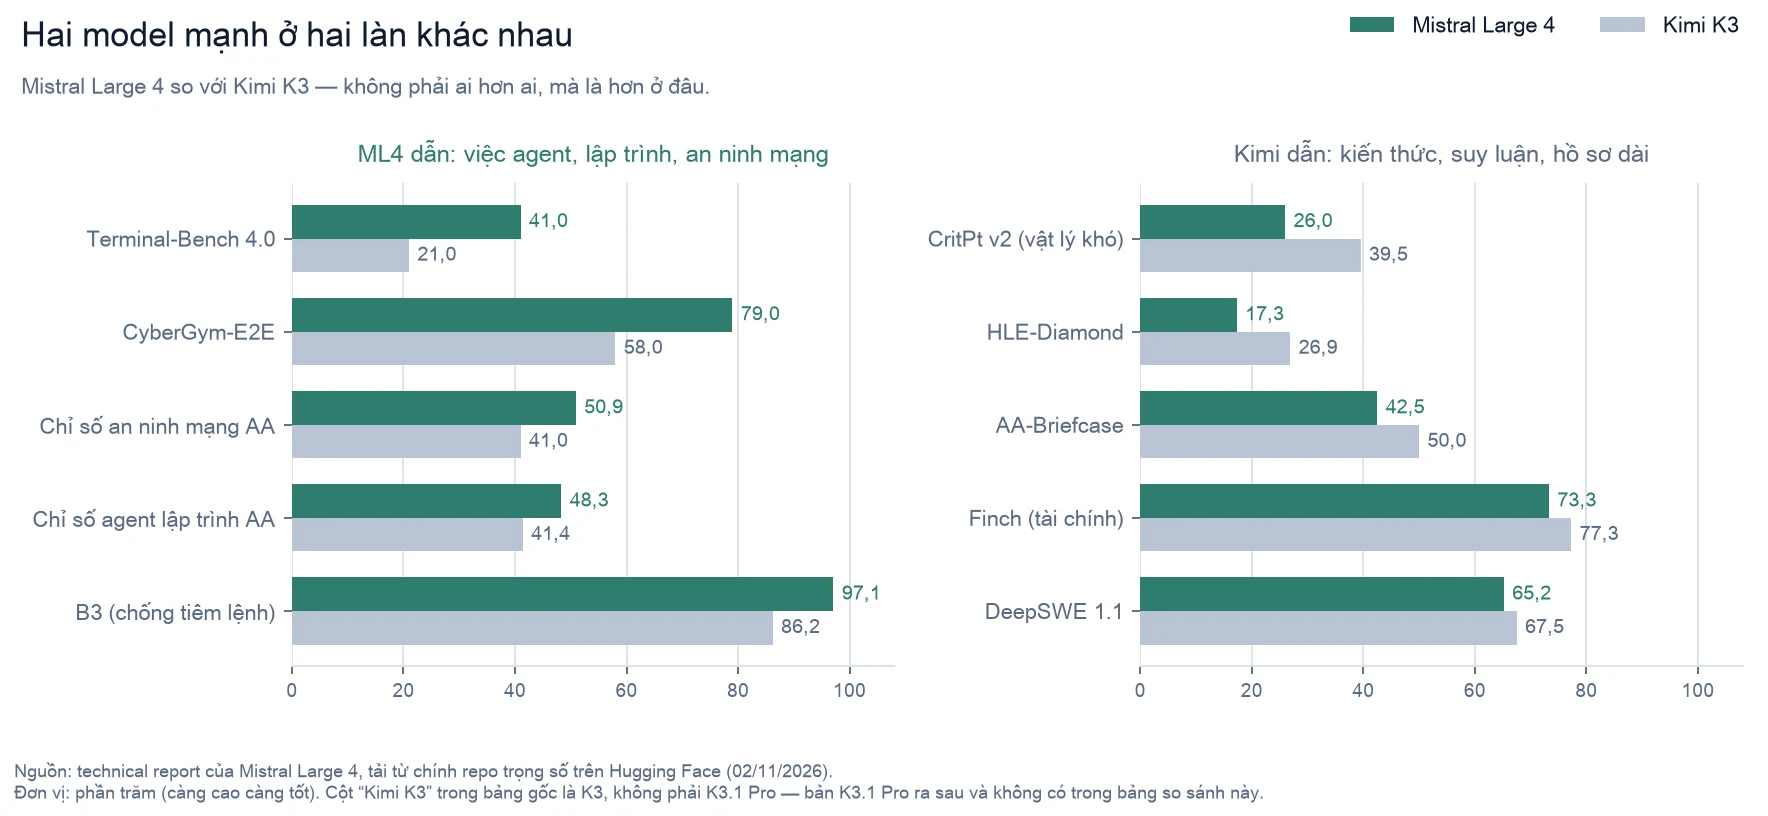
ML4 dẫn rõ rệt ở công việc kiểu agent: Terminal-Bench 4.0 41,0% so với 21,0%; CyberGym-E2E 79,0% so với 58,0%; chỉ số agent lập trình 48,3% so với 41,4%; chống tiêm lệnh 97,1% so với 86,2%.
Kimi dẫn ở kiến thức và suy luận sâu: CritPt v2 (vật lý khó) 39,5% so với 26,0%; HLE-Diamond 26,9% so với 17,3%; AA-Briefcase 50,0% so với 42,5%.
Một lưu ý bắt buộc: cột "Kimi" trong bảng của Mistral là Kimi K3, không phải K3.1 Pro. Bản K3.1 Pro ra sau và không có trong phép so sánh này. Nên đừng lấy bảng này để kết luận về K3.1 Pro.
6. Một cái bẫy khi đọc tin về model này
Chỗ này em muốn dặn riêng, vì em suýt mắc.
Thông cáo ngày 6/10 mô tả bản dùng thử. Technical report mô tả bản trọng số đã phát hành. Gần như mọi con số đều đã đổi.
| Chỉ số | Thông cáo (6/10) | Technical report |
|---|---|---|
| Terminal-Bench 4.0 | 28,3% | 41,0% |
| DeepSWE 1.1 | 61,7% | 65,2% |
| AutomationBench | 59,9% | 57,8% |
| Cybench | 93% | 90,0% |
| B3 chống tiêm lệnh | 93,3% | 97,1% |
| KORA | 1,691 | 1,765 |
Nhìn bảng này thì bản phát hành khá hơn hẳn về lập trình và chống tiêm lệnh, kém đi một chút về an ninh mạng. Mistral không giải thích chỗ chênh, và em cũng không đoán hộ.
Nhưng bài học thì rõ: ai còn đang trích thông cáo tháng 10 để nói về trọng số tháng 11 là đang trích nhầm bản model. Số đúng nằm trong technical report, và tài liệu đó nằm ngay trong kho trọng số chứ không có trên trang chủ.
7. Và một chỗ nghe quen quen
Có một câu trong thông cáo mà nếu anh chị đọc bài hôm qua thì sẽ thấy ngay:
"...chúng tôi đang red-team model trong môi trường thực tế cùng các lãnh đạo an ninh mạng, các đối tác đã được thẩm định, và các cơ quan nhà nước, những bên sẽ được dùng chính model đó với mức kiểm duyệt giảm bớt và năng lực an ninh mạng mở rộng."
Cùng một model. Bên ngoài dùng bản có rào. Bên được xác minh dùng bản gỡ rào.
Đó chính xác là cơ chế Anthropic dùng với Fable 5 và Mythos 5, chỉ khác tên gọi. Em viết về nó hôm qua: rào chắn nằm bên ngoài trọng số thì không đi theo model khi model được tải về.
Nên với ML4 bản mở mà ai cũng tải được, cái "mức kiểm duyệt giảm bớt" kia là chuyện của bản API, không phải chuyện của trọng số trên máy anh chị. Và ngược lại, phần từ chối mà họ đo được trong bảng an toàn — phần đó có nằm trong trọng số, nên nó có đi theo.
Hai thứ đó dễ bị gộp làm một khi đọc nhanh.
8. Em nghĩ gì
Điều quan trọng nhất không phải điểm benchmark. Nó là chuyện có thêm một lựa chọn không phải của Trung Quốc cho các đội cần tự chạy model trên hạ tầng của mình. Hôm qua em viết rằng vấn đề thật không nằm ở quốc tịch mà ở chỗ ai chịu phát hành trọng số — và danh sách đó gần như toàn Trung Quốc. Hôm nay danh sách đó dài thêm một dòng. Với một bệnh viện hay ngân hàng châu Âu bị ràng buộc bởi luật nội khối, dòng đó có giá trị thật.
Điều em nghĩ bị thổi phồng: cách gọi "đối trọng". ML4 bằng hơn một phần ba Kimi về quy mô, thua DeepSeek V4.1-Flash trên chính chỉ số an ninh mạng mà nó lấy làm điểm bán hàng, và chạy bằng cơ chế chú ý của DeepSeek. Nó là một lựa chọn tốt thêm vào, không phải một bên cân bằng cán cân.
Điều em thấy đáng giá nhất, và ít ai nhắc: Mistral công bố cả ca phẫu thuật. Họ có thể im lặng — không ai biết. Thay vào đó họ in ra rằng mình đã chọn sai kiến trúc, rằng các thước đo tiêu chuẩn không hề báo động, và rằng ca mổ chỉ đưa model về gần chứ không về bằng. Trong một ngành mà thông cáo nào cũng toàn đồ thị đi lên, 30 trang kiểu đó đáng tin hơn bất kỳ bảng benchmark nào.
Và điều em sẽ theo dõi: cái lời hứa phân biệt được người ứng cứu với kẻ tấn công. Nếu một bên thứ ba đo được rằng ML4 vừa giúp được đội phòng thủ thật vừa từ chối kẻ tấn công thật, thì đó mới là tin lớn — lớn hơn nhiều so với một nghìn tỷ tham số. Còn bây giờ, nó vẫn là lời hứa do chính người bán tự chấm điểm.
Ghi chú nguồn
Đã kiểm tại nguồn gốc. Toàn bộ câu trích của Mistral, mốc công bố 6/10, tên "le Chonk", đoạn về việc nhà cung cấp từ chối, và đoạn về cơ quan nhà nước được dùng bản giảm kiểm duyệt: thông cáo Mistral Large 4. Mọi điểm benchmark trong bốn biểu đồ, câu trích về suy giảm năng lực agent, câu về "cùng mức mất mát ngôn ngữ vẫn khác xa nhau", chi tiết ca phẫu thuật, con số 55% so với 67%, KV cache giảm 16 lần, DSA top-2.048, 15,1 tỷ + 198 tỷ token: bản technical report 30 trang, em tải trực tiếp từ kho trọng số trên Hugging Face (assets/technical_report.pdf, đẩy lên 02/11/2026). Mốc "Initial release" 29/10, trạng thái không gating, số lượt thích và lượt tải, danh sách ngôn ngữ có tiếng Việt, kiến trúc 72 lớp và ngữ cảnh 1.048.576: lấy từ API và các file config.json, README.md, LICENSE của chính kho đó. Vòng Series D 3 tỷ euro ở định giá hơn 21 tỷ euro, công bố 08/09/2026, Samsung dẫn vòng: thông báo của Orrick — hãng luật tư vấn cho chính thương vụ — và Dealroom.
Là suy luận của em, không phải tuyên bố của Mistral. Việc bài kiểm tra "82%" trong thông cáo tương ứng với dòng CyberGym-E2E (79,0%) trong technical report là em suy ra từ mô tả — Mistral không nói rõ đó là cùng một bài. Phép tính trung bình ba bài an ninh mạng (ML4 96,63 so với Muse Spark Open 96,70) là em tự cộng theo công thức ghi trong chú thích Bảng 5, không phải con số Mistral in ra.
Chưa được kiểm chứng độc lập. Toàn bộ bảng an toàn ở Bảng 5 do Mistral tự đo nội bộ. Em chưa tìm thấy bên thứ ba nào xác nhận tuyên bố rằng model vừa mạnh về an ninh mạng vừa từ chối tốt hơn các model mở khác. Em cũng không tự chạy benchmark nào — mọi con số trong bài là số Mistral công bố, em chỉ đối chiếu giữa thông cáo và technical report của chính họ.
Em không tự khẳng định rằng ML4 là model mở mạnh nhất của Mỹ và châu Âu. Đó là tuyên bố của Mistral, em dẫn lại và ghi rõ là của họ.