Kimi K3.1 Pro: model mở lớn nhất từng phát hành — và nhà sản xuất đã cố tình làm nó yếu đi một chỗ
2.780.110.363.392 tham số, 1,56 TB, ai cũng tải được. Nó đứng đầu nhóm mã nguồn mở, hơn hạng nhì 13 điểm. Nhưng chi tiết đáng chú ý nhất là Moonshot tự công bố rằng bản chưa kiểm soát của họ giỏi tấn công mạng hơn bản đem phát hành 9,5 điểm — và họ in cả hai con số ra. Kèm bốn biểu đồ từ nguồn gốc.
Em vào thẳng kho chính thức trên Hugging Face để đếm, vì con số này đáng được dẫn cho chính xác:
2.780.110.363.392 tham số.
Hai nghìn bảy trăm tám mươi tỷ. Chia thành 96 mảnh tệp, tổng cộng 1,56 TB. Không cần xin phép, không cần duyệt — bấm là tải.
Đây là model mở lớn nhất từng được phát hành ra công chúng. Và theo bảng đo độc lập, nó cũng là model mở mạnh nhất hiện nay.
Nhưng thứ làm em muốn viết bài này không phải hai cái "nhất" đó. Mà là một đoạn nằm giữa thông cáo, chỗ mà một hãng bình thường sẽ im lặng cho qua:
Moonshot tự nói rằng họ đã làm cho model của mình kém đi — và in ra chính xác là kém bao nhiêu.
Em sẽ kể phần đó ở mục 3. Trước hết, mình xem nó là cái gì đã.
1. Lớn cỡ nào, mạnh cỡ nào
Kimi K3.1 Pro là model đầu tiên trong dòng K3.1 của Moonshot AI. Nó là bản huấn luyện tiếp từ Kimi K3, với lượng tính toán cho giai đoạn hậu huấn luyện lớn hơn hẳn.
Vài thông số em kiểm tại kho gốc:
| Tổng tham số | 2,78 nghìn tỷ |
| Kích hoạt mỗi token | 104 tỷ |
| Cửa sổ ngữ cảnh | 1 triệu token |
| Dung lượng tải về | 1,56 TB, 96 mảnh |
| Đầu vào | Chữ và ảnh |
| Ngày mở trọng số | 04/11/2026 |
Chỗ đáng chú ý: nó chỉ kích hoạt 104 tỷ tham số cho mỗi token, tức chưa tới 4% tổng số. Đây là kiến trúc "hỗn hợp chuyên gia" — model có rất nhiều chuyên gia con, nhưng mỗi lần chỉ gọi vài người phù hợp. Nhờ vậy nó to khủng khiếp mà chạy vẫn nổi.
Về sức mạnh, em không lấy số của chính hãng mà lấy bảng đo độc lập:
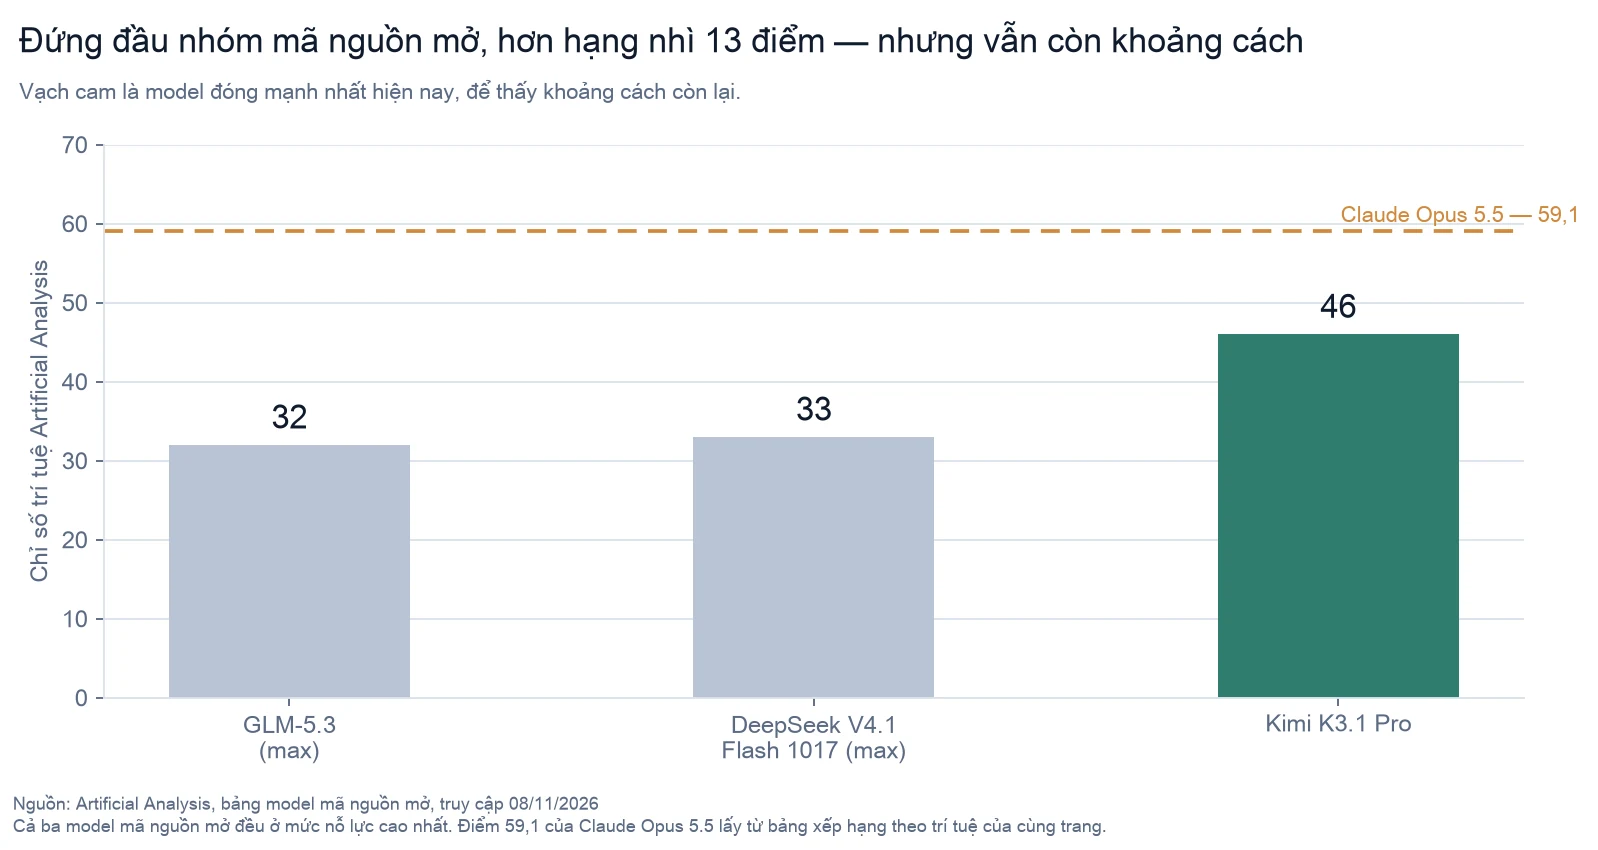
46 điểm. Hạng nhì là DeepSeek V4.1 Flash với 33, hạng ba là GLM-5.3 với 32. Nó không chỉ đứng đầu — nó hơn hạng nhì 13 điểm, một khoảng cách rất lớn trong nhóm này.
Nhưng em vẽ thêm vạch cam để anh chị thấy toàn cảnh: model đóng mạnh nhất hiện nay, Claude Opus 5.5, được 59,1. Khoảng cách giữa model mở tốt nhất và model đóng tốt nhất vẫn còn 13 điểm nữa.
Nói cách khác: K3.1 Pro vừa rút ngắn một nửa khoảng cách giữa mở và đóng. Chưa đuổi kịp, nhưng gần hơn bao giờ hết.
Vài điểm benchmark cụ thể từ thông cáo:
- Terminal-Bench 4.0 (agent lập trình trong terminal): 65,7%, hơn GPT-6 Astra (58,2%) và chỉ kém Claude Opus 5.5 (66,4%) 0,7 điểm.
- BenchCAD (dựng mô hình 3D từ ảnh): 92,7%, so với 96,2% của Opus 5.5.
- OfficeQA Pro v2 (phân tích tài liệu tài chính): 64,4 — theo họ là tốt nhất hiện nay.
2. Nó làm được gì — một ví dụ em thấy ấn tượng
Thông cáo kể một thí nghiệm nội bộ mà em đọc hai lần.
Họ bảo K3.1 Pro dựng một mô phỏng dáng đi của con người, trên nền human-atlas — một mô hình giải phẫu mã nguồn mở gồm 296 bộ phận xương và 402 bộ phận cơ. Qua 167 lượt nhiệm vụ và 420 lần đánh giá độc lập, nó tự phân tích kết quả, tự chẩn đoán lỗi, tự chỉnh lại bộ điều khiển.
Người mô phỏng đi từ chỗ đổ gục trong vài giây đến chỗ bước liên tục 11,2 giây.
Nhưng chi tiết hay nhất là chỗ này. Khi chỉnh phần thưởng mãi mà tay vẫn vung sai, nó không tiếp tục chỉnh phần thưởng. Nó quay sang chạy thử các phép đo lên chính bộ mô phỏng, rồi phát hiện và sửa 36 lỗi tính toán cánh tay đòn cơ vai — tức là lỗi nằm trong môi trường, không phải trong model nó đang luyện. Sửa xong mới luyện lại.
Nói nôm na: nó phát hiện cái thước đo bị sai, chứ không phải học trò làm sai. Đó là kiểu suy luận mà em thấy đáng chú ý hơn mọi điểm benchmark.
3. Và đây là phần em muốn viết bài này
Giờ tới chỗ hiếm gặp.
Trong lúc phát triển, Moonshot nhận ra một chuyện: năng lực tìm lỗ hổng bảo mật của model cứ tăng đều theo quy mô hậu huấn luyện. Họ truy ngược, và thấy lý do rất đời thường — dữ liệu về an ninh mạng nằm lẫn trong kho dữ liệu chung, và các bài tập liên quan tới bảo mật có mặt trong môi trường huấn luyện tăng cường. Họ gọi đó là "hệ quả tự nhiên của việc huấn luyện trên dữ liệu rộng."
Rồi họ làm một việc: với bản đem mở trọng số, họ lọc bỏ dữ liệu an ninh mạng ra khỏi cả hai giai đoạn huấn luyện, trong khi vẫn giữ lại các bài lập trình thông thường để model còn hữu dụng.
Và đây là lý do em viết bài này:
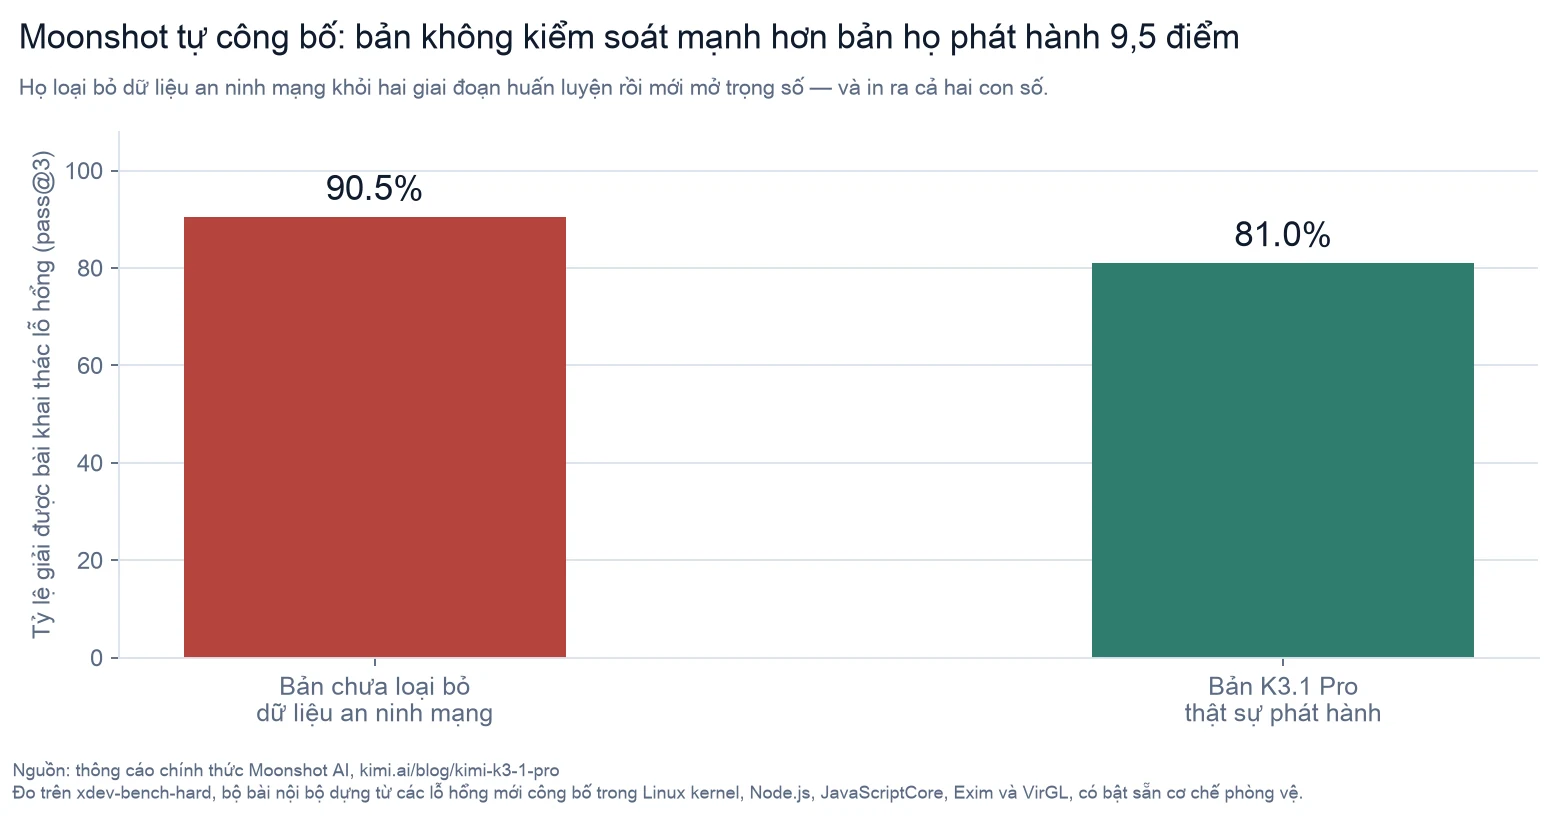
Trên bộ bài nội bộ của họ — dựng từ các lỗ hổng mới công bố trong Linux kernel, Node.js, JavaScriptCore, Exim, VirGL, có bật sẵn cơ chế phòng vệ, và model phải thật sự viết được mã khai thác chạy được — thì:
- Bản không áp dụng biện pháp kiểm soát: giải được 90,5%
- Bản K3.1 Pro thật sự phát hành: 81,0%
Họ công bố cả hai con số.
Em dừng lại ở đây một chút, vì em nghĩ nhiều người sẽ lướt qua mà không thấy nó lạ chỗ nào.
Một hãng vừa nói với cả thế giới: "Chúng tôi có thể làm ra thứ nguy hiểm hơn thứ chúng tôi vừa đưa cho các bạn, và đây là con số chính xác." Không hãng nào bắt buộc phải nói điều đó. Nói ra thì vừa tự thừa nhận mình đang kìm bớt, vừa cho đối thủ biết trần năng lực của mình ở đâu.
Nguyên tắc họ nêu ra có hai vế, và em thấy vế thứ hai mới đáng bàn:
- Không phát hành trọng số mở nào đẩy xa thêm giới hạn tuyệt đối về năng lực tấn công mạng. Năng lực của K3.1 Pro, theo đúng chủ ý, thấp hơn mức mà dây chuyền của họ có thể tạo ra, và vẫn kém các model đóng đã ra mắt ít nhất ba tháng.
- Nhưng họ dự định nâng dần mức năng lực an ninh mạng có trong trọng số mở.
Lập luận của họ cho vế hai: khi một model đủ mạnh được mở và chạy trên hạ tầng do chính người dùng kiểm soát, thì nhiều đội ngũ hơn có khả năng tự rà soát mã nguồn của mình — kể cả những hệ thống cũ kỹ hiếm khi được ai kiểm tra bảo mật. Họ tin rằng để năng lực đó lan ra từ từ sẽ an toàn hơn là để nó tập trung trong tay vài hệ thống đóng.
Chuyện này nối thẳng với bài em viết hôm qua — nơi OpenAI tự tính ra rằng tìm lỗ hổng bằng AI giờ đã có lãi. Hai cách tiếp cận rất khác nhau của hai hãng, trong cùng một tuần. Em không nói ai đúng. Nhưng việc cả hai đều công bố con số thay vì im lặng thì em thấy là chuyện tốt.
4. Cái giá phải trả
Mạnh nhất không có nghĩa là hợp nhất. So với DeepSeek V4.1 Flash — model mở đang được dùng nhiều nhất thế giới:
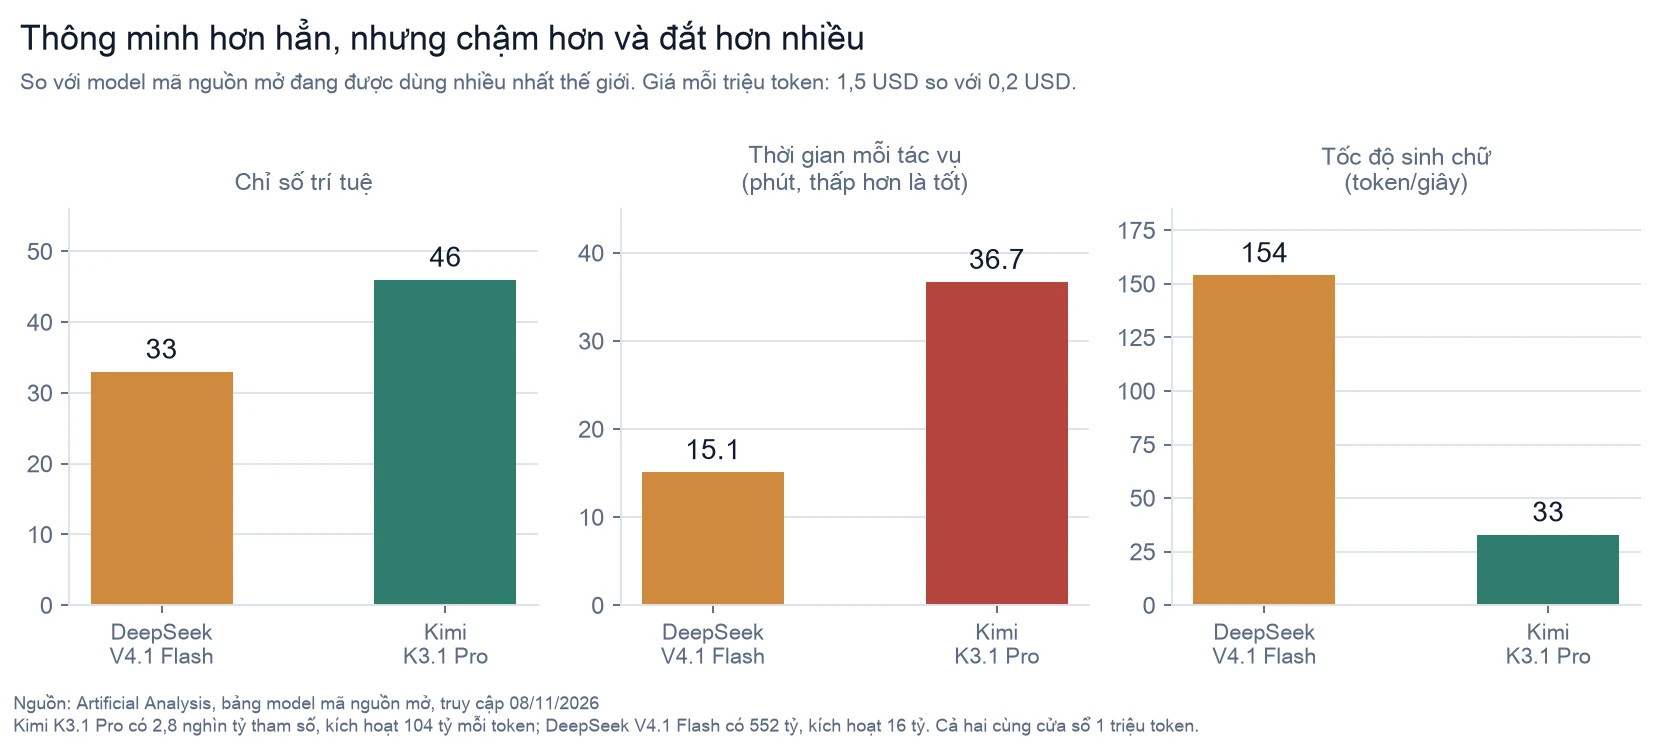
Kimi thông minh hơn hẳn (46 so với 33). Nhưng nó mất 36,7 phút cho mỗi tác vụ, so với 15,1 phút — chậm hơn gấp đôi. Và nó sinh chữ ở 33 token/giây, so với 154 — chậm hơn gần năm lần. Giá mỗi triệu token cũng cao hơn: 1,5 USD so với 0,2 USD.
Nhìn vào đó thì dễ hiểu vì sao DeepSeek mới là cái được dùng nhiều nhất chứ không phải Kimi. Phần lớn công việc hằng ngày cần nhanh và rẻ, không cần thông minh nhất.
Còn một tin tốt: tỷ lệ bịa đặt giảm rất mạnh.
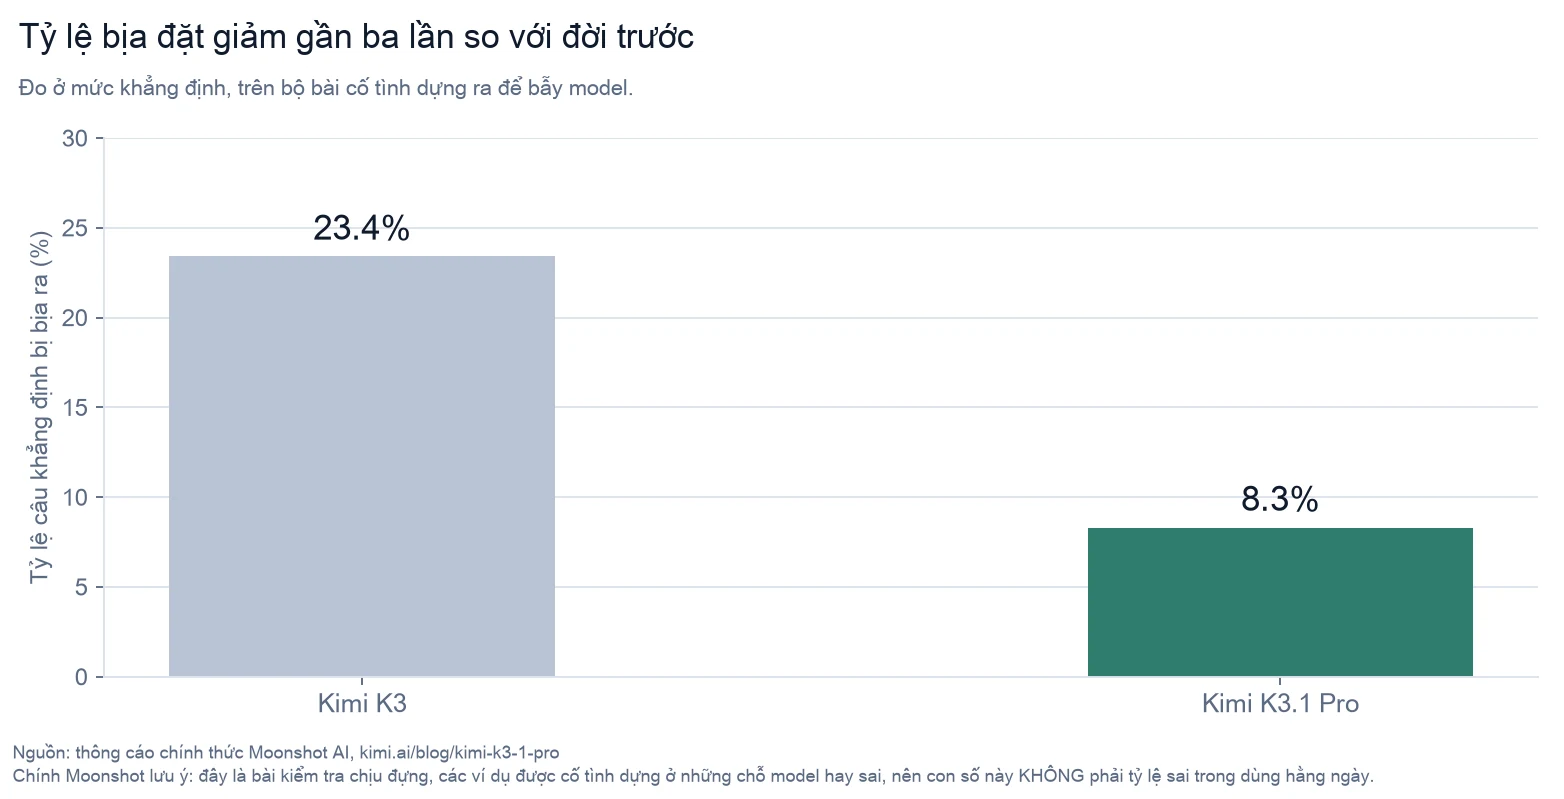
Từ 23,4% xuống 8,3% so với đời trước, đo ở mức từng câu khẳng định. Nhưng em phải nêu đúng lời cảnh báo của chính Moonshot: đây là bài kiểm tra chịu đựng, các ví dụ được cố tình dựng ở những chỗ model hay sai, nên con số này không phải tỷ lệ sai trong dùng hằng ngày.
5. "Mã nguồn mở" ở đây nghĩa là gì?
Chỗ này em muốn nói cho rõ, vì chữ dùng dễ gây hiểu nhầm.
Moonshot dùng chữ "open-weight" — mở trọng số — chứ không phải "open-source" theo nghĩa chặt. Và giấy phép không phải MIT hay Apache, mà là một giấy phép riêng tên Kimi K3.1-Pro License. Em tải thẳng file về đọc.
Phần đầu thì rộng như MIT: cho dùng, sao chép, sửa, gộp, phát hành, bán, triển khai, tinh chỉnh, tạo sản phẩm phái sinh. Nhưng có hai điều kiện:
- Nếu anh chị kinh doanh dịch vụ cho thuê model (cho bên thứ ba gọi API và tự điều khiển đầu vào, tham số), và doanh thu vượt 20 triệu USD trong 12 tháng liên tiếp — thì phải ký thoả thuận riêng với Moonshot trước khi dùng cho mục đích thương mại.
- Nếu sản phẩm của anh chị có trên 100 triệu người dùng hằng tháng, hoặc trên 20 triệu USD doanh thu mỗi tháng — phải hiển thị rõ chữ "Kimi K3.1-Pro" trên giao diện.
Và một điều em thấy quan trọng cho phần lớn người đọc: cả hai điều kiện trên đều không áp dụng cho việc dùng nội bộ, tức là dùng mà không đưa model, đầu ra hay năng lực của nó cho bên thứ ba.
Nói cho gọn: với một người dùng bình thường, một nhóm khởi nghiệp, một công ty vừa và nhỏ ở Việt Nam — không có ràng buộc gì cả. Ngưỡng của họ đặt ở mức mà chỉ những công ty rất lớn mới chạm tới.
6. Nhưng anh chị có chạy nổi không?
Thành thật: gần như chắc chắn là không, nếu nói về máy cá nhân.
1,56 TB chỉ riêng phần tải về. Và em để ý một chi tiết trong cấu hình kho: trọng số công bố đã được nén xuống 4 bit (định dạng MXFP4) — tức là bản 1,56 TB này đã là bản nén rồi, chứ không phải bản gốc.
Để chạy nó anh chị cần một cụm GPU cỡ trung tâm dữ liệu. Giá trị thật của việc mở trọng số không nằm ở chỗ mỗi người tự chạy, mà ở chỗ:
- Các nhà cung cấp dịch vụ có thể cạnh tranh nhau để bán nó — như em đã viết trong bài về DeepSeek, nơi cùng một model mà giá chênh nhau tới 100 lần giữa các nơi bán.
- Các tổ chức cần dữ liệu không ra khỏi nhà — bệnh viện, ngân hàng, cơ quan nhà nước — có thể tự dựng trên hạ tầng của mình.
- Nhà nghiên cứu mổ xẻ được nó, thay vì chỉ gọi API và đoán.
Tại thời điểm em viết, kho trên Hugging Face đã có 22.571 lượt tải và 1.652 lượt thích.
Nếu chỉ nhớ một con số
Em chọn 9,5 điểm.
Không phải 2,78 nghìn tỷ tham số. Không phải 46 điểm trí tuệ.
Mà là khoảng cách giữa bản Moonshot có thể phát hành và bản họ đã phát hành — 90,5% xuống 81,0% trên bài kiểm tra khai thác lỗ hổng.
Con số đó không nói model này mạnh hay yếu. Nó nói rằng có một hãng đã tự nguyện đo mức nguy hiểm của sản phẩm mình, tự nguyện cắt bớt, rồi tự nguyện công bố cả hai số.
Trong một năm mà năng lực AI đang tăng gấp đôi mỗi vòng, em nghĩ cái thói quen đó — đo rồi nói ra — đáng giá hơn bất kỳ điểm benchmark nào. Vì benchmark thì ai cũng khoe. Còn con số cho thấy mình đang kìm bớt thì chẳng ai bắt buộc phải nói.
Ghi chú nguồn
Lấy trực tiếp từ nguồn gốc:
- Toàn bộ điểm benchmark, câu chuyện mô phỏng dáng đi, phần an ninh mạng và các con số 90,5% / 81,0%, tỷ lệ bịa đặt 23,4% / 8,3%: thông cáo chính thức Kimi K3.1 Pro của Moonshot AI. Mọi câu trích của họ trong bài đều từ trang này.
- Tổng tham số 2.780.110.363.392, dung lượng 1.561.355.732.732 byte, 96 mảnh safetensors, định dạng nén MXFP4 4 bit, ngày tạo kho, số lượt tải: siêu dữ liệu kho chính thức moonshotai/Kimi-K3.1-Pro trên Hugging Face. Em đọc thẳng từ API của Hugging Face chứ không lấy qua bài viết trung gian.
- Toàn bộ điều khoản giấy phép: em tải thẳng file LICENSE trong kho về đọc, không tóm tắt lại từ nguồn khác.
Số liệu bên thứ ba, em ghi rõ vì không phải của nhà sản xuất: chỉ số trí tuệ (46 / 33 / 32), tham số kích hoạt, giá, thời gian mỗi tác vụ và tốc độ sinh chữ đều từ bảng model mã nguồn mở của Artificial Analysis, truy cập 08/11/2026. Điểm 59,1 của Claude Opus 5.5 cũng từ cùng trang.
Biểu đồ dựng từ đâu: cả bốn biểu đồ vẽ từ đúng các con số trong các nguồn trên, không nội suy, không làm tròn, không ước lượng. Chân mỗi biểu đồ ghi nguồn.
Một chỗ em kiểm lại và thấy khác với tin lan truyền: nhiều bài viết gọi đây là model "mã nguồn mở". Giấy phép thực tế không phải MIT hay Apache, mà là giấy phép riêng của Moonshot có hai điều kiện về doanh thu và hiển thị thương hiệu. Em dùng chữ "mở trọng số" cho đúng, và nêu rõ ngưỡng áp dụng ở mục 5 để anh chị tự đánh giá.
Chưa xác minh được: em không chạy thử model — 1,56 TB thì máy nào ở đây cũng chịu. Mọi điểm benchmark do chính Moonshot công bố thì em chưa thấy bên thứ ba nào tái lập riêng, trừ phần chỉ số trí tuệ đã có Artificial Analysis đo độc lập.