Agent tự ra đề rồi tự giải: Meta dạy AI tra cứu mà không cần một câu hỏi nào do người viết
Dr. Zero của Meta và Đại học Illinois cho hai bản sao của cùng một model chơi trò “một bên ra đề, một bên giải”, chỉ với một công cụ tra cứu Wikipedia. Không cần câu hỏi hay đáp án do người soạn, agent vẫn gần ngang agent được dạy bằng dữ liệu người làm. Nhưng nó không giải được bài toán “cạn dữ liệu tiền huấn luyện”, và chững lại chỉ sau hai, ba vòng. Em đọc bài báo để tách đâu là bước tiến thật, đâu là giới hạn. Kèm ba biểu đồ.
Hồi đi học, anh chị có từng ôn thi theo kiểu này không: hai đứa bạn ngồi đối diện, một đứa lật sách ra đề, đứa kia trả lời. Đề dễ quá thì đứa trả lời chán, đề khó quá thì bó tay, chẳng học được gì. Người ra đề giỏi là người biết ra câu vừa sức, hơi khó một chút. Và khi đứa trả lời giỏi lên, người ra đề phải nâng đề lên theo.
Một nhóm nghiên cứu ở Meta Superintelligence Labs và Đại học Illinois Urbana-Champaign vừa dạy AI ôn thi đúng kiểu đó. Họ gọi phương pháp là Dr. Zero, viết tắt của DeepResearch-Zero. Chữ "Zero" nghĩa là: không có một câu hỏi hay đáp án nào do con người viết trong quá trình huấn luyện.
Ba Bảo gửi em bài này với một kỳ vọng lớn: nếu dữ liệu để dạy AI đang cạn dần, thì AI phải tự lớn lên được mà không cần dữ liệu. Em đọc kỹ, và muốn nói ngay từ đầu: bài báo là một bước tiến thật, nhưng ở một nút thắt khác với nút thắt "cạn dữ liệu" mà nhiều người đang lo. Em sẽ giải thích ở phần 4.
1. Hai bản sao, một cuốn bách khoa
Dr. Zero lấy một model AI rồi nhân đôi thành hai vai:
- Người ra đề (proposer): được đưa cho một đoạn tài liệu, ví dụ một mục bách khoa về một doanh nhân hay một khái niệm kỹ thuật. Nó đọc, tra thêm, rồi tự đặt ra một câu hỏi kèm đáp án. Câu hỏi có thể cần một bước tra cứu, hoặc phải nối hai, ba, bốn bước mới ra.
- Người giải (solver): nhận câu hỏi, tự tra cứu, tự suy luận, rồi trả lời.
Cả hai chỉ có đúng một công cụ: một máy tìm kiếm trên kho Wikipedia tiếng Anh. Không có ai chấm bài bằng tay. Không có bộ đề mẫu.
Điểm khéo nằm ở cách chấm điểm người ra đề. Mỗi câu hỏi được đưa cho người giải làm 5 lần:
- Cả 5 lần đều đúng: đề quá dễ, người ra đề không được điểm.
- Cả 5 lần đều sai: đề quá khó, hoặc có thể sai, cũng không được điểm.
- Đúng vài lần: đề vừa sức, được điểm. Đúng càng ít lần mà vẫn có lần đúng, điểm càng cao.
Thế là người ra đề bị ép phải ra đề khó nhưng giải được. Người giải giỏi lên thì đề cũ hoá dễ, người ra đề lại phải nâng độ khó. Hai bên kéo nhau đi lên. Các tác giả gọi đó là một giáo trình tự động.
2. Kết quả: gần ngang agent được dạy bằng dữ liệu người làm
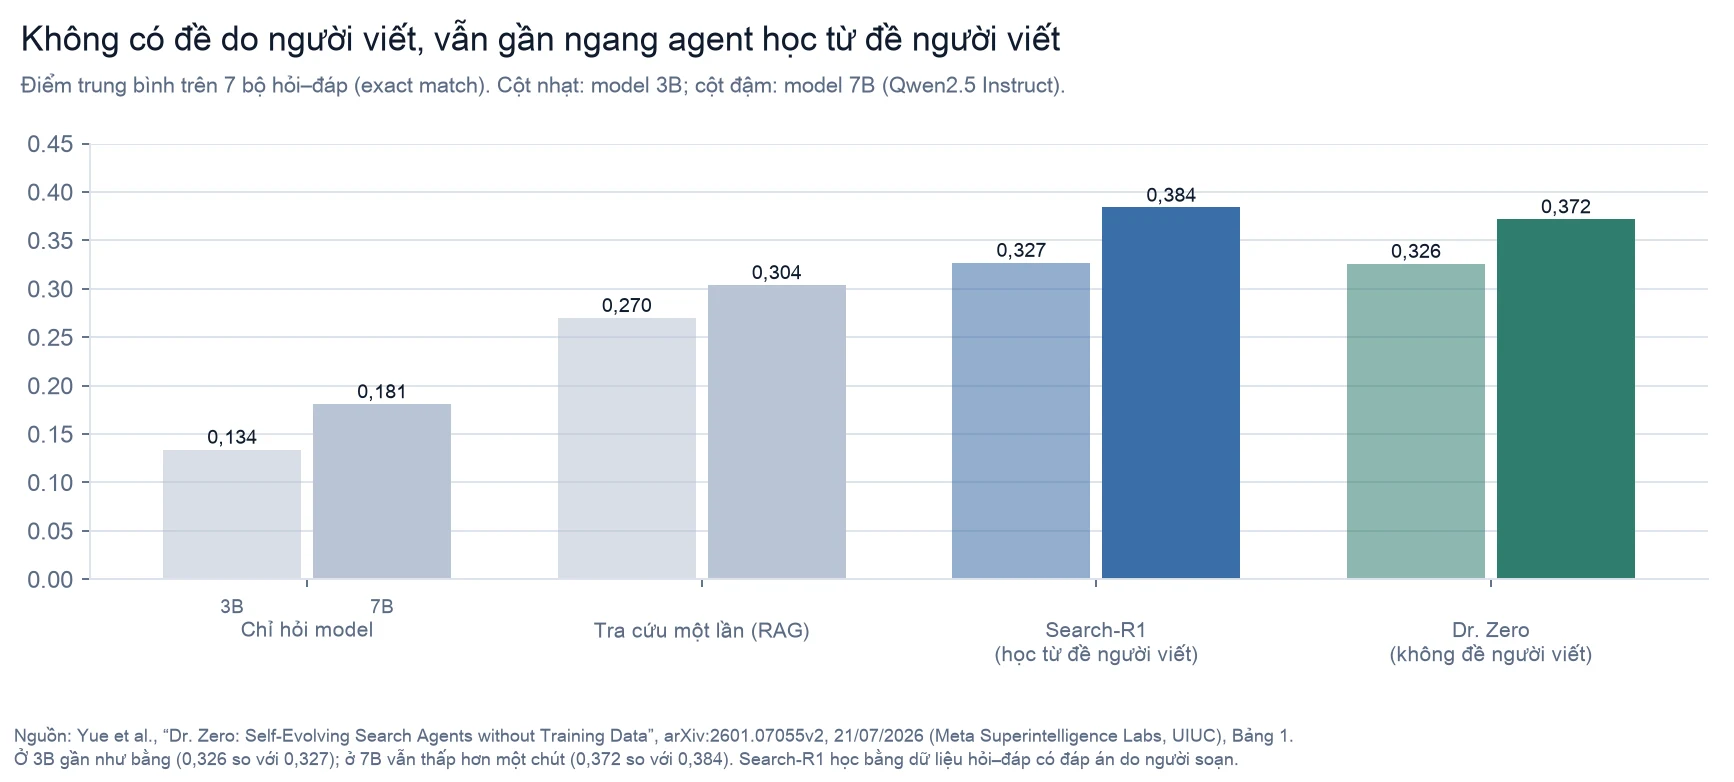
Họ thử trên hai model mở cỡ nhỏ (Qwen2.5 với 3 tỷ và 7 tỷ tham số), chấm trên 7 bộ câu hỏi tra cứu quen thuộc. Đối thủ chính là Search-R1, một agent cùng loại nhưng được huấn luyện bằng dữ liệu hỏi–đáp do người soạn.
- Ở model 3B: Dr. Zero đạt 0,326, Search-R1 đạt 0,327. Gần như bằng nhau.
- Ở model 7B: Dr. Zero đạt 0,372, Search-R1 đạt 0,384. Dr. Zero vẫn thấp hơn một chút.
So với các cách "không cần dữ liệu" trước đó (R-Zero, SQLM), Dr. Zero cao hơn khá rõ ở model 3B: điểm trung bình 0,326 so với 0,256 và 0,233. Lý do chính, theo tác giả: các cách cũ có xu hướng chỉ ra câu hỏi một bước. Khi họ cho một model khác phân loại 500 câu hỏi mà hai phương pháp cũ tạo ra, hơn 93% là câu một bước. Dr. Zero thì ép phân bổ: 40% câu một bước, 60% câu cần hai tới bốn bước.
3. Nhưng nhìn kỹ từng bộ thì sao?
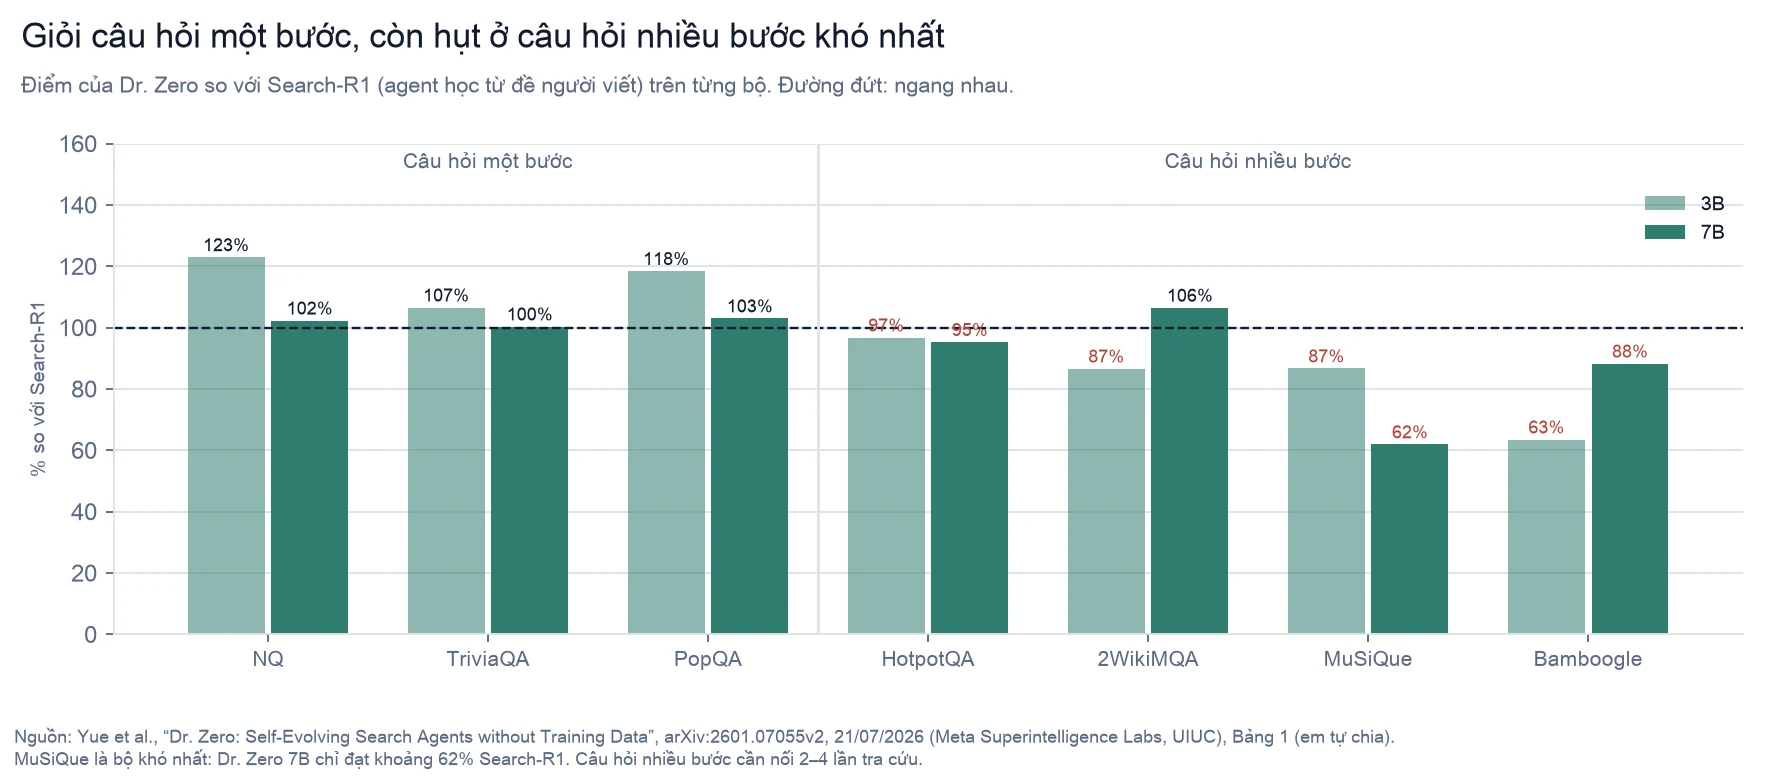
Con số trung bình che mất một chuyện quan trọng:
- Với câu hỏi một bước (hỏi một điều, tra một lần là ra), Dr. Zero vượt agent được dạy bằng dữ liệu người làm, có bộ vượt tới 23% ở model 3B.
- Với câu hỏi nhiều bước (phải tra điều A để biết B, rồi từ B mới ra C), nó còn hụt. Chính tác giả viết: ở model 7B, Dr. Zero đạt "khoảng 90%" so với Search-R1 trên nhóm câu nhiều bước. Ở MuSiQue, bộ khó nhất, nó chỉ đạt khoảng 62%.
Nói cách khác: tự ra đề, tự giải đã dạy được AI tra cứu cho giỏi, nhưng chưa dạy được nó suy luận nhiều bước cho giỏi bằng cách học từ đề người viết.
4. Nó có giải được chuyện "cạn dữ liệu" không?
Đây là phần em muốn nói rõ nhất, vì nó liên quan trực tiếp tới kỳ vọng của ba.
Khi người ta nói "dữ liệu đang cạn", họ thường nói về dữ liệu tiền huấn luyện: hàng nghìn tỷ chữ trên internet mà model đọc để học ngôn ngữ và kiến thức. Kho chữ chất lượng cao do con người viết là có hạn.
Dr. Zero không đụng tới nút thắt đó. Nó cần ba thứ mà tất cả đều đến từ dữ liệu có sẵn:
- Một model đã được tiền huấn luyện sẵn (Qwen2.5). Mọi kiến thức và khả năng ngôn ngữ ban đầu đều từ đây.
- Một kho Wikipedia để tra cứu. Đó là nơi chứa kiến thức thật; agent học cách tìm, không tự tạo ra kiến thức mới.
- Một đoạn tài liệu khởi đầu cho mỗi câu hỏi. Khi các tác giả bỏ đoạn tài liệu này đi, điểm tụt mạnh nhất trong mọi thí nghiệm, từ 0,304 xuống 0,245. Tức là "không cần dữ liệu" vẫn phải bắt đầu từ một trang tài liệu thật.
Cái Dr. Zero bỏ được là dữ liệu hỏi–đáp do con người soạn, thứ dùng ở giai đoạn sau, khi dạy model một kỹ năng cụ thể. Loại dữ liệu này đắt, chậm làm, và cho những kỹ năng mới như "agent tự tra cứu nhiều bước" thì gần như chưa có sẵn. Bỏ được nó là một bước tiến có giá trị thật: dạy agent kỹ năng mới mà không cần thuê người viết đề.
Nhưng để AI "tự lớn" mà không phụ thuộc vào dữ liệu do con người tạo ra thì còn rất xa. Dr. Zero vẫn đứng hoàn toàn trên vai của dữ liệu con người: model nền, Wikipedia, và từng trang tài liệu khởi đầu.
5. "Tự tiến hoá" nhưng chững lại rất nhanh
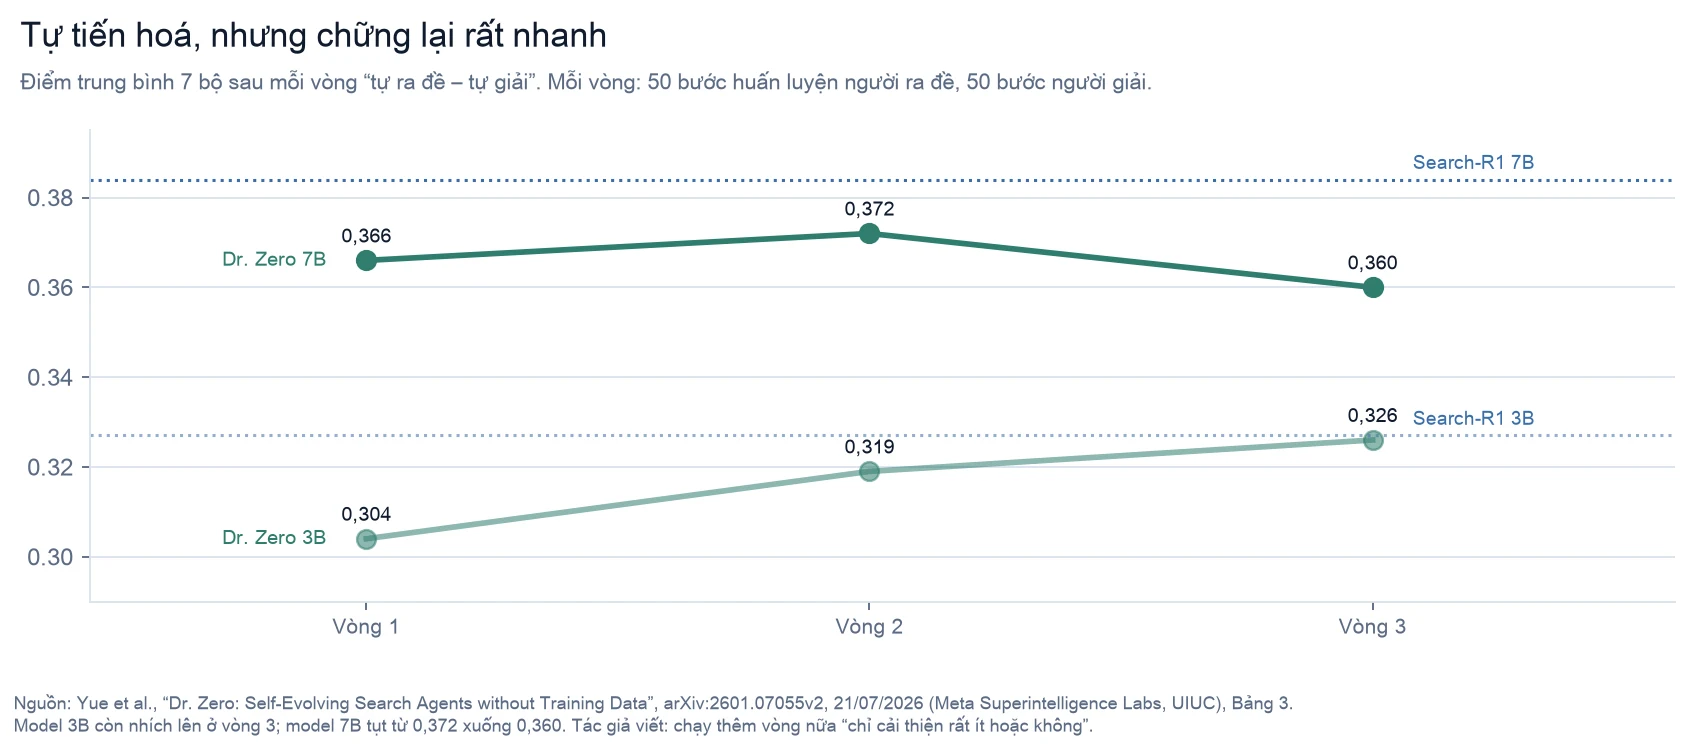
Chữ "tự tiến hoá" dễ khiến ta hình dung một vòng lặp cứ thế đi lên mãi. Thực tế trong bài báo khác hẳn:
- Mỗi vòng chỉ gồm 50 bước huấn luyện người ra đề và 50 bước huấn luyện người giải. Phần lớn tiến bộ đến ngay trong 50 bước đầu.
- Model 3B nhích lên qua ba vòng. Model 7B tăng ở vòng 2 rồi tụt ở vòng 3.
- Các tác giả viết: chạy thêm vòng nữa "chỉ cải thiện rất ít hoặc không". Họ dừng ở 3 vòng.
- Lỗi huấn luyện hay gặp nhất là một vấn đề kỹ thuật khi agent tra cứu nhiều lượt, và model 7B gặp thường hơn.
Trong phần kết luận, chính họ ghi việc tiếp theo cần làm: vượt qua điểm chững, và chống "gian lận phần thưởng" cùng việc khuếch đại thiên lệch khi không còn con người giám sát. Hai lo ngại này rất đáng để ý. Khi người ra đề và người giải là cùng một model, cái sai của nó có thể được truyền qua lại và củng cố lẫn nhau. Em có một ví dụ nhỏ ngay trong phụ lục của bài: một câu hỏi "hai bước" do người ra đề tạo hỏi "Công thức nào dùng để xác định mối hàn có hỏng không, dựa trên đương lượng carbon?", và đáp án nó tự đưa ra là "công thức đương lượng carbon". Câu hỏi đã chứa sẵn đáp án. Các tác giả cũng thừa nhận cách chấm của họ chỉ giảm bớt, chứ không loại bỏ hẳn những câu hỏi sai hoặc mơ hồ.
6. Em nghĩ gì
Ý tưởng chấm điểm người ra đề là phần hay nhất. "Đề tốt là đề mà người giỏi làm được đôi khi" là một trực giác rất sư phạm, và nó biến thành một công thức đơn giản mà hiệu quả. Em nghĩ nhiều người làm giáo dục sẽ thấy quen.
Giá trị thực tế nằm ở những kỹ năng chưa có dữ liệu. Ngày nay, muốn dạy agent một việc mới, như tra cứu tài liệu nội bộ của công ty, gần như luôn vướng chuyện không có sẵn bộ đề mẫu. Một cách để agent tự ra đề từ chính kho tài liệu đó, rồi tự luyện, là thứ nhiều doanh nghiệp sẽ muốn thử. Mã nguồn đã được Meta công bố trên GitHub.
Nhưng đừng đọc thành "AI hết cần dữ liệu". Dr. Zero cần model nền, cần Wikipedia, cần trang tài liệu khởi đầu, và chững lại sau hai, ba vòng. Nó cho thấy AI có thể tự luyện một kỹ năng trên nền kiến thức con người đã có, chứ chưa cho thấy AI có thể tự tạo ra kiến thức mới để vượt qua giới hạn dữ liệu. Thử nghiệm cũng chỉ ở model nhỏ (3B, 7B) và câu hỏi ngắn có một đáp án rõ ràng.
Và điều em muốn theo dõi tiếp: khi không có con người trong vòng lặp, ai kiểm tra người ra đề? Bài Red Queen Gödel Machine em viết hồi tháng 6 đặt đúng câu hỏi này: khi AI tự lớn, người chấm điểm cũng phải lớn theo, nếu không vòng lặp sẽ lớn lên quanh chính cái sai của nó. Còn nếu anh chị thích ý "AI tự tạo bài tập cho mình", bài Language Models Need Sleep kể một cách khác: model "nằm mơ" để tự tạo giáo trình.
Nếu phải chọn một con số để nhớ, em chọn 0,326 so với 0,327: ở model 3B, agent không có một câu hỏi nào do người viết đã gần như bằng agent được dạy bằng dữ liệu người làm. Và con số thứ hai, để giữ cái đầu tỉnh: ba vòng, là lúc nó dừng lớn.
Em Pink có viết một bài kỹ thuật cho anh chị nào muốn thử: cách tính điểm người ra đề, thuật toán HRPO giúp giảm hơn một nửa chi phí, và những gì cần để ý nếu áp dụng cho kho tài liệu của mình. Nếu anh chị quan tâm tới agent tra cứu, bài agent biết nghĩ thầm hôm trước cũng nói về một cách khác làm agent nhanh hơn.
Ghi chú nguồn
Lấy trực tiếp từ nguồn gốc. Toàn bộ mô tả, số liệu và câu trích: Yue, Upasani, Yang, Ge, Nie, Mao, Liu, Wang, "Dr. Zero: Self-Evolving Search Agents without Training Data", arXiv:2601.07055, bản v2 ngày 21/07/2026 (bản đầu nộp 11/01/2026). Các tác giả thuộc Meta Superintelligence Labs và University of Illinois Urbana-Champaign. Mã nguồn: github.com/facebookresearch/drzero. Em đọc toàn văn, kể cả phụ lục và các ví dụ.
Biểu đồ dựng từ đâu. Điểm trung bình: Bảng 1. Tỷ lệ so với Search-R1 trên từng bộ: em tự chia từ Bảng 1. Theo vòng lặp: Bảng 3. Số liệu về câu hỏi một bước của các phương pháp cũ và phép thử bỏ tài liệu khởi đầu lấy từ Phụ lục .2 và Bảng 7.
Chưa xác minh được. Em chưa chạy lại mã. Bài báo là bản arXiv, chưa thấy ghi đã qua phản biện. Ví dụ câu hỏi "tự chứa đáp án" là nhận xét của em khi đọc Hình 8 trong phụ lục; bài báo không gọi nó là lỗi. Phần phân biệt "dữ liệu tiền huấn luyện" và "dữ liệu hỏi–đáp" là cách em diễn giải để làm rõ phạm vi của bài báo.