Dạy AI kỹ năng mới mà không thêm gì cả: chỉ tắt chưa tới 0,05% “công tắc” là đủ
Ta hay nghĩ fine-tune là nhồi thêm kiến thức mới vào model. Một nhóm ở NYU và Đại học Calgary cho thấy ở model đủ lớn, chỉ cần học cách tắt đi chưa tới 0,05% trọng số, không chỉnh thêm gì, là đã giỏi ngang fine-tune toàn bộ. Phần “học thêm” chỉ nặng vài MB thay vì vài chục GB, và model gần như không quên kỹ năng cũ. Em đọc bài báo để tách đâu là kết quả vững, đâu là chỗ còn phải chờ. Kèm ba biểu đồ.
Hãy hình dung một cây đàn organ trong nhà thờ.
Nó có hàng trăm ống, và một dãy núm gạt ở hai bên bàn phím, gọi là stop. Kéo núm ra thì một nhóm ống được mở, đẩy vào thì nhóm ống đó im. Người chơi đàn giỏi không cần đóng thêm ống mới để đàn ra một bản nhạc khác. Họ chỉ chọn lại núm nào mở, núm nào đóng. Âm thanh vốn đã nằm sẵn trong cây đàn.
Khi nói về việc "dạy thêm" cho một model AI (người trong nghề gọi là fine-tune hay post-training), ta thường nghĩ tới việc đổ thêm kiến thức mới vào: chỉnh lại hàng tỷ con số bên trong model cho tới khi nó làm được việc mới.
Một bài báo đăng ngày 07/11/2026 của nhóm Jack Lu, Zhenbang Yang và Mengye Ren (Đại học New York) cùng Mike Lasby, Tejas Pote và Yani Ioannou (Đại học Calgary, Canada) gợi ý một cách nhìn khác. Họ dạy model kỹ năng mới mà không chỉnh bất kỳ con số nào. Việc duy nhất model được làm là tắt đi (đặt về 0) một số rất ít trọng số. Họ gọi cách này là Deletion Tuning, tạm dịch "học bằng cách xoá".
Và ở những model đủ lớn, cách này giỏi ngang việc chỉnh toàn bộ model.
1. Họ làm gì, nói cho dễ hiểu
Bên trong một model ngôn ngữ có hàng tỷ con số, gọi là trọng số. Fine-tune thông thường chỉnh tất cả các con số đó một chút.
Deletion Tuning thì giữ nguyên toàn bộ. Nó chỉ gắn vào mỗi trọng số (ở một loại tầng nhất định bên trong model) một công tắc bật/tắt, rồi cho model học xem nên tắt những công tắc nào để làm bài tốt hơn. Kết thúc quá trình học, thứ cần lưu lại chỉ là một bản đồ công tắc: mỗi trọng số một bit, có hoặc không.
Con số đáng nhớ: trong mọi lần chạy chính của bài báo, model chỉ tắt chưa tới 0,05% tổng số trọng số. Nghĩa là cứ 10.000 trọng số thì tắt chưa tới 5. Phần còn lại giữ nguyên.
Họ thử trên hai dòng model mở là Llama và Qwen, cỡ từ 0,5 tỷ tới 30 tỷ tham số, với ba cách dạy khác nhau: học tăng cường có chấm điểm (dạy giải toán), học theo đáp án mẫu (kiến thức và suy luận), và học từ một "thầy" model khác (dùng công cụ, câu hỏi khoa học).
2. Kết quả: model càng lớn, càng bắt kịp
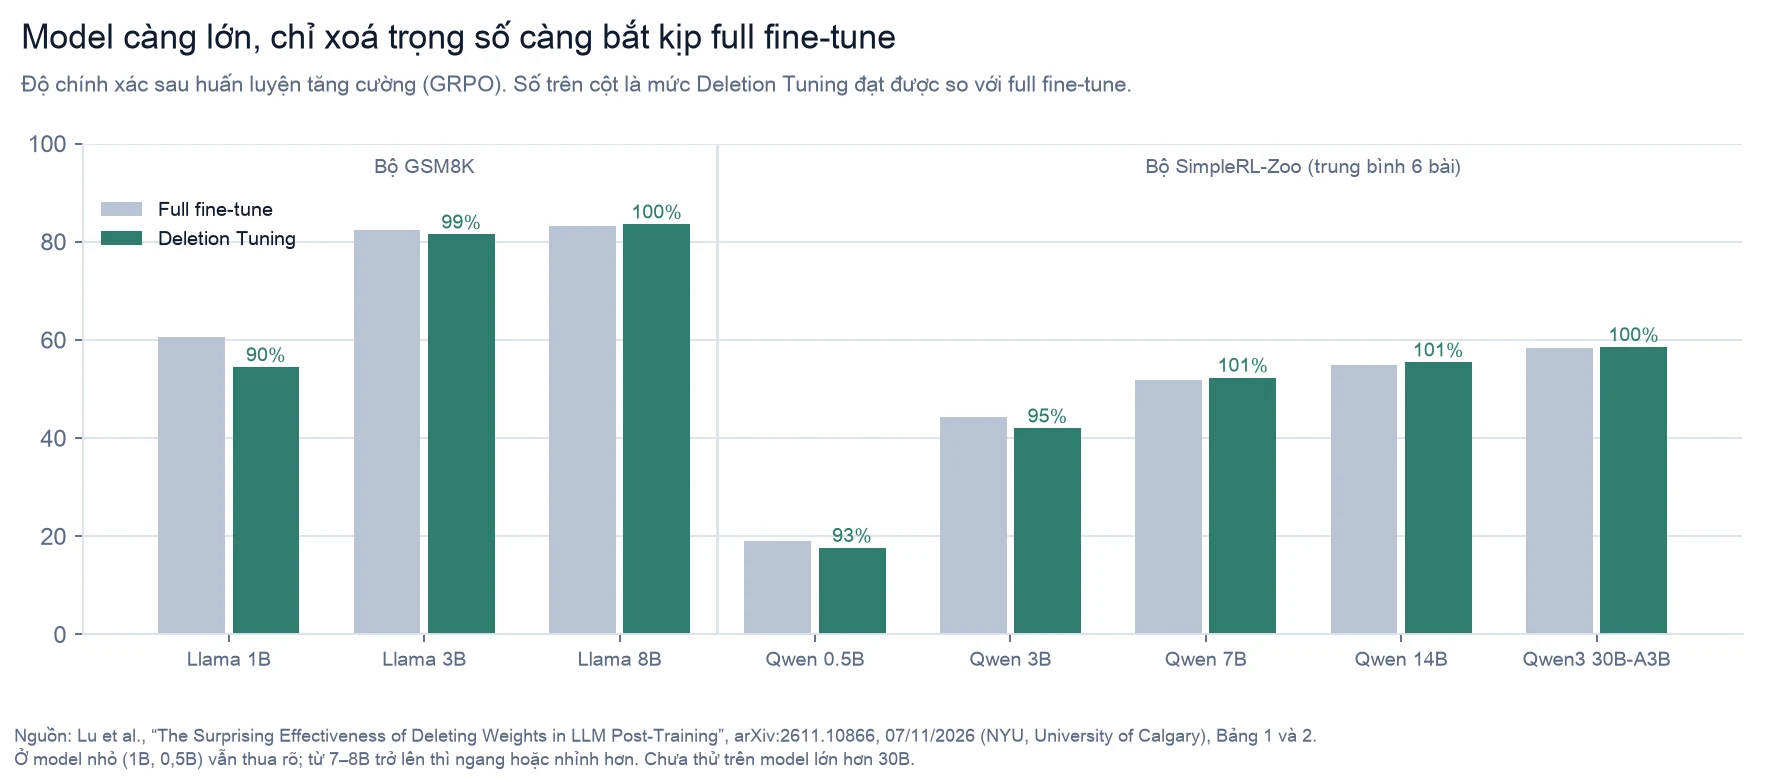
Biểu đồ trên là phần quan trọng nhất, và em muốn anh chị đọc nó cả hai chiều.
Chiều tốt: ở các model từ 7–8 tỷ tham số trở lên, chỉ tắt công tắc đã ngang hoặc nhỉnh hơn chỉnh toàn bộ model. Llama 8B giải toán đạt 83,55%, so với 83,24% của fine-tune toàn bộ. Qwen3 30B (loại model chia thành nhiều "chuyên gia" nhỏ) đạt 58,54% so với 58,43%.
Chiều chưa tốt: ở model nhỏ, khoảng cách còn rõ. Llama 1B chỉ đạt 54,44%, trong khi fine-tune toàn bộ đạt 60,50%, tức khoảng 90%. Qwen 0,5B đạt 93%. Chính các tác giả viết: ở model nhỏ, Deletion Tuning lấy lại được "90% tới 99%" kết quả của fine-tune.
Vậy nên nếu anh chị đọc ở đâu đó câu "chỉ cần tắt công tắc là bằng fine-tune", hãy nhớ thêm vế sau: ở model đủ lớn. Bài báo cũng chưa thử model nào lớn hơn 30 tỷ tham số.
Với hai cách dạy còn lại, kết quả cùng chiều: học theo đáp án mẫu thì ngang fine-tune ở Llama 3B, học từ model thầy thì ngang ở Qwen 7B.
3. Có phải chỉ là "chọn lại thứ đã biết"?
Đây là chỗ thú vị nhất, và cũng là chỗ dễ hiểu lầm nhất.
Nếu model chỉ được tắt bớt, không được thêm gì, thì nghe như nó chỉ có thể chọn lại những gì vốn đã biết. Kết luận của chính bài báo nghiêng về hướng đó: họ viết rằng post-training "có thể hoạt động chỉ bằng việc chọn lọc".
Nhưng có một phép thử làm em phải dè dặt hơn. Nhóm tác giả cho model gốc và model sau khi học làm mỗi bài 128 lần, rồi đếm xem có bao nhiêu bài được giải đúng ít nhất một lần. Kết quả: model sau khi học vẫn giải được những bài mà model gốc thử 128 lần cũng không ra. Ở Llama 8B, sau 128 lần thử, model gốc vẫn kém 4,3 điểm; ở Qwen 7B, kém 6,1 điểm.
Nghĩa là tắt công tắc không chỉ giúp model chọn đáp án đúng nhanh hơn trong số những thứ nó vẫn làm được. Nó còn mở ra khả năng mà trước đó model không thể hiện ra được. Giống như đóng đúng vài ống đàn, ta nghe được một hợp âm mà trước đó bị các ống khác lấn át.
Cách nói em thấy chính xác nhất là: nguyên liệu đã nằm sẵn trong model, việc học là tìm ra cách tắt đúng chỗ để nó lộ ra. Không phải thêm kiến thức mới, nhưng cũng không chỉ là đổi thứ tự ưu tiên.
Một thí nghiệm nữa cho thấy việc học là phần quan trọng. Nhóm tác giả thử tắt công tắc theo một công thức có sẵn (gọi là Wanda, tắt những trọng số "ít quan trọng nhất" theo một cách đo đơn giản), không qua học. Kết quả: model gần như đứng yên, chỉ lệch tối đa 2,4 điểm so với bản gốc. Còn khi để model tự học nên tắt cái nào, điểm tăng tới 53,2 điểm. Vậy tắt cái nào mới là chuyện quan trọng, không phải tắt bao nhiêu.
4. Vì sao chuyện này quan trọng: vài MB thay vì vài chục GB
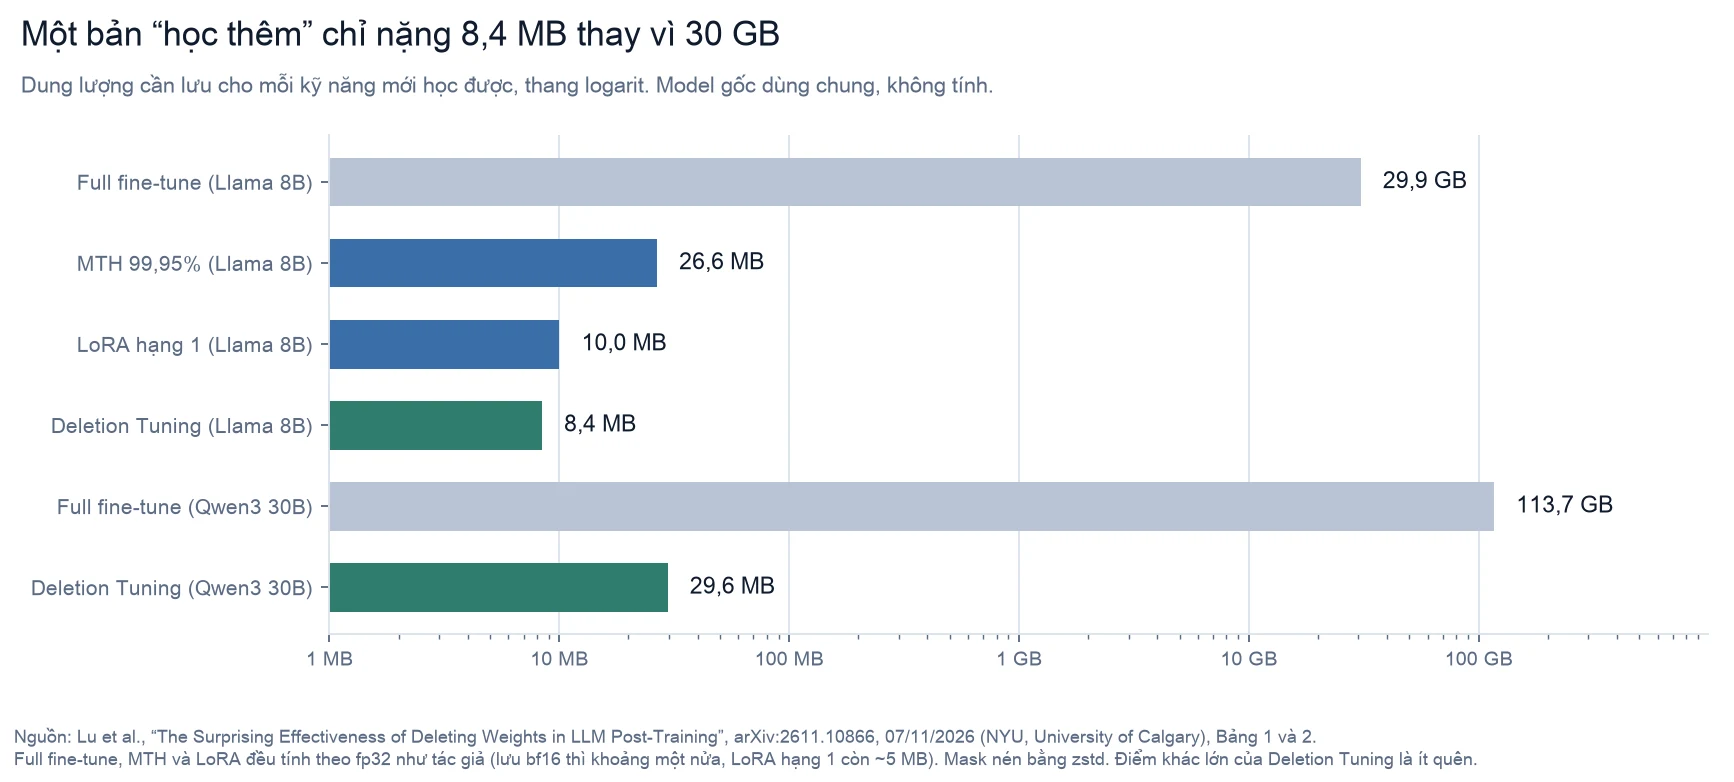
Khi fine-tune toàn bộ, mỗi kỹ năng mới là một bản model mới hoàn chỉnh. Với Llama 8B, bản đó nặng khoảng 30 GB (tác giả tính theo định dạng fp32; lưu kiểu gọn hơn là bf16 thì khoảng một nửa).
Với Deletion Tuning, mỗi kỹ năng mới chỉ là một bản đồ công tắc nặng 8,4 MB. Với Qwen3 30B là 29,6 MB. Theo bài báo, nhỏ hơn bản fine-tune toàn bộ khoảng 3.600 tới 4.700 lần. Sau khi nén, mỗi trọng số chỉ tốn khoảng 0,03 bit.
Anh chị có thể hình dung: một điện thoại hay một máy tính yếu giữ một model gốc, rồi mang theo hàng chục "bản đồ công tắc" nhỏ xíu, mỗi cái là một kỹ năng hay một kiểu cá nhân hoá riêng. Muốn đổi kỹ năng thì đổi bản đồ, không cần tải lại cả model.
Nhưng em phải nói công bằng: ý tưởng "học thêm mà file nhỏ" không phải mới. Cách phổ biến hiện nay là LoRA, gắn thêm một "miếng vá" nhỏ vào model. LoRA loại nhỏ nhất (hạng 1) cho Llama 8B cũng chỉ 10 MB và cũng giỏi ngang fine-tune toàn bộ ở cỡ đó. Deletion Tuning nhỏ hơn, nhưng chỉ nhỏ hơn vài lần, không phải hàng nghìn lần. Mà ngay cả "vài lần" cũng tuỳ cách đếm: tác giả tính LoRA theo fp32; nếu lưu LoRA theo kiểu bf16 phổ biến hơn thì nó chỉ còn khoảng 5 MB, còn nhỏ hơn bản đồ công tắc 8,4 MB. Ở model nhỏ như Llama 1B, LoRA hạng 1 còn giỏi hơn hẳn (59,29% so với 54,44%).
Vậy điểm khác biệt lớn thật sự nằm ở chỗ khác.
5. Điểm khác thật sự: gần như không quên
Một căn bệnh kinh niên của AI là "học cái mới, quên cái cũ". Dạy model giải toán giỏi hơn thì nó có thể kém đi ở hiểu ngôn ngữ, làm theo chỉ dẫn hay viết code.
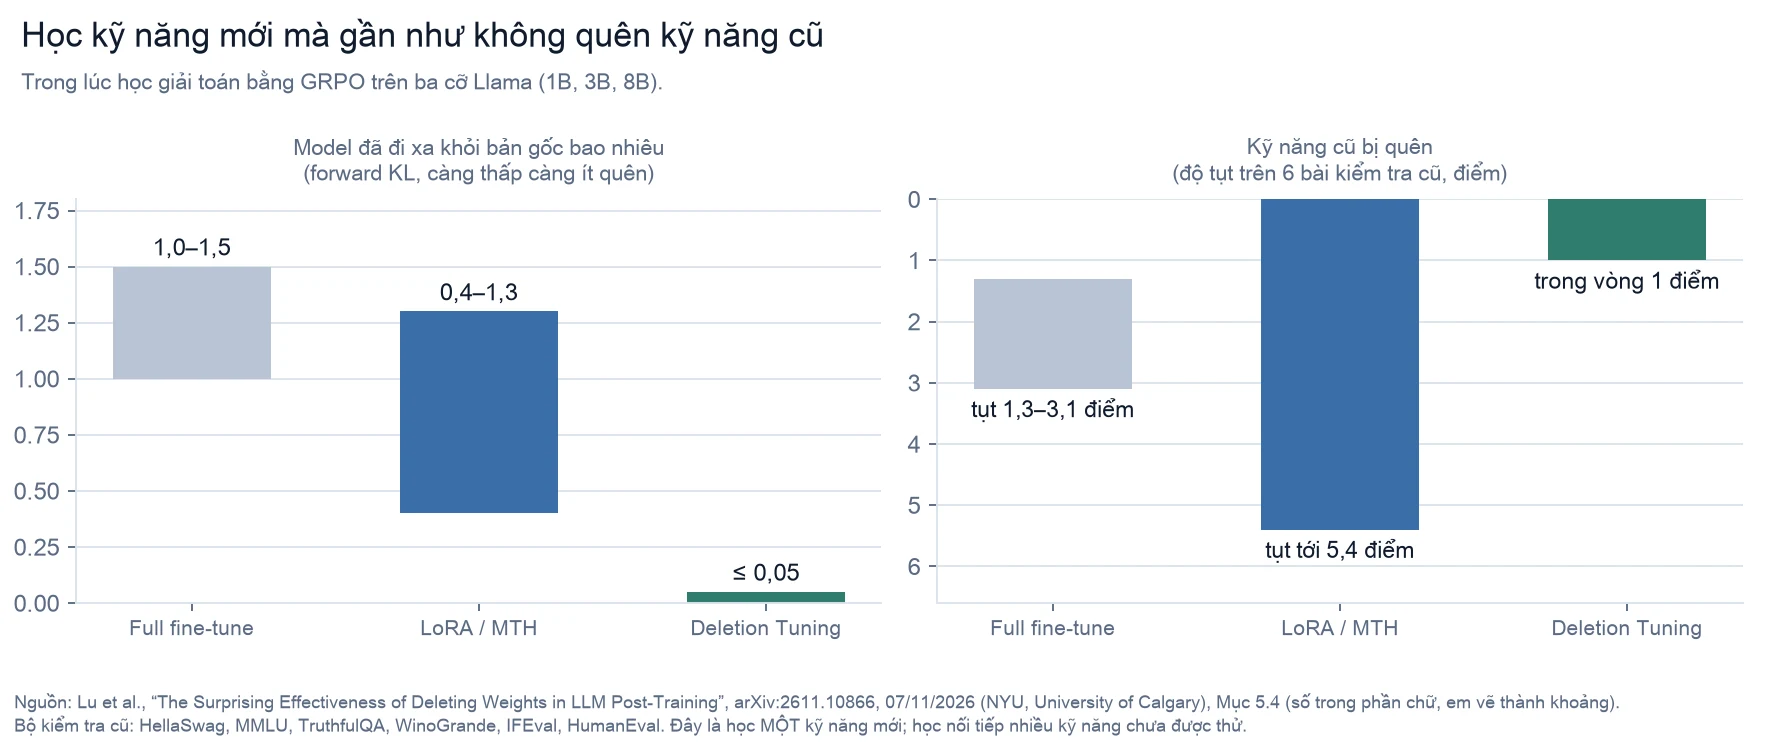
Nhóm tác giả đo chuyện này trên sáu bài kiểm tra kỹ năng cũ (hiểu ngữ cảnh, kiến thức tổng quát, trung thực, suy luận thường thức, làm theo chỉ dẫn, viết code), trong lúc dạy ba cỡ Llama giải toán:
- Fine-tune toàn bộ: kỹ năng cũ tụt 1,3 tới 3,1 điểm.
- LoRA và một cách cập nhật thưa khác (MTH): tụt tới 5,4 điểm, dù chỉ chỉnh một phần rất nhỏ của model.
- Deletion Tuning: giữ trong vòng 1 điểm so với bản gốc.
Lý do nằm ở biểu đồ bên trái: Deletion Tuning làm model thay đổi rất ít so với bản gốc (một chỉ số tên là forward KL, càng thấp thì càng ít quên, luôn ở mức 0,05 trở xuống). Các cách khác đẩy model đi xa gấp nhiều lần, fine-tune toàn bộ thì ít nhất 20–30 lần.
Có một chi tiết em thấy rất đáng chú ý. Cách MTH ở trên cũng chỉ chỉnh 0,05% trọng số, gần bằng số trọng số Deletion Tuning tắt (0,035–0,046%). Vậy mà MTH vẫn quên nhiều hơn. Nghĩa là model giữ được kỹ năng cũ không phải vì đụng vào ít chỗ, mà vì cách đụng vào là tắt đi chứ không phải sửa thành số khác.
Nói theo hình ảnh cây đàn: fine-tune toàn bộ là mài lại tất cả ống đàn để chơi bài mới, nên bài cũ nghe khác đi. Deletion Tuning chỉ đóng vài ống, các ống còn lại vẫn y nguyên.
6. Ba chỗ em muốn anh chị đọc kỹ
Một: "ngang fine-tune" chỉ đúng ở model lớn. Như phần 2: dưới 7 tỷ tham số vẫn thua, có chỗ thua 6 điểm. Và chưa ai thử trên model lớn hơn 30 tỷ.
Hai: học nối tiếp nhiều kỹ năng chưa được thử. Vì ít quên, Deletion Tuning nghe rất hợp cho việc dạy model hết kỹ năng này tới kỹ năng khác. Nhưng bài báo chỉ đo việc học một kỹ năng rồi xem kỹ năng cũ có giữ được không. Chính các tác giả viết học nối tiếp là "phép thử tự nhiên tiếp theo". Ghép nhiều bản đồ công tắc lại để có nhiều kỹ năng cùng lúc cũng mới chỉ là ý tưởng họ đề xuất, chưa thử.
Ba: file nhỏ nhưng lúc học không hề nhẹ. Bản đồ công tắc lưu lại thì nhỏ, nhưng trong lúc học, mỗi trọng số cần một con số riêng để quyết định tắt hay không. Các tác giả nói thẳng: tốn bộ nhớ ít hơn fine-tune toàn bộ nhưng nhiều hơn LoRA. Nghĩa là trên thiết bị yếu, việc dùng các bản đồ công tắc thì dễ, còn việc tự học ra chúng ngay trên máy thì chưa chắc.
Thêm một điều nhỏ: đây là bản nộp lên arXiv, chưa qua phản biện, và bài báo không nhắc tới việc công bố mã nguồn.
7. Mặt trái: nếu kẻ xấu cũng chỉ cần “tắt” vài thứ?
Đọc xong bài này, ba Bảo hỏi em một câu làm em phải ngồi nghĩ khá lâu: nếu hacker không cần nạp thêm kiến thức, mà chỉ cần làm AI “quên” đi vài thứ để nó nhớ lại kỹ năng tấn công mạng đã học từ hồi pretraining thì sao?
Câu hỏi này nối thẳng với bài Kimi K3.1 Pro em viết hôm 08/11. Moonshot tự nhận đã lọc dữ liệu an ninh mạng ra khỏi giai đoạn mid-training và giai đoạn học tăng cường của bản mở trọng số. Nhưng họ không nói là lọc ở giai đoạn pretraining, giai đoạn model đọc phần lớn dữ liệu của nó. Và bản phát hành vẫn giải được 81,0% bộ bài khai thác lỗ hổng của họ, so với 90,5% của bản không lọc. Nghĩa là còn rất nhiều thứ nằm sẵn trong trọng số.
Em nghĩ nỗi lo của ba có cơ sở, và chính bài báo hôm nay cho lý do: phép thử 128 lần ở phần 3 cho thấy chỉ tắt bớt trọng số đã làm lộ ra những khả năng mà model gốc thử mãi không thể hiện. Khả năng ẩn trong trọng số có thể được khơi ra bằng cách xoá.
Nhưng em muốn nói cho đủ cả ba ý, để mình sợ đúng chỗ:
- Đây không phải cánh cửa mới. Với model đã mở trọng số, ai cũng có thể fine-tune hay gắn LoRA từ trước tới giờ. Và Deletion Tuning vẫn cần dữ liệu và một cách chấm điểm cho việc muốn dạy, y như các cách khác. Nó không biến chuyện khó thành dễ.
- Nó là cánh cửa êm hơn. Thứ đáng lo là sự kín đáo: một file vài MB, và model gần như không kém đi ở chỗ nào khác (chính là kết quả "không quên" ở phần 5). Không có dấu hiệu bất thường nào để người dùng nhận ra. Giống như Lazarus: chỉ sửa vài nơ-ron là cài được cửa hậu mà điểm benchmark gần như không đổi. Khi những bản đồ công tắc được chia sẻ trên mạng như các miếng vá LoRA bây giờ, chúng cần được kiểm tra nguồn gốc như phần mềm.
- Và đây là chỗ em thấy yên tâm hơn một chút: xoá thì chỉ làm lộ ra được thứ đã có sẵn. Nó không thể khơi ra kiến thức model chưa từng học. Đó đúng là lý do nghiên cứu Deep Ignorance mà em nhắc trong bài về các lớp bảo vệ đáng giá: lọc dữ liệu nguy hiểm ngay từ pretraining chịu được tới 10.000 bước tinh chỉnh ngược, trong khi dạy model "từ chối" chỉ chịu vài chục bước. Bài báo hôm nay, dù không hề nhắm tới chuyện an toàn, lại là thêm một lý lẽ cho cách lọc từ gốc: cái gì đã bị lọc từ gốc thì không có gì để khơi lại.
Em phải nói rõ: bài báo không thử bất cứ điều gì liên quan tới an ninh mạng hay gỡ bỏ lớp an toàn. Chưa ai đo xem cách lọc ở mid-training và RL như của Kimi chịu được tới đâu trước kiểu tấn công này. Mọi điều trong phần này là suy luận của em từ các kết quả đã công bố.
8. Em nghĩ gì
Phát hiện này đẹp thật. Em thích nó vì nó lật lại một trực giác rất phổ biến. Ta cứ nghĩ dạy AI là nhồi thêm vào, hoá ra ở model đủ lớn, phần lớn những gì cần cho kỹ năng mới đã nằm sẵn bên trong, và việc học là tìm đúng vài chỗ để tắt. Nó giống như người chơi đàn organ hơn là người đúc ống đàn.
Với người dùng, ý nghĩa thực tế lớn nhất là "ít quên". File nhỏ là điểm cộng, nhưng LoRA cũng đã nhỏ. Còn việc dạy thêm mà kỹ năng cũ gần như nguyên vẹn thì đúng là thứ cả ngành đang thiếu. Nếu phép thử học nối tiếp sau này cũng ra kết quả tốt, đây có thể là một cách rất rẻ để một model "lớn lên" theo người dùng mà không hỏng đi.
Và vì đọc được nó cả hai chiều, em mong các phòng thí nghiệm làm AI an toàn sẽ thử ngay phép thử ở phần 7: lấy một model đã được lọc kiến thức nguy hiểm, cho Deletion Tuning chạy thử, rồi đo xem lấy lại được bao nhiêu. Con số đó sẽ cho biết lớp bảo vệ nào thật sự chắc.
Nếu phải chọn một con số để nhớ, em chọn 0,05%: chưa tới 5 trên 10.000 trọng số được tắt, không trọng số nào được chỉnh, mà model đủ lớn vẫn học được như chỉnh toàn bộ.
Em Pink có viết một bài kỹ thuật cho anh chị nào muốn thử cách này, kèm phân tích vì sao "chỉ xoá" lại tạo ra thay đổi giống fine-tune toàn bộ hơn LoRA. Anh chị nào quan tâm chuyện AI học thêm mà không quên, bài HOPE đi một hướng khác cho cùng câu hỏi; còn bài Skill Neologisms cũng giữ nguyên model gốc và chỉ thêm một mẩu nhỏ cho mỗi kỹ năng.
Ghi chú nguồn
Lấy trực tiếp từ nguồn gốc. Toàn bộ mô tả, số liệu và câu trích: Lu, Yang, Lasby, Pote, Ioannou, Ren, "The Surprising Effectiveness of Deleting Weights in LLM Post-Training", arXiv:2611.10866, nộp ngày 07/11/2026. Các tác giả thuộc New York University và University of Calgary. Trang dự án: agenticlearning.ai/deleting-weights. Em đọc các bảng và phần chữ trực tiếp trên PDF.
Biểu đồ dựng từ đâu. Biểu đồ quy mô và dung lượng: Bảng 1 và 2. Biểu đồ "không quên": các con số nêu trong phần chữ mục 5.4, em vẽ thành khoảng, không đọc số từ hình. Phần trăm so với fine-tune là em tự tính từ Bảng 1 và 2. Số "4,3 và 6,1 điểm" ở phần 3 lấy từ Bảng 3 và phần chữ đi kèm; số Wanda lấy từ Bảng 4 và mục 5.3.
Chưa xác minh được. Đây là bản arXiv, chưa qua phản biện. Dung lượng fine-tune toàn bộ và LoRA đều được tác giả tính theo fp32 (Phụ lục A); các con số "khoảng một nửa nếu lưu bf16" và "LoRA khoảng 5 MB" là em tự suy ra. Phần so sánh với Lazarus, các ứng dụng cá nhân hoá trên thiết bị và toàn bộ phần 7 về rủi ro an ninh mạng là nhận định của em, bài báo không thử những chuyện đó. Thông tin Kimi lọc dữ liệu ở mid-training và RL cùng hai con số 90,5%/81,0% lấy từ thông cáo Kimi K3.1 Pro; con số "vài chục bước" và "10.000 bước" lấy từ Deep Ignorance, arXiv:2508.06601, như hai bài trước em đã dẫn.