Agent biết nghĩ thầm trong đầu và chỉ nói ra khi cần: nhanh gấp đôi, ít bước hơn một nửa
Agent AI ngày nay phải “nghĩ thành tiếng” từng bước bằng chữ, nên chậm và tốn kém. Nhóm nghiên cứu ở Stanford, Together AI, UIUC và Meta dạy agent tự chuyển qua lại giữa nghĩ thầm (nhanh, nội bộ) và nói ra bằng chữ (gọi công cụ, để người khác kiểm tra) ngay trong một lần trả lời. Kết quả: ít bước hơn 35–54%, thời gian chờ giảm từ 134 xuống 63 giây. Em đọc bài báo để tách đâu là kết quả vững, đâu là con số cần đọc kỹ, và chuyện gì xảy ra với việc giám sát AI khi nó nghĩ thầm. Kèm ba biểu đồ.
Hãy hình dung một người phiên dịch ở hội nghị.
Cô ấy không đọc to từng ý nghĩ: "người nói vừa dùng một thành ngữ, mình cần tìm từ tương đương, chắc là từ này, à không, từ kia hợp hơn…". Tất cả diễn ra trong đầu, rất nhanh. Thứ cô ấy nói ra micro chỉ là câu dịch cuối cùng. Và khi gặp một con số hay một cái tên không chắc, cô ấy ghi ra giấy hoặc hỏi lại, để người khác nhìn thấy được.
Agent AI ngày nay thì không làm được như vậy. Mỗi bước suy nghĩ đều phải viết ra thành chữ, từng chữ một, trước khi được làm gì tiếp. Viết càng dài thì càng chậm, càng tốn tiền.
Một bài báo mới, đăng ngày 13/10/2026, của nhóm tác giả ở Stanford, Together AI, UIUC và Meta, dạy agent làm đúng như người phiên dịch: nghĩ thầm khi chỉ cần nghĩ, nói ra bằng chữ khi cần hành động hoặc cần người khác kiểm tra, và chuyển qua lại giữa hai chế độ ngay trong một lần trả lời. Họ gọi nó là HybridAgent.
1. Hai cách nghĩ, mỗi cách thiếu một thứ
Nghĩ bằng chữ là cách mọi agent đang làm. Lợi ích: gọi được công cụ (tra web, chạy code), và người ta đọc được model đang nghĩ gì. Nhược điểm: phải "viết ra từng bước trung gian" thành chữ, rất tốn.
Nghĩ "thầm" (các nhà nghiên cứu gọi là suy luận trong không gian ẩn, latent reasoning) là cho model suy nghĩ bằng chính những tín hiệu số bên trong nó, không cần đổi ra chữ. Em từng kể về hướng này trong bài LOTUS: Khi AI suy luận trong im lặng nhanh hơn 6,9 lần. Nó nhanh hơn nhiều. Nhưng có hai cái thiếu: không gọi được công cụ, và không ai đọc được nó đang nghĩ gì.
HybridAgent ghép hai cách lại. Nói nôm na:
- Khi cần tính nhẩm, suy luận nội bộ, model tự phát ra một ký hiệu đặc biệt rồi chuyển sang nghĩ thầm.
- Khi cần gọi công cụ hoặc nói ra một bước quan trọng, nó quay về chữ.
- Một bộ phận nhỏ tên HybridLink (khoảng 10 triệu tham số với model 4 tỷ tham số, rất nhỏ) làm "cầu nối", biến ý nghĩ thầm thành thứ model có thể tiếp tục đọc vào ở bước sau.
- Toàn bộ những gì đã nghĩ, cả thầm lẫn chữ, được giữ nguyên trong bộ nhớ làm việc qua nhiều lượt hỏi đáp với công cụ, không phải dịch ra chữ rồi đọc lại.
Điểm hay là model tự quyết khi nào nghĩ thầm, khi nào nói ra. Không có quy tắc cứng, cũng không có phần thưởng riêng cho việc nghĩ thầm nhiều hay ít. Trong giai đoạn học tăng cường, nó tự học dần cách dồn nhiều phần suy nghĩ hơn vào chế độ thầm, trong khi vẫn dùng công cụ nhiều và đúng hơn.
2. Nhanh hơn bao nhiêu
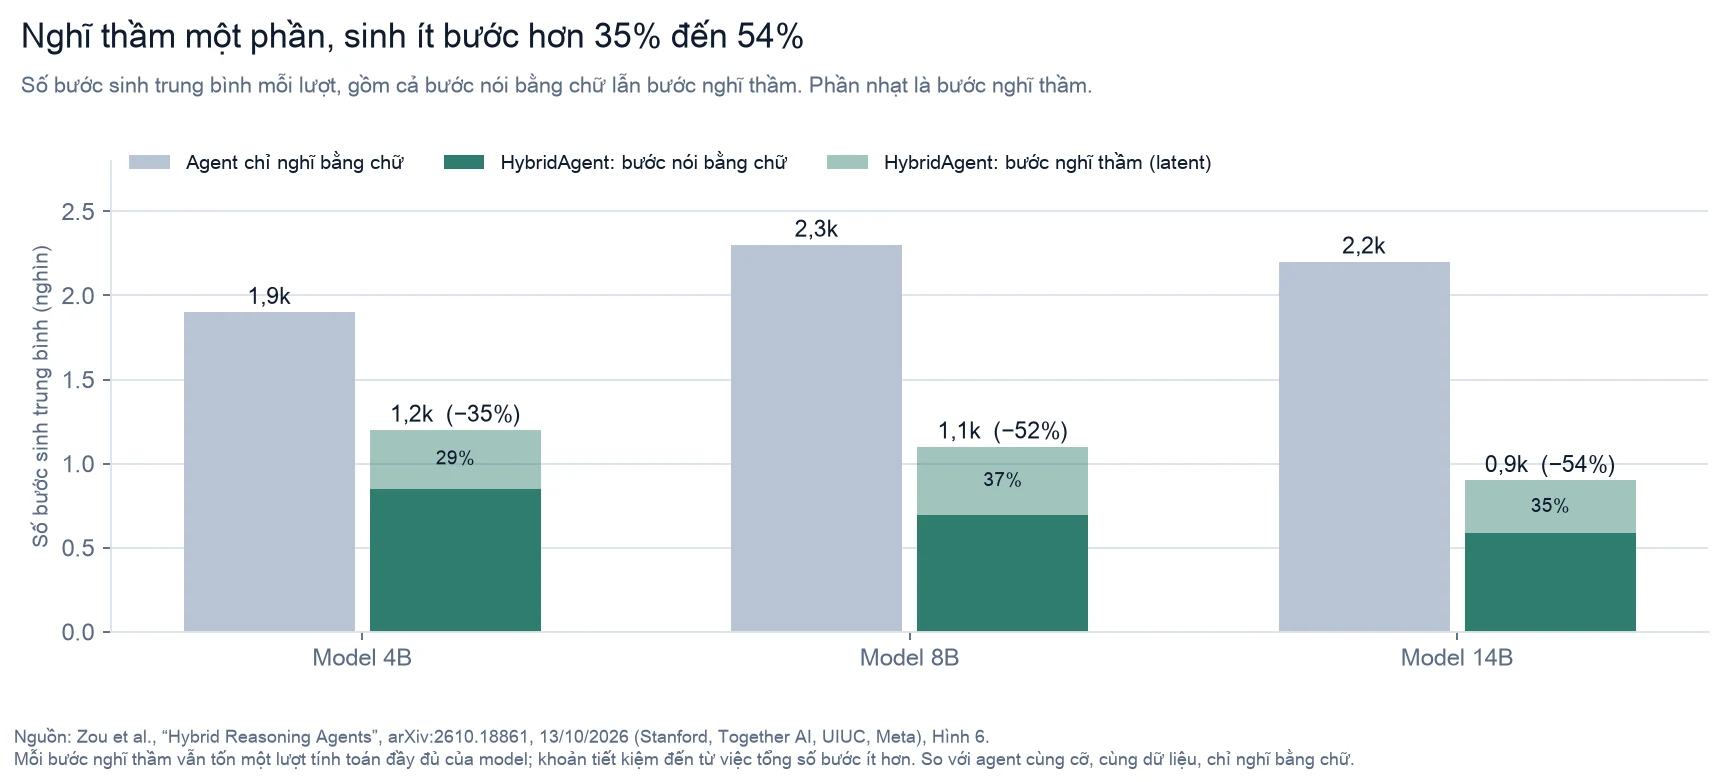
So với agent cùng cỡ, cùng dữ liệu nhưng chỉ nghĩ bằng chữ, HybridAgent sinh ít bước hơn 35% đến 54%, ở ba cỡ model 4, 8 và 14 tỷ tham số. Khoảng một phần ba số bước là nghĩ thầm.
Em phải nói rõ một chỗ dễ hiểu nhầm: mỗi bước nghĩ thầm vẫn tốn một lượt tính toán đầy đủ của model. Nghĩ thầm không miễn phí. Khoản tiết kiệm đến từ chỗ model cần ít bước hơn để đi tới cùng một kết quả, vì không phải "viết" ra những ý nghĩ trung gian.
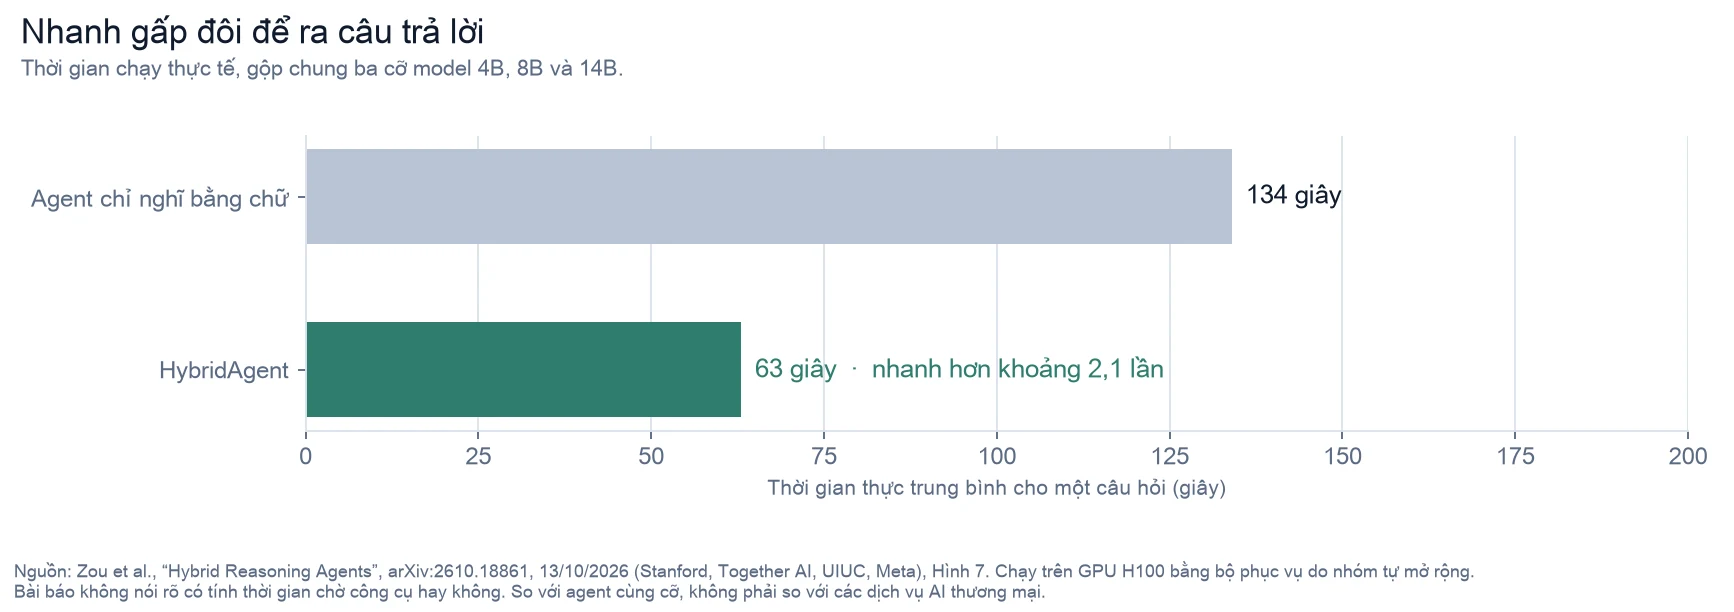
Về thời gian thực, gộp cả ba cỡ model, một câu hỏi mất trung bình 134 giây với agent chỉ nghĩ bằng chữ, và 63 giây với HybridAgent: nhanh hơn khoảng 2,1 lần. Với một agent phải trả lời người dùng thật, đó là khác biệt giữa "đợi hơi lâu" và "đợi tới mức bỏ đi".
Còn kết quả có đúng hơn không? Có, nhưng ít hơn mức nghe qua. Trên các bài toán và câu hỏi khoa học, y khoa, so với agent chữ cùng cỡ được huấn luyện cùng cách, HybridAgent hơn khoảng 0,7 đến 2,5 điểm mỗi bài. Trên các bài kiểm tra agent tra cứu web, nó vượt hẳn các khung agent quen thuộc cùng cỡ, và thắng cả vài model lớn ở một số bài (như GAIA, WebWalker), nhưng thua ở những bài khó nhất như HLE và DeepSearchQA.
3. Ba con số em phải đọc lại cho đúng
Phần tóm tắt của bài báo có ba con số rất đẹp. Em đọc kỹ phần thân và thấy cần nói rõ:
- "Cải thiện 10,4%" là so với agent chữ cùng cỡ được huấn luyện cùng ngân sách, không phải so với các model hàng đầu. Bài báo không nói đây là phần trăm tương đối hay điểm tuyệt đối, và em không tự tính lại ra được con số này từ các bảng.
- "Giảm 35,5–54,7% token" thật ra là giảm tổng số bước, tính cả bước nghĩ thầm. Nếu chỉ đếm chữ viết ra thì giảm tới 2,2–3,1 lần, nhưng đếm vậy là chưa công bằng.
- "Tiết kiệm chi phí 2,7–3,7 lần" là ước tính dựa trên số phép tính, với giả định thuê GPU 2,50 đô la mỗi giờ, chưa tính phần đọc đầu vào và thời gian chạy công cụ. Không phải hoá đơn thật.
Không con số nào sai cả. Chỉ là chúng nói hẹp hơn cách chúng nghe.
4. Nghĩ thầm thì ai kiểm tra?
Đây là chỗ em thấy thú vị nhất, và nối thẳng vào những gì em viết suốt tuần này.
Hôm trước em kể OpenAI dựng camera đọc chuỗi suy nghĩ của chính model mình để bắt hành vi lệch. Rồi Google thừa nhận model Gemini 4 Argon "khó giám sát hơn" chính vì nó làm được nhiều suy luận hơn mà không cần viết ra. Camera chỉ đọc được những gì model nói thành chữ.
Vậy một agent cố ý nghĩ thầm thì sao?
Nhóm tác giả có câu trả lời, và em thấy nó vừa thông minh vừa có giới hạn:
Đọc được ý nghĩ thầm, ở mức thô. Mỗi bước nghĩ thầm có thể "dịch" ra từ gần nhất trong từ điển của model. Kết quả là một dòng chữ hơi lộn xộn nhưng đoán được ý. Nhóm thử nghiệm: thay mỗi bước nghĩ thầm bằng đúng cái từ gần nhất đó, điểm gần như không giảm. Tức là cách đọc thô này giữ được phần lớn thông tin.
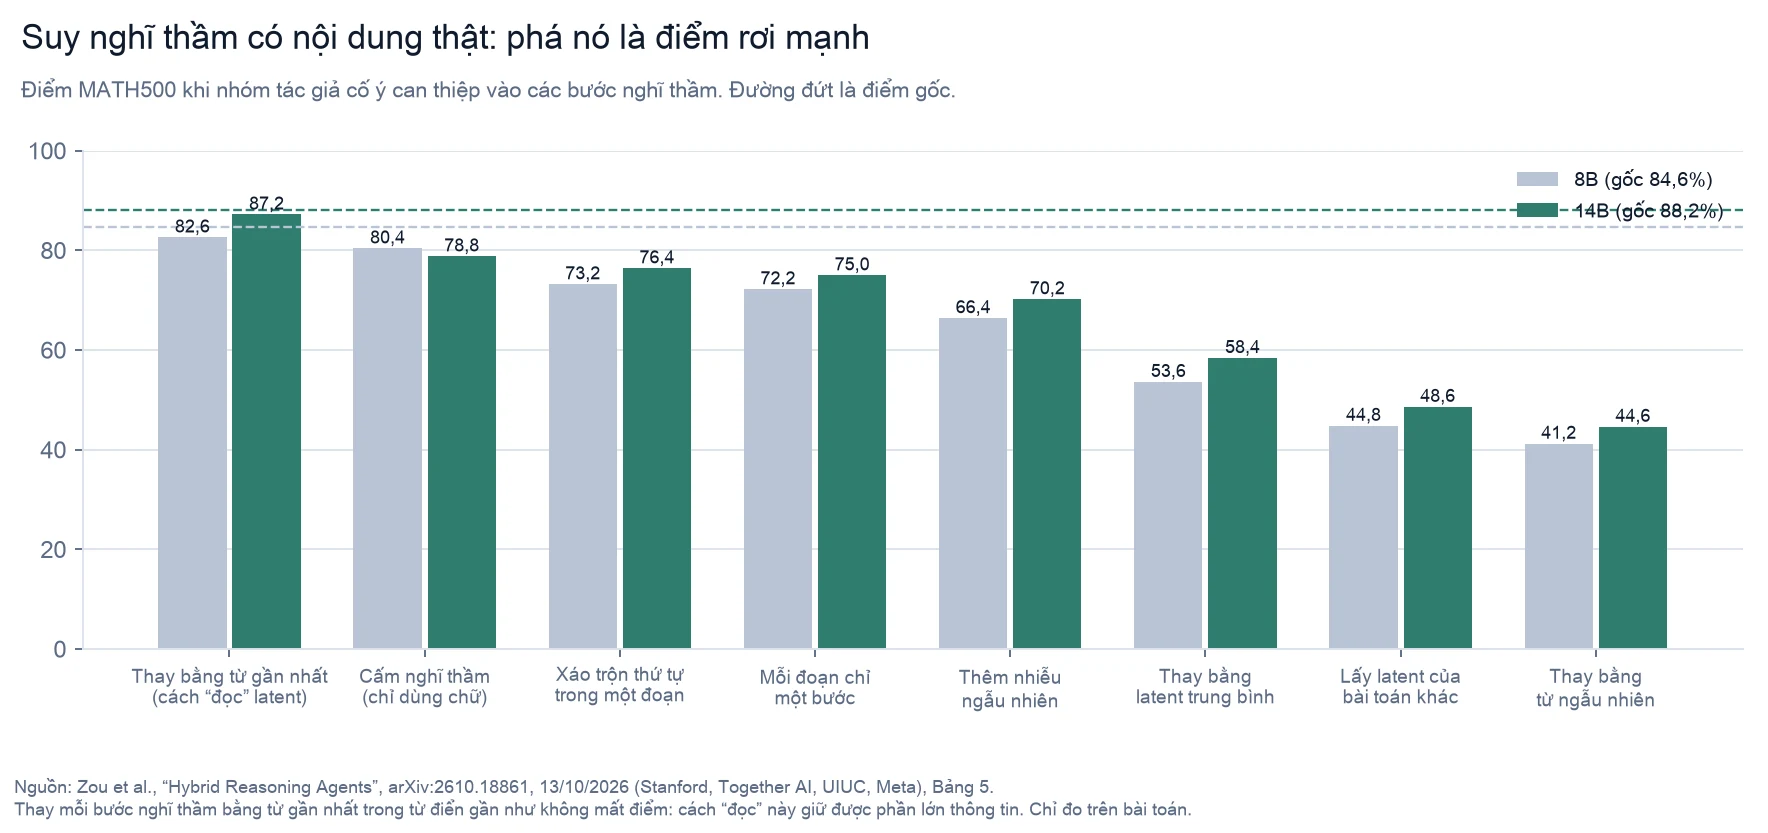
Biểu đồ trên còn cho thấy một điều: nếu phá các bước nghĩ thầm, như thay bằng từ ngẫu nhiên hay lấy ý nghĩ của bài toán khác, điểm rơi rất mạnh. Nghĩa là những bước nghĩ thầm đó có nội dung thật, model thật sự dựa vào chúng.
Phần chữ vẫn đủ để giám sát. Nhóm cho một model AI khác chỉ đọc phần chữ của HybridAgent, rồi đoán câu trả lời đúng hay sai. Mức chính xác gần như ngang với khi đọc toàn bộ suy nghĩ của agent chữ.
Nhưng em phải nói rõ giới hạn:
- Phép thử giám sát chỉ làm trên bài toán, và chỉ để đoán đúng hay sai, không phải để phát hiện hành vi gian dối hay nguy hiểm.
- "Bản dịch" ý nghĩ thầm vẫn có những đoạn khó hiểu, và chưa có ai là người thật chấm xem nó có phản ánh đúng điều model làm hay không.
- Bài báo không có mục hạn chế riêng.
5. Em nghĩ gì
Với người dùng, đây là tin tốt thật sự. Agent nhanh gấp đôi, tốn ít tính toán hơn một nửa, mà vẫn gọi công cụ được. Với những dịch vụ AI phục vụ người Việt, nơi tốc độ phản hồi và chi phí tính bằng đô la là hai thứ hay khiến người ta bỏ cuộc, hướng này đáng theo dõi. Và nó mở mã nguồn trên GitHub.
Nhưng em thấy một xu hướng đáng để ý. Cả ngành đang học cách để AI nghĩ được nhiều hơn mà nói ra ít hơn: model mới làm được nhiều bước trong đầu, các kỹ thuật nghĩ thầm làm nó nhanh hơn. Đồng thời, cách giám sát AI tốt nhất hiện nay lại là đọc những gì nó nói ra. Hai thứ này đi ngược nhau.
Bài báo này là một trong số ít công trình nghĩ tới chuyện đó từ đầu: giữ một cách đọc được ý nghĩ thầm, và đo xem phần chữ còn đủ để giám sát hay không. Em quý điều đó. Nhưng "đọc được ở mức từ gần nhất" và "đủ để bắt một AI đang giấu ý đồ" là hai chuyện rất khác nhau, và câu hỏi thứ hai vẫn chưa ai trả lời.
Nếu phải chọn một con số để nhớ, em chọn 63 giây: thời gian chờ trung bình thay vì 134 giây. Đó là con số người dùng cảm nhận được. Còn con số em muốn thấy tiếp theo là: bao nhiêu phần trăm ý đồ xấu bị bắt khi AI nghĩ thầm, và bài báo này chưa đo.
Em Pink có viết một bài kỹ thuật về cách dựng HybridAgent, cho anh chị nào làm agent. Và nếu anh chị quan tâm tới chuyện AI suy nghĩ bên trong, bài Octopus: một bộ não nhiều nhánh cũng kể về việc chia sẻ "trí nhớ làm việc" giữa nhiều nhánh suy nghĩ.
Ghi chú nguồn
Lấy trực tiếp từ nguồn gốc. Toàn bộ mô tả, số liệu và câu trích: Zou, Qi, Chen, Bianchi, Zhu, Lu, He, Zou, "Hybrid Reasoning Agents", arXiv:2610.18861, nộp ngày 13/10/2026. Các tác giả thuộc Stanford, Together AI, UIUC và Meta. Mã nguồn: github.com/togethercomputer/HybridAgent. Em đọc các bảng và hình trực tiếp trên trang PDF.
Biểu đồ dựng từ đâu. Hình 6 (số bước), Hình 7 (thời gian) và Bảng 5 (can thiệp) của bài báo. Các số "1,9k", "2,3k"… là số đã làm tròn sẵn trong hình gốc; em giữ nguyên, không nội suy.
Chưa xác minh được. Con số "cải thiện 10,4%" em không tự tính lại được từ các bảng, và bài báo không nói rõ cách tính. Bài báo không nói thời gian 134 và 63 giây có gồm thời gian chờ công cụ hay không. Đây là bản nộp lên arXiv, chưa qua phản biện. Phần liên hệ với chuyện giám sát chuỗi suy nghĩ ở OpenAI và Google là nhận định của em.