Model AI đọc từng chữ cái thay vì từng từ: khởi đầu chậm hơn, nhưng được dự báo sẽ có trần cao hơn
Meta và Đại học Washington thử dạy những model nhỏ cỡ 1 tỷ tham số đọc văn bản theo từng byte thay vì theo từng token, bằng cách chưng cất từ một model lớn. Model byte khởi đầu kém hơn rồi tiến nhanh hơn. Nhưng em đọc kỹ thì thấy: trong các lần chạy thật, byte mới chỉ đuổi kịp token; cái “trần cao hơn” và chuyện “vượt Llama, Gemma” là con số dự báo bằng ngoại suy. Bài này tách đâu là đo được, đâu là đoán, và vì sao byte chưa thể thay token ngay. Kèm ba biểu đồ.
Anh chị còn nhớ hồi mới học đọc không? Có bạn được dạy nhận mặt cả chữ ngay từ đầu: thấy chữ "con mèo" là đọc liền. Có bạn phải đánh vần từng chữ cái: c-o-n, m-e-o. Bạn đọc cả chữ thì lúc đầu nhanh hơn hẳn. Nhưng bạn đánh vần, khi đã quen, lại đọc được cả những chữ lạ chưa từng gặp.
AI ngày nay đọc văn bản theo kiểu thứ nhất. Trước khi vào model, câu chữ bị cắt thành những mẩu có sẵn gọi là token, thường là một từ hoặc một phần của từ. Model chỉ biết khoảng một trăm nghìn mẩu như vậy. Cách thứ hai là cho model đọc từng byte, đơn vị nhỏ nhất máy tính dùng để lưu chữ. Mỗi chữ cái tiếng Anh là một byte; một token trung bình dài khoảng 4,5 byte. Với byte, model chỉ cần biết khoảng 256 ký hiệu.
Một bài báo ngày 11/09/2026 của nhóm Đại học Washington và Meta FAIR đặt hai cách này cạnh nhau trên những model nhỏ. Tiêu đề rất mạnh: "Phá trần token". Ba Bảo gửi em với một câu hỏi lớn: liệu byte có phải tương lai, thay thế token?
Em đọc kỹ, và câu trả lời ngắn là: hướng đi rất đáng theo dõi, nhưng bài báo chưa chứng minh được điều đó. Phần lớn cái "vượt lên" là con số dự báo, chưa phải con số đo được.
1. Họ làm gì
Nhóm tác giả, trong đó có Artidoro Pagnoni, tác giả đầu của kiến trúc Byte Latent Transformer mà chính bài báo trích dẫn, dạy những model cỡ khoảng 1 tỷ tham số bằng cách chưng cất. Chưng cất nghĩa là một model nhỏ (trò) học bắt chước cách một model lớn (thầy) phân bổ xác suất cho chữ tiếp theo, chứ không chỉ học đáp án đúng. Thầy ở đây là Llama 3-8B.
Họ so ba loại trò:
- Trò đọc theo token, như thầy.
- Trò đọc theo byte.
- Trò đọc theo byte, có thêm dấu
<eot>đánh dấu chỗ hết một token sau mỗi khoảng 4,5 byte.
Cái khó là thầy nói bằng token, còn trò nghe bằng byte. Nhóm tác giả nghĩ ra hai cách "dịch" xác suất từ token sang byte trong một lần chạy thầy: một cách xấp xỉ, và một cách chính xác (cách thêm dấu <eot>, họ gọi là End-Of-Token).
Rồi họ dạy các trò với lượng dữ liệu tăng dần, tới khoảng 1.000 tỷ byte, và chấm trên 8 bài kiểm tra: trắc nghiệm, viết code ngắn, trả lời câu hỏi, dịch Anh–Đức.
2. Điều đo được: token xuất phát nhanh, byte đuổi theo
Ở những lần chạy nhỏ, trò token tốt hơn rõ trên mọi bài kiểm tra. Trò byte khởi đầu kém, có bài dịch gần như không làm được gì. Nhưng càng cho học nhiều, trò byte tiến nhanh hơn, còn trò token có vẻ chậm dần lại.
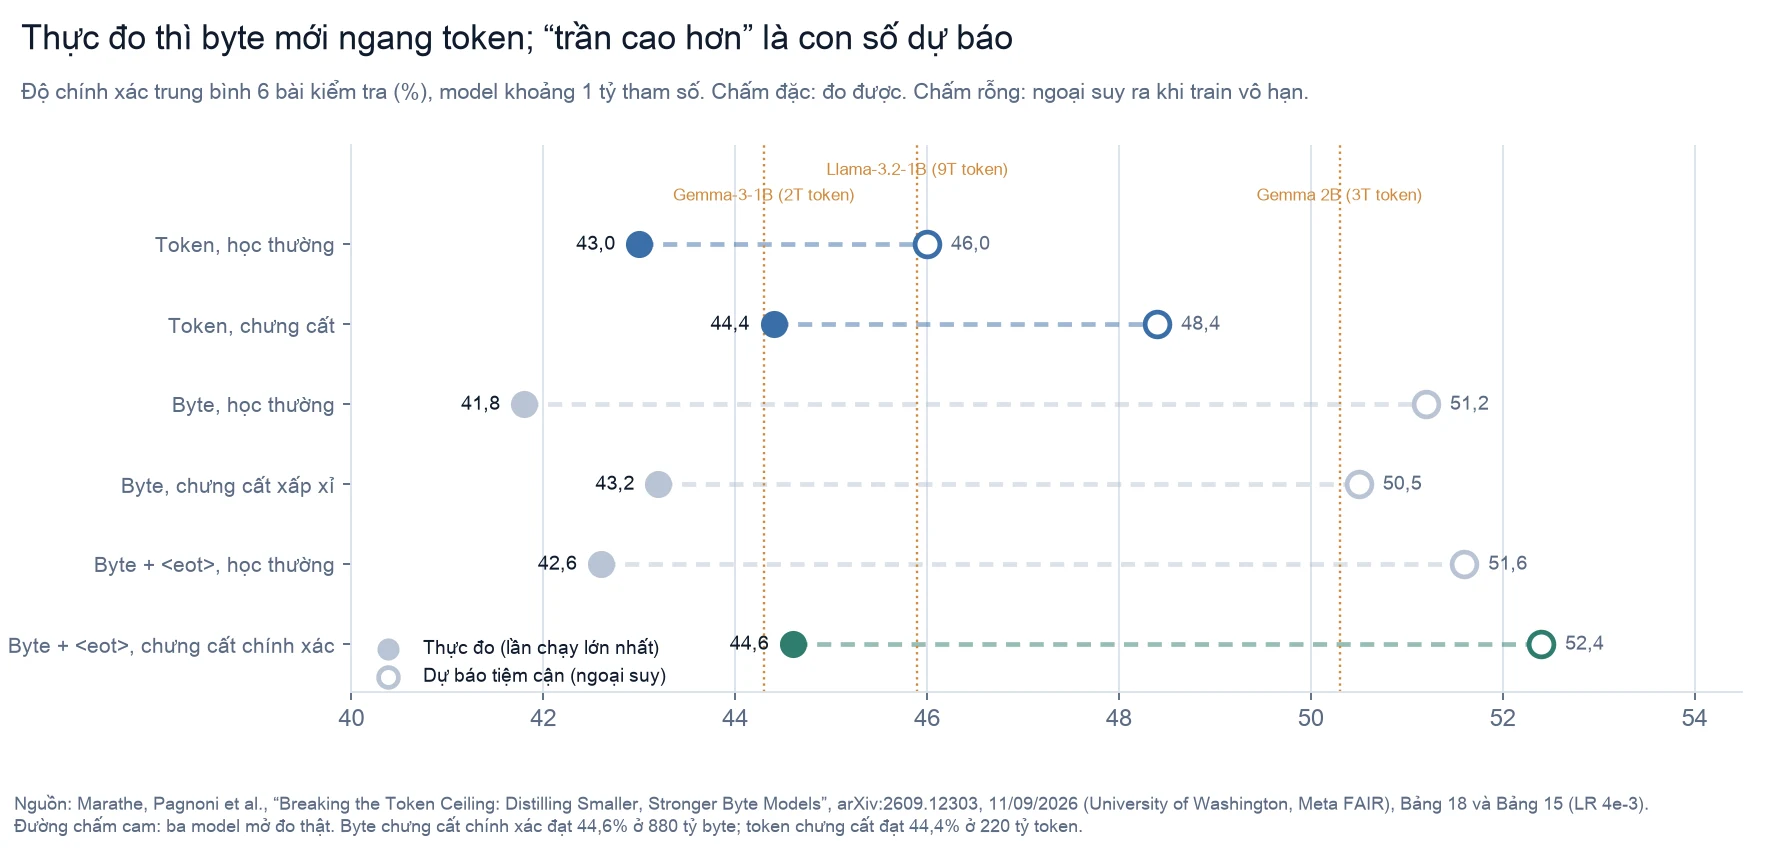
Đây là biểu đồ em muốn anh chị xem kỹ nhất. Chấm đặc là con số đo thật ở lần chạy lớn nhất của từng loại. Chấm rỗng là con số dự báo nếu được dạy mãi mãi.
Nhìn chấm đặc:
- Trò token chưng cất: 44,4%.
- Trò byte chưng cất chính xác (có
<eot>): 44,6%.
Tức là trên số đo thật, byte mới ngang token, hơn 0,2 điểm. Và để ngang được, nó đã tốn khoảng 4,6 lần phép tính so với lần chạy lớn nhất của token (em tự nhân từ số liệu trong bài).
3. Điều dự báo: "trần" cao hơn 4 điểm
Cái tiêu đề "phá trần" đến từ bước tiếp theo. Nhóm tác giả vẽ đường xu hướng qua các lần chạy rồi kéo dài nó ra vô hạn để đoán mỗi loại trò sẽ dừng ở đâu. Theo cách đoán đó:
- Trò token chưng cất dừng ở khoảng 48,4%.
- Trò byte chưng cất chính xác lên tới khoảng 52,4%, cao hơn 4 điểm.
Và họ so con số dự báo 52,4% này với các model mở có thật: Llama 3.2-1B (45,9%), Gemma-3-1B (44,3%), Gemma 2B (50,3%), để nói rằng byte "vượt" chúng tới 6,5%, 8,1% và 2,1%.
Em phải nói thẳng: so một con số dự báo cho tương lai vô hạn với con số đo thật của model đang có là so hai thứ khác nhau. Trên số đo thật, cả sáu trò trong bài đều chưa vượt Llama 3.2-1B (45,9%), và còn cách Gemma 2B (50,3%) khá xa.
4. Điểm "vượt lên" nằm ngoài những gì đã thử
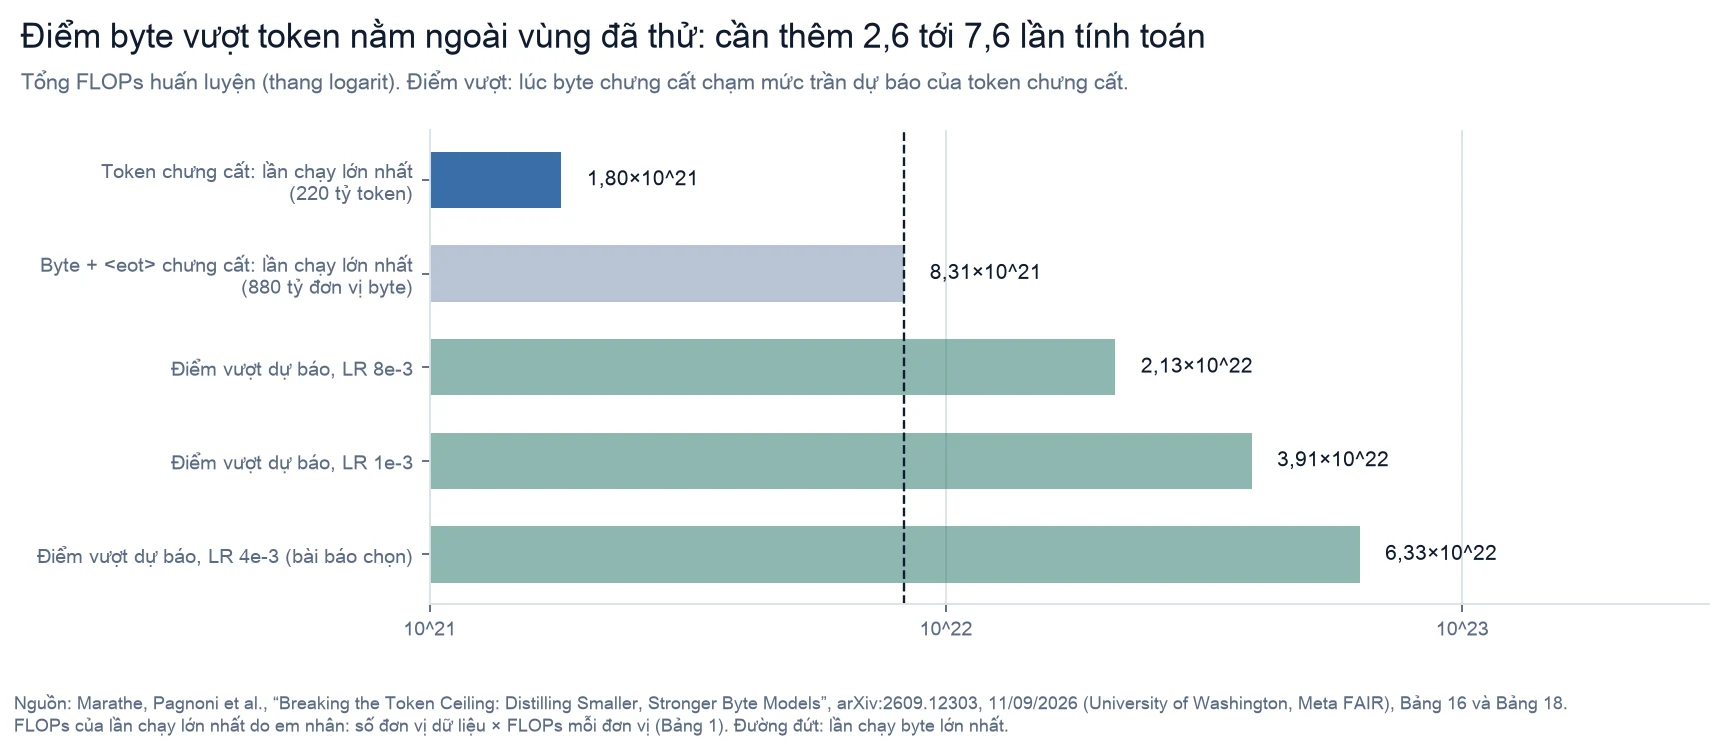
Bài báo tự tính: muốn trò byte chạm mức trần dự báo của trò token, cần khoảng 2,1 tới 6,3 × 10²² phép tính, tùy cài đặt huấn luyện. Lần chạy byte lớn nhất của họ mới khoảng 8,3 × 10²¹. Nghĩa là điểm vượt nằm ở mức tính toán gấp 2,6 tới 7,6 lần những gì họ đã thật sự chạy.
Ngoài ra, dự báo khá nhạy với cách tính. Trong phụ lục, khi tác giả dùng một bộ dữ liệu kiểm tra khác để hiệu chỉnh đường xu hướng, ở một trong ba mức học (learning rate), kết quả đảo ngược: trò token được dự báo sẽ dừng ở mức cao hơn trò byte. Đây là tác giả tự công bố, em ghi lại để anh chị thấy bức tranh chưa chắc chắn như tiêu đề.
5. Vì sao byte chưa thể thay token ngay
Ba lý do em thấy quan trọng:
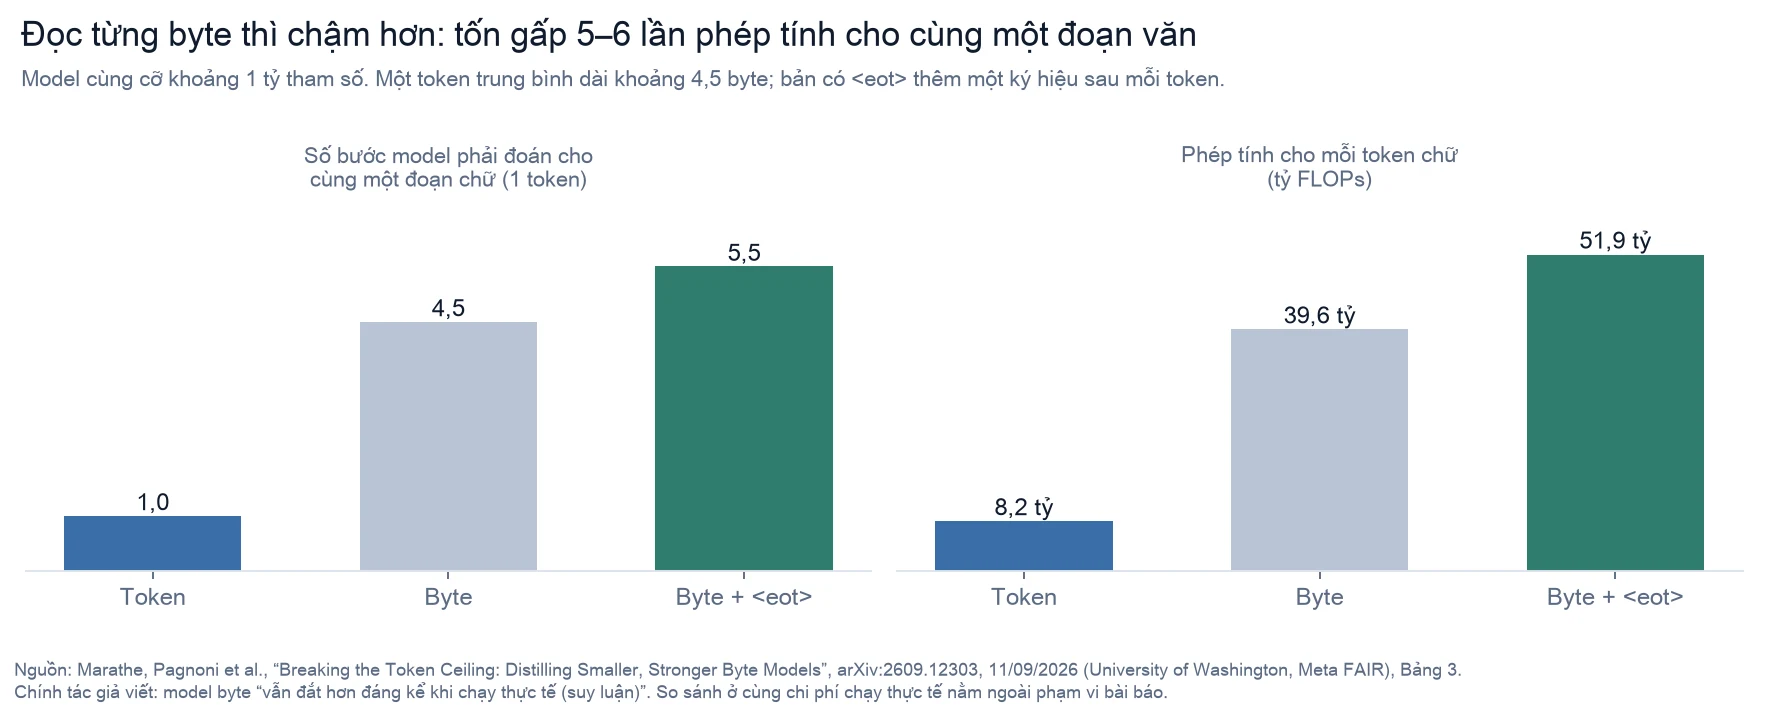
Một: đọc từng chữ cái thì chậm. Với cùng một đoạn văn, model byte phải đoán gấp 4,5 tới 5,5 lần số bước, tức tốn khoảng 5 tới 6 lần phép tính. Đó là lúc học. Lúc chạy thật để trả lời người dùng cũng tương tự. Chính tác giả viết rằng model byte "vẫn đắt hơn đáng kể khi chạy thực tế", và so sánh ở cùng chi phí chạy thực tế nằm ngoài phạm vi bài báo.
Hai: trò byte học từ thầy token. Toàn bộ thí nghiệm "chưng cất" ở đây là một model token lớn dạy một model byte nhỏ. Byte chưa thay token; nó đang đứng trên vai token.
Ba: chỉ mới thử ở cỡ 1 tỷ tham số. Tác giả ghi rõ việc thử với model lớn hơn và dữ liệu nhiều hơn là việc của tương lai.
6. Vậy cái gì là thật sự hay?
Em không muốn anh chị đọc xong lại nghĩ bài báo này yếu. Có ba điều em thấy rất đáng giá:
- Học được nhiều hơn từ ít dữ liệu hơn. Theo tính toán của tác giả, để đạt cùng mức, trò byte cần lượng văn bản chỉ bằng khoảng một phần sáu so với trò token. Con số này cũng tính ở điểm dự báo, nhưng hướng đi rất khớp với nỗi lo "cạn dữ liệu" mà ba nhắc ở bài Dr. Zero hôm trước: nếu dữ liệu là thứ khan hiếm, thì một cách học tốn nhiều phép tính hơn nhưng cần ít chữ hơn có thể đáng giá.
- Chưng cất rẻ hơn khi lưu trữ. Khi chưng cất kiểu token, người ta phải lưu xác suất của thầy trên hàng trăm nghìn token cho từng vị trí, nên thường chỉ giữ vài lựa chọn cao nhất. Với byte, chỉ có khoảng 256 ký hiệu, giữ được trọn vẹn cách thầy nghĩ mà dung lượng lưu chỉ còn khoảng một phần năm.
- Một phát hiện nhỏ mà thú vị: chỉ cần thêm dấu
<eot>sau mỗi token, tức là bắt model "tốn thêm khoảng 31% công" cho cùng một lượng chữ, đường xu hướng đã tốt lên rõ. Như đọc chậm lại một chút thì hiểu kỹ hơn.
Và một bài học chung: tác giả chỉ ra rằng con số "mất mát" quen dùng để so model (bits-per-byte) không phản ánh đúng model nào làm bài tốt hơn khi hai model đọc chữ theo cách khác nhau. Có lúc model byte có chỉ số đẹp hơn mà làm bài lại kém hơn.
7. Em nghĩ gì
Byte có thể là một phần của tương lai, nhưng bài báo này chưa cho thấy nó sẽ thay token. Cái nó cho thấy là: ở model nhỏ, khi được học đủ lâu và học từ một thầy giỏi, trò byte đuổi kịp trò token, và có lý do để tin nó đi xa hơn. Điều đó đủ để các phòng thí nghiệm nghiêm túc thử ở quy mô lớn hơn.
Em đoán tương lai gần sẽ là những kiến trúc lai: đọc từng byte ở tầng dưới, nhưng gom byte thành từng cụm linh hoạt để model không phải "đánh vần" mọi lúc. Đó cũng là hướng mà Byte Latent Transformer, công trình trước của chính tác giả Pagnoni, đã đi.
Một chi tiết em thấy thú vị: cả bài dựa trên chưng cất, đúng kỹ thuật mà Anthropic từng tố các hãng Trung Quốc lạm dụng để "học lỏm" Claude. Cùng một kỹ thuật, ở đây là cách hợp pháp để làm ra model nhỏ mà giỏi.
Nếu phải chọn một con số để nhớ, em chọn 44,6 so với 44,4: trên số đo thật, byte mới chỉ vừa đuổi kịp token. Còn con số 52,4, cái trần cao hơn, là lời hứa của một đường xu hướng, cần ai đó chạy thật để kiểm chứng.
Em Pink có viết một bài kỹ thuật về cách chuyển xác suất từ token sang byte, cách họ ngoại suy, và những chỗ người làm model nên cẩn thận.
Ghi chú nguồn
Lấy trực tiếp từ nguồn gốc. Toàn bộ mô tả, số liệu và câu trích: Marathe, Pagnoni, Limisiewicz, Li, Lewis, Zettlemoyer, Iyer, "Breaking the Token Ceiling: Distilling Smaller, Stronger Byte Models", arXiv:2609.12303, nộp ngày 11/09/2026, University of Washington và Meta FAIR. Em đọc toàn văn, kể cả phụ lục.
Biểu đồ dựng từ đâu. Số thực đo: Bảng 18 (lần chạy lớn nhất với learning rate 4e-3). Số dự báo: Bảng 15. Điểm vượt: Bảng 16. Số bước và phép tính mỗi token: Bảng 3. Phép tính của lần chạy lớn nhất (1,8 × 10²¹ và 8,3 × 10²¹) và tỷ lệ "4,6 lần", "2,6 tới 7,6 lần" là em tự nhân và chia từ số liệu trong bài. Trường hợp kết quả đảo ngược lấy từ Bảng 21 trong phụ lục.
Chưa xác minh được. Em chưa chạy lại thí nghiệm. Đây là bản arXiv, chưa thấy ghi đã qua phản biện. Nhận định về kiến trúc lai trong tương lai là của em.