Một AI đóng vai cả hội đồng bác sĩ, chẩn đoán đúng 83% ca khó. Nhưng con số đó đã đổi một lần trước khi lên Science.
Microsoft AI dựng một hệ thống cho một model đóng năm vai bác sĩ, tự tranh luận trước mỗi câu hỏi và mỗi xét nghiệm. Trên 304 ca khó của tạp chí NEJM và 325 ca cấp cứu, nó chẩn đoán đúng 83,2% và 80,3%, so với 36,1% và 46,8% của bác sĩ đa khoa, lại tốn ít tiền xét nghiệm hơn. Em đọc bản đăng trên Science và bản thảo sửa của nhóm tác giả để kể vì sao kết quả này đáng chú ý, và vì sao “gấp bốn lần bác sĩ” năm ngoái giờ chỉ còn hơn gấp đôi. Kèm ba biểu đồ.
Một bệnh nhân đi khám vì mấy tháng liền hay té ngã, yếu cơ đùi, dễ bầm tím, chảy máu chân răng, rụng răng. Người này từng mổ thu nhỏ dạ dày và ăn rất ít trái cây.
GPT‑5, dùng trực tiếp như một model thông thường, bắt đầu nghĩ tới bệnh thần kinh. Nó cho làm một loạt xét nghiệm đắt tiền: đo hệ thần kinh tự chủ, điện cơ, sàng lọc bệnh thoái hoá dạng bột, xét nghiệm cận ung thư. Cuối cùng nó đưa ra một lời giải thích lan man, nhiều nguyên nhân, và bỏ sót chẩn đoán đúng. Chi phí xét nghiệm ước tính: 8.806 đô la.
Cũng GPT‑5 đó, nhưng được tổ chức thành một "hội đồng bác sĩ" ảo, nối được ba manh mối đặc hiệu: chảy máu chân răng, rụng răng, chế độ ăn thiếu rau quả. Nó đặt một xét nghiệm rẻ tiền: đo vitamin C trong máu. Kết quả: bệnh scorbut, căn bệnh của thuỷ thủ đi biển dài ngày thế kỷ 18. Chi phí: 1.161 đô la.
Câu chuyện này nằm trong bài báo của Microsoft AI vừa đăng trên tạp chí Science ngày 22/10/2026. Và nó nói đúng điều làm em thấy bài báo này hay: cùng một bộ não, cách tổ chức suy nghĩ khác nhau cho ra kết quả rất khác nhau.
1. Chẩn đoán không phải là bài trắc nghiệm
Phần lớn các bài kiểm tra AI y khoa trước đây giống đề thi trắc nghiệm: đưa đủ mọi thông tin của bệnh nhân một lượt, rồi hỏi chọn đáp án nào. Ngoài đời không như vậy.
Bác sĩ thật bắt đầu với vài câu than phiền, rồi phải tự quyết định hỏi gì tiếp, khám gì, xét nghiệm gì, theo thứ tự nào, và khi nào thì đủ để kết luận. Mỗi xét nghiệm tốn tiền, tốn thời gian, đôi khi gây đau cho bệnh nhân.
Nhóm tác giả gọi đó là chẩn đoán tuần tự, và dựng một bộ kiểm tra tên SDBench để đo đúng điều này:
- Người chẩn đoán (bác sĩ hay AI) chỉ được đọc hai, ba câu mở đầu về bệnh nhân.
- Muốn biết thêm thì phải hỏi hoặc đặt xét nghiệm cụ thể. Một AI khác đóng vai "người giữ hồ sơ", chỉ trả lời đúng cái được hỏi, không gợi ý, không giải thích.
- Mỗi lượt khám tính 300 đô la; mỗi xét nghiệm tính theo bảng giá thật của một hệ thống bệnh viện Mỹ.
- Khi chốt chẩn đoán, một AI làm giám khảo chấm điểm theo thang 5 bậc do bác sĩ soạn.
Bộ ca gồm 304 ca hội chẩn lâm sàng – bệnh lý đăng trên tạp chí NEJM từ 2017 tới 2025 (những ca khó, hiếm, chọn vì giá trị giảng dạy) và 325 ca nhập viện qua cấp cứu từ bộ dữ liệu MIMIC‑IV‑ED (gần với ca thường gặp hơn).
2. Một model, năm vai bác sĩ
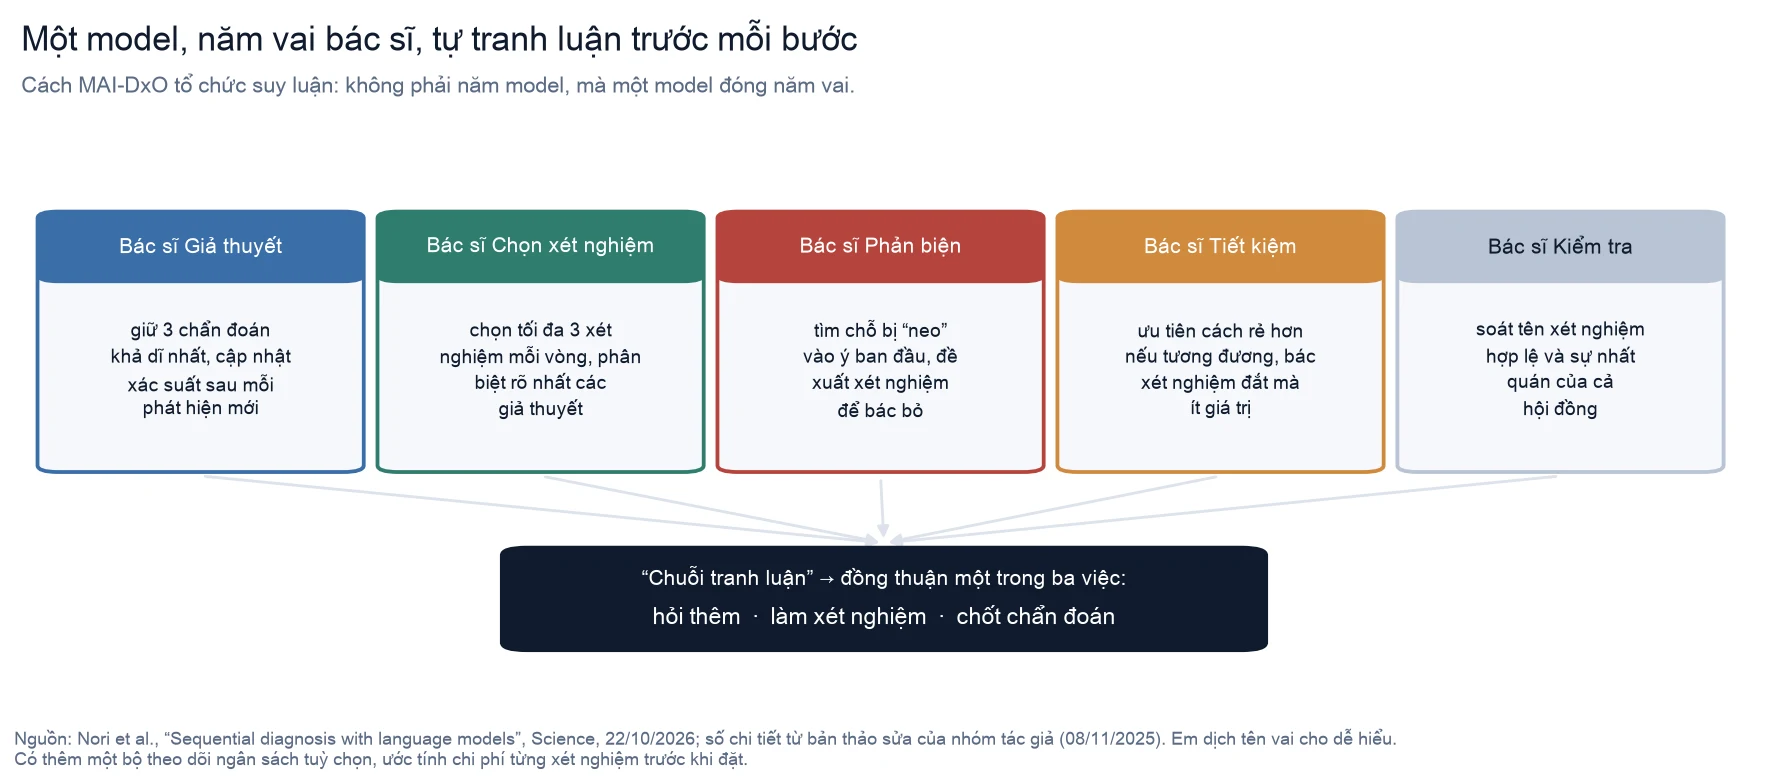
Hệ thống tên MAI‑DxO (MAI Diagnostic Orchestrator). Nó không phải năm model khác nhau. Nó là một model đóng năm vai, như một nhóm bác sĩ hội chẩn:
- Bác sĩ Giả thuyết giữ danh sách ba chẩn đoán khả dĩ nhất và cập nhật xác suất sau mỗi phát hiện mới.
- Bác sĩ Chọn xét nghiệm chọn tối đa ba xét nghiệm mỗi vòng, loại giúp phân biệt rõ nhất các giả thuyết.
- Bác sĩ Phản biện đóng vai "kẻ cãi ngang": chỉ ra chỗ hội đồng đang bị "neo" vào ý đầu tiên, và đề xuất xét nghiệm để bác bỏ chẩn đoán đang dẫn đầu.
- Bác sĩ Tiết kiệm ưu tiên cách rẻ hơn khi cho kết quả tương đương, và bác những xét nghiệm đắt mà ít giá trị.
- Bác sĩ Kiểm tra lặng lẽ soát lỗi: tên xét nghiệm có hợp lệ không, các vai có nói ngược nhau không.
Sau một vòng "tranh luận", hội đồng đồng thuận làm một trong ba việc: hỏi thêm, làm xét nghiệm, hay chốt chẩn đoán.
Nói nôm na: đây là một bác sĩ rất giỏi được ép phải tự hỏi mình đủ năm câu trước mỗi quyết định. Và chính các tác giả viết rằng phần lớn bác sĩ ngoài đời "không có điều kiện để có cả một nhóm liên tục soát lại lập luận của mình".
3. Kết quả
Chạy trên GPT‑5:
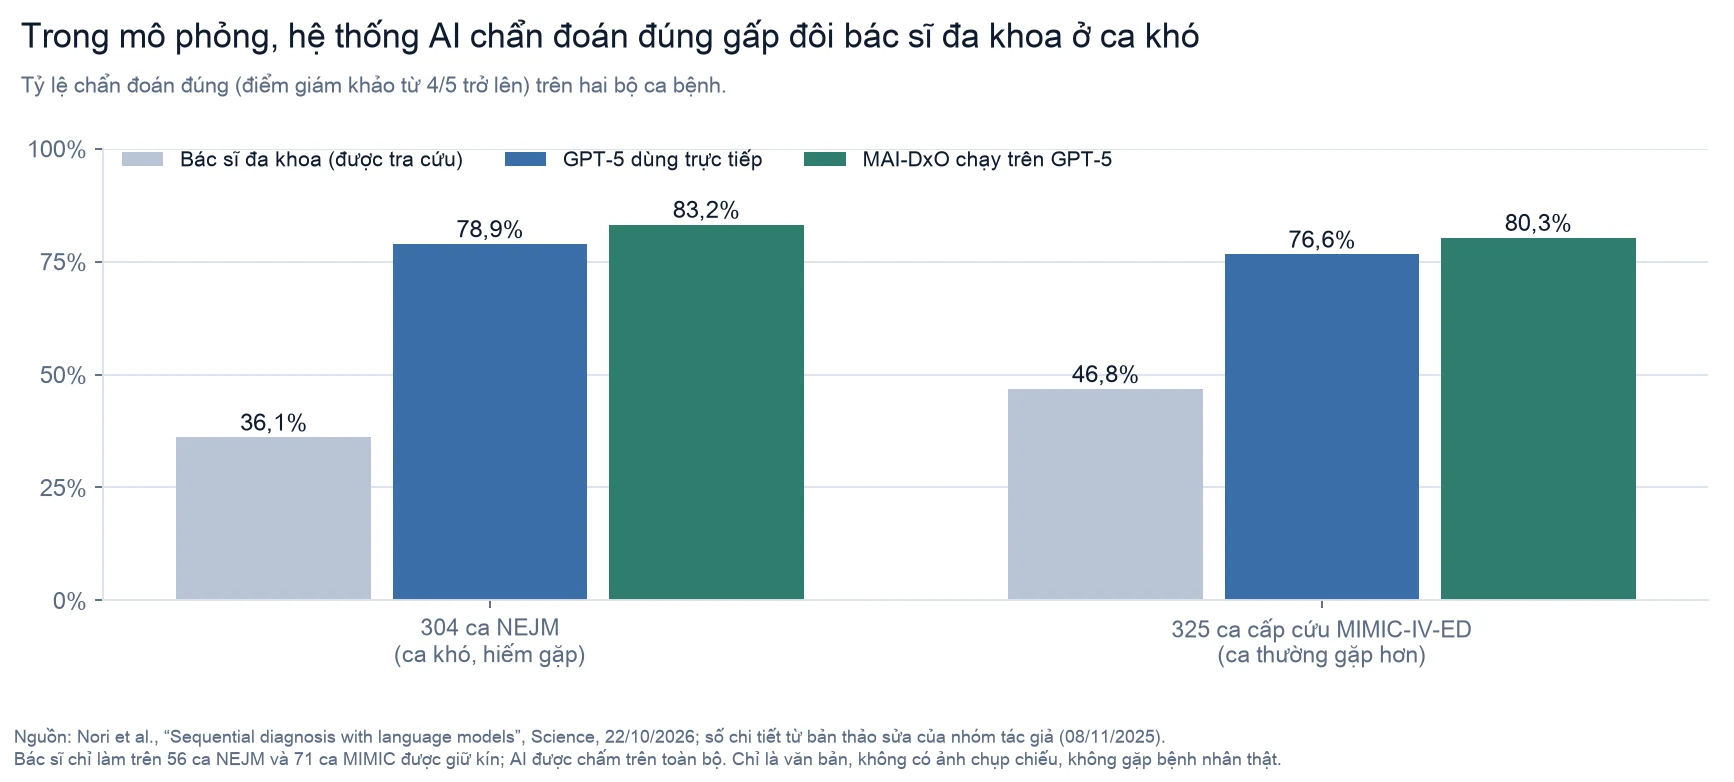
- Bộ ca NEJM: MAI‑DxO chẩn đoán đúng 83,2%, GPT‑5 dùng trực tiếp 78,9%, bác sĩ đa khoa 36,1%.
- Bộ ca cấp cứu: MAI‑DxO 80,3%, GPT‑5 dùng trực tiếp 76,6%, bác sĩ 46,8%.
Bác sĩ tham gia là người hành nghề ở Mỹ và Anh, trung vị 12 năm kinh nghiệm, phần lớn là bác sĩ chăm sóc ban đầu. Không ai trong số họ, kể cả người giỏi nhất (51,8% trên bộ NEJM, 62,5% trên bộ cấp cứu), vượt được hệ thống ở cả độ chính xác lẫn chi phí.
Một chi tiết em thấy đáng chú ý hơn cả: độ chính xác của AI gần như không đổi giữa ca hiếm và ca thường, còn bác sĩ thì tụt mạnh ở ca hiếm. Các tác giả tóm lại: "Con người giảm sút ở những ca hiếm gặp, còn các agent được tổ chức thì không."
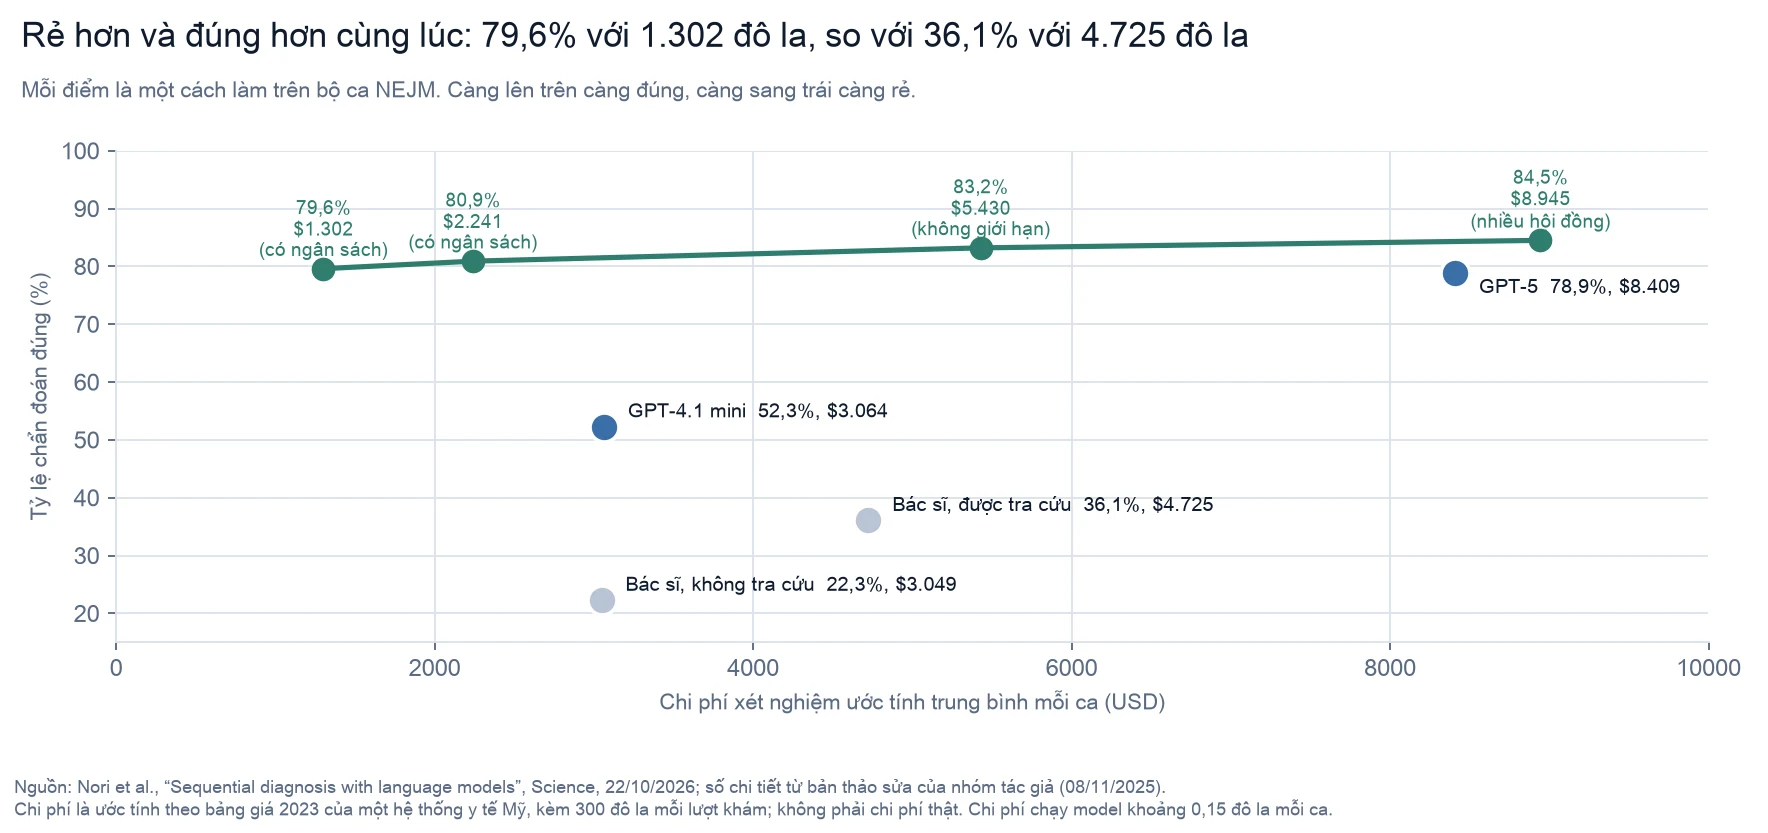
Và rẻ hơn. GPT‑5 dùng trực tiếp đạt 78,9% nhưng tốn 8.409 đô la xét nghiệm mỗi ca. MAI‑DxO đạt 83,2% với 5.430 đô la. Khi gắn thêm bộ theo dõi ngân sách, nó vẫn đạt 80,9% với 2.241 đô la, hoặc 79,6% với chỉ 1.302 đô la: rẻ hơn cả bác sĩ (4.725 đô la) mà đúng hơn gấp đôi.
Chi phí chạy chính model thì nhỏ không đáng kể: khoảng 0,15 đô la mỗi ca.
Hệ thống cũng giúp mọi model mà nhóm thử, từ GPT, Gemini, Claude, Grok, DeepSeek tới Llama. Trên bộ NEJM, mức cải thiện trung bình là 7,9 điểm; model Gemini 2.5 Flash tăng tới 24,4 điểm.
4. "Gấp bốn lần bác sĩ" đã thành "hơn gấp đôi". Đây là chuyện tốt
Anh chị có thể nhớ tin này từ giữa năm 2025, khi bản thảo đầu tiên lên arXiv với tiêu đề rất kêu: AI chính xác 80%, "cao gấp bốn lần mức 20% của bác sĩ đa khoa".
Bản đăng trên Science khác ở ba chỗ quan trọng:
- Bác sĩ được tra cứu tài liệu. Bản cũ so với bác sĩ không được dùng sách, tra cứu hay công cụ nào. Bản mới thêm một nhóm 19 bác sĩ được dùng các nguồn tra cứu như UpToDate và hướng dẫn NICE (nhưng không được dùng AI tạo sinh). Độ chính xác tăng từ 22,3% lên 36,1%. Và bài Science lấy con số 36,1% để so.
- Thêm bộ ca cấp cứu, gần với thực tế hơn, nơi bác sĩ làm tốt hơn (46,8%).
- Đổi sang model mới hơn (GPT‑5 thay o3), giữ nguyên cách tổ chức hội đồng, để kiểm tra xem hệ thống có dùng được với model ra đời sau nó không.
Kết quả: khoảng cách vẫn rất lớn, nhưng từ "gấp bốn" thành "hơn gấp đôi" (83,2% so với 36,1%). Em nghĩ đây là ví dụ đẹp về việc phản biện khoa học làm việc của nó: phép so sánh trở nên công bằng hơn, và con số trở nên đáng tin hơn chính vì nó nhỏ đi.
À, anh chị để ý giúp em một chi tiết nhỏ: bản đầu tiên lên arXiv ngày 27/06/2025, sửa lần đầu ngày 02/07/2025, nên nhiều nơi nhớ là tháng 7.
5. Những chỗ cần đọc kỹ trước khi chia sẻ
Chính các tác giả viết rằng chữ "siêu phàm" ở đây "chỉ nói về việc thu thập thông tin và độ chính xác chẩn đoán trong điều kiện lý tưởng, không phải toàn bộ việc lập luận lâm sàng, chăm sóc bệnh nhân hay phán đoán y khoa". Cụ thể:
- Chỉ có chữ. Không có hình ảnh chụp chiếu, không có điện tim, không có tiêu bản giải phẫu bệnh, những thứ là trung tâm của chẩn đoán thật. Không gặp bệnh nhân, không khám, không có những bệnh nhân quên kể hay kể sai.
- Bác sĩ làm một mình. Ngoài đời, ca khó được hội chẩn nhiều chuyên khoa. Ở đây là từng bác sĩ đa khoa, qua giao diện chat, với những ca được chọn vì hiếm và khó.
- Không so cùng một tập ca. Bác sĩ làm trên 56 ca NEJM và 71 ca cấp cứu được giữ kín; AI được chấm trên toàn bộ. Bài báo ghi rằng AI làm tốt hơn trên tập 56 ca đó.
- "Người giữ hồ sơ" tự bịa kết quả hợp lý cho những xét nghiệm không có trong hồ sơ gốc, để không vô tình gợi ý. Nhóm tác giả đã cho bác sĩ kiểm 508 câu trả lời và không thấy câu nào lộ đáp án, nhưng đây vẫn là môi trường mô phỏng.
- Chi phí là ước tính theo bảng giá năm 2023 của một hệ thống y tế Mỹ, không tính thời gian chờ kết quả hay mức độ xâm lấn.
- Chưa thử trên bệnh nhân thật. Các tác giả nói rõ cần thử nghiệm tiến cứu trong môi trường lâm sàng.
Và một điều em tự để ý: người giữ hồ sơ, giám khảo, và model làm bài đều dùng GPT‑5. Bài báo kiểm tra giám khảo bằng bác sĩ (mức đồng thuận tốt, và khi lệch thì bác sĩ thấy giám khảo quá khắt khe), nhưng em nghĩ đây là chỗ đáng để các nhóm khác kiểm lại độc lập.
6. Em nghĩ gì
Phần quý nhất không phải con số 83%, mà là bộ kiểm tra. Đo AI y khoa bằng đề trắc nghiệm thì giống chấm tài lái xe bằng bài thi lý thuyết. SDBench bắt AI và bác sĩ phải tự quyết định hỏi gì, xét nghiệm gì, và khi nào dừng, đồng thời tính tiền cho từng quyết định. Đó mới là việc bác sĩ làm hằng ngày.
Phần hữu ích nhất cho bác sĩ có lẽ là năm cái vai. Các tác giả không đề xuất thay bác sĩ. Họ đề xuất rằng chính cách suy nghĩ này, theo dõi giả thuyết rõ ràng, tự phản biện, cân nhắc giá trị của từng xét nghiệm, có thể giúp bác sĩ. Bác sĩ vốn làm những việc này trong đầu, chỉ là hiếm khi có hệ thống và hay bị cắt ngắn khi mệt hay vội.
Và phần làm em nghĩ tới nhiều nhất là chuyện giá. Các tác giả viết rằng ở những nơi thiếu nguồn lực, chẩn đoán đúng mà tiết kiệm có thể giúp "tác động tới nhiều mạng người hơn trên mỗi đồng chi tiêu". Em vừa viết về bất bình đẳng agentic: ai có agent giỏi, ai không. Y tế là nơi câu hỏi đó cụ thể nhất. Một hệ thống tốn 0,15 đô la tiền chạy model mỗi ca là thứ có thể đến được với số đông, nếu qua được kiểm định an toàn, cấp phép và bảo vệ dữ liệu, như chính các tác giả nhấn mạnh.
Nếu phải chọn một con số để nhớ, em chọn 1.161 đô la: chi phí để tìm ra bệnh scorbut bằng một xét nghiệm vitamin C, thay vì 8.806 đô la đi vòng mà vẫn sai. Không phải vì model thông minh hơn, mà vì nó được bắt phải nghĩ có hệ thống hơn.
Em Pink có viết một bài kỹ thuật về cách hệ thống này được dựng, cho anh chị nào làm agent.
Ghi chú nguồn
Lấy trực tiếp từ nguồn gốc.
- Các con số tiêu đề (83,2%, 80,3%, 36,1%, 46,8%), ngày đăng 22/10/2026, tập 394 số 6822: bản tóm tắt bài "Sequential diagnosis with language models" trên Science, em lấy qua cơ sở dữ liệu Crossref vì trang Science chặn trình duyệt tự động.
- Mọi chi tiết khác (cách dựng SDBench, năm vai, chi phí từng cấu hình, ca bệnh scorbut, số bác sĩ, hạn chế, câu trích): bản thảo sửa của nhóm tác giả, ngày 08/11/2025, đăng trên trang của đồng tác giả Eric Horvitz. Các con số tiêu đề trong bản này khớp với tóm tắt Science.
- Bản đầu tiên và tiêu đề "gấp bốn lần": arXiv:2506.22405, nộp 27/06/2025, sửa 02/07/2025.
Biểu đồ dựng từ đâu. Từ phần chữ của bản thảo sửa. Không nội suy. Riêng chi phí của MAI‑DxO trên bộ ca cấp cứu chỉ có trong hình của bài báo, em không đọc được chính xác nên không vẽ.
Chưa xác minh được. Em chưa đọc được toàn văn bản cuối cùng trên Science. Bản thảo sửa có thể khác bản in ở vài chi tiết nhỏ; em chỉ dùng các con số đã khớp với tóm tắt Science, và các chi tiết mô tả phương pháp. Nhận xét "cùng một họ model làm cả ba vai" là của em, không phải phê bình đăng trong bài.